
机器学习之路:python 特征降维 特征筛选 feature_selection
特征提取:
    特征降维的手段
    抛弃对结果没有联系的特征
    抛弃对结果联系较少的特征
    以这种方式,降低维度

数据集的特征过多,有些对结果没有任何关系,
这个时候,将没有关系的特征删除,反而能获得更好的预测结果

下面使用决策树,预测泰坦尼克号幸存情况,
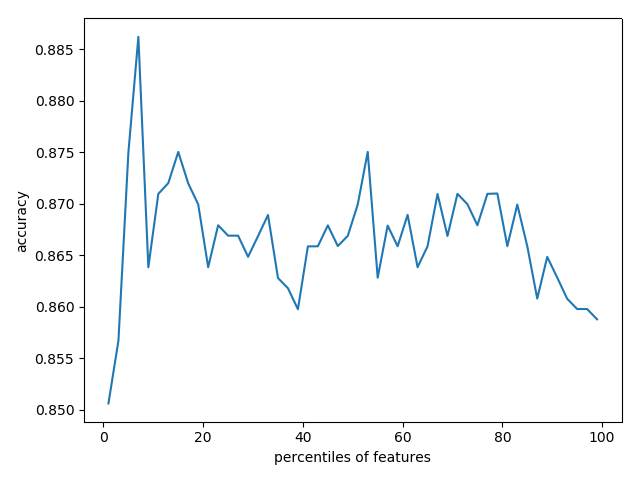
对不同百分比的筛选特征,进行学习和预测,比较准确率
python3学习使用api
使用到联网的数据集,我已经下载到本地,可以到我的git中下载数据集
git: https://github.com/linyi0604/MachineLearning
代码:
 import pandas as pd

 from sklearn.cross_validation import train_test_split

 from sklearn.feature_extraction import DictVectorizer

 from sklearn.tree import DecisionTreeClassifier

 from sklearn import feature_selection

 from sklearn.cross_validation import cross_val_score

 import numpy as np

 import pylab as pl

 '''

 特征提取:

     特征降维的手段

     抛弃对结果没有联系的特征

     抛弃对结果联系较少的特征

     以这种方式,降低维度

 数据集的特征过多,有些对结果没有任何关系,

 这个时候,将没有关系的特征删除,反而能获得更好的预测结果

 下面使用决策树,预测泰坦尼克号幸存情况,

 对不同百分比的筛选特征,进行学习和预测,比较准确率

 '''

 # 1 准备数据

 titanic = pd.read_csv("../data/titanic/titanic.txt")

 # 分离数据特征与目标

 y = titanic["survived"]

 x = titanic.drop(["row.names", "name", "survived"], axis=1)

 # 对缺失值进行补充

 x['age'].fillna(x['age'].mean(), inplace=True)

 x.fillna("UNKNOWN", inplace=True)

 # 2 分割数据集 25%用于测试 75%用于训练

 x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.25, random_state=33)

 # 3 类别型特征向量化

 vec = DictVectorizer()

 x_train = vec.fit_transform(x_train.to_dict(orient='record'))

 x_test = vec.transform(x_test.to_dict(orient='record'))

 # 输出处理后向量的维度

 # print(len(vec.feature_names_))  # 474

 # 4 使用决策树对所有特征进行学习和预测

 dt = DecisionTreeClassifier(criterion='entropy')

 dt.fit(x_train, y_train)

 print("全部维度的预测准确率:", dt.score(x_test, y_test))  # 0.8206686930091185

 # 5 筛选前20%的特征,使用相同配置的决策树模型进行评估性能

 fs = feature_selection.SelectPercentile(feature_selection.chi2, percentile=20)

 x_train_fs = fs.fit_transform(x_train, y_train)

 x_test_fs = fs.transform(x_test)

 dt.fit(x_train_fs, y_train)

 print("前20%特征的学习模型预测准确率:", dt.score(x_test_fs, y_test))     # 0.8237082066869301

 # 6 通过交叉验证 按照固定间隔百分比筛选特征, 展示性能情况

 percentiles = range(1, 100, 2)

 results = []

 for i in percentiles:

     fs = feature_selection.SelectPercentile(feature_selection.chi2, percentile=i)

     x_train_fs = fs.fit_transform(x_train, y_train)

     scores = cross_val_score(dt, x_train_fs, y_train, cv=5)

     results = np.append(results, scores.mean())

 # print(results)

 '''

 [0.85063904 0.85673057 0.87501546 0.88622964 0.86284271 0.86489384

  0.87303649 0.86689342 0.87098536 0.86690373 0.86895485 0.86083282

  0.86691404 0.86488353 0.86895485 0.86792414 0.86284271 0.86995465

  0.86486291 0.86385281 0.86384251 0.86894455 0.86794475 0.86690373

  0.86488353 0.86489384 0.86590394 0.87300557 0.86995465 0.86793445

  0.87097506 0.86998557 0.86692435 0.86892393 0.86997526 0.87098536

  0.87198516 0.86691404 0.86691404 0.87301587 0.87202639 0.8648423

  0.86386312 0.86388374 0.86794475 0.8618223  0.85877139 0.86285302

  0.86692435 0.8577819 ]

 '''

 # 找到最佳性能的筛选百分比

 opt = np.where(results == results.max())[0][0]

 print("最高性能的筛选百分比是:%s%%" % percentiles[opt])  #

 pl.plot(percentiles, results)

 pl.xlabel("特征筛选的百分比")

 pl.ylabel("准确率")

 pl.show()
生成的准确率图:
机器学习之路:python 特征降维 特征筛选 feature_selection的更多相关文章
- 机器学习之路: python 回归树 DecisionTreeRegressor 预测波士顿房价
python3 学习api的使用 git: https://github.com/linyi0604/MachineLearning 代码: from sklearn.datasets import ...
- 机器学习之路: python 线性回归LinearRegression, 随机参数回归SGDRegressor 预测波士顿房价
python3学习使用api 线性回归,和 随机参数回归 git: https://github.com/linyi0604/MachineLearning from sklearn.datasets ...
- 机器学习之路: python 决策树分类DecisionTreeClassifier 预测泰坦尼克号乘客是否幸存
使用python3 学习了决策树分类器的api 涉及到 特征的提取,数据类型保留,分类类型抽取出来新的类型 需要网上下载数据集,我把他们下载到了本地, 可以到我的git下载代码和数据集: https: ...
- 机器学习之路: python k近邻分类器 KNeighborsClassifier 鸢尾花分类预测
使用python语言 学习k近邻分类器的api 欢迎来到我的git查看源代码: https://github.com/linyi0604/MachineLearning from sklearn.da ...
- 机器学习之路--Python
常用数据结构 1.list 列表 有序集合 classmates = ['Michael', 'Bob', 'Tracy'] len(classmates) classmates[0] len(cla ...
- 什么是机器学习的特征工程?【数据集特征抽取(字典,文本TF-Idf)、特征预处理(标准化,归一化)、特征降维(低方差,相关系数,PCA)】
2.特征工程 2.1 数据集 2.1.1 可用数据集 Kaggle网址:https://www.kaggle.com/datasets UCI数据集网址: http://archive.ics.uci ...
- AI学习---特征工程【特征抽取、特征预处理、特征降维】
学习框架 特征工程(Feature Engineering) 数据和特征决定了机器学习的上限,而模型和算法只是逼近这个上限而已 什么是特征工程: 帮助我们使得算法性能更好发挥性能而已 sklearn主 ...
- 特征降维之PCA
目录 PCA思想 问题形式化表述 PCA之协方差矩阵 协方差定义 矩阵-特征值 PCA运算步骤 PCA理论解释 最大方差理论 性质 参数k的选取 数据重建 主观理解 应用 代码示例 PCA思想 PCA ...
- 如何用Python做自动化特征工程
机器学习的模型训练越来越自动化,但特征工程还是一个漫长的手动过程,依赖于专业的领域知识,直觉和数据处理.而特征选取恰恰是机器学习重要的先期步骤,虽然不如模型训练那样能产生直接可用的结果.本文作者将使用 ...
随机推荐
- Openflow Plugin学习笔记3
MDController.java 中的start方法,创建了SwitchConnectionHandlerImpl实例 SwitchConnectionHandlerImpl switchConne ...
- windebug分析高cpu问题
分析高CPU的关键是找到哪个线程是持续运行,占用CPU时间. 可以隔上两分钟连续抓两个dump文件,使用 !runaway 查看线程运行的时间 通过对比两个dump文件的线程时间,看看哪个线程运行的时 ...
- 10种CSS3实现的Loading效果
原文链接:http://www.cnblogs.com/jr1993/p/4622039.html 第一种效果: 代码如下: <div class="loading"> ...
- linux中set、unset、export、env、declare,readonly的区别以及用法
set命令显示当前shell的变量,包括当前用户的变量; env命令显示当前用户的变量; export命令显示当前导出成用户变量的shell变量. 每个shell有自己特有 ...
- 記一次undo問題
記一次undo問題 參考:http://www.linuxidc.com/Linux/2014-06/103780.htm ORA-00376: 無法於此時讀取檔案 3 ORA-01110: 資料檔 ...
- springcloud的Turbine配置监控多个服务的一些坑!!!!InstanceMonitor$MisconfiguredHostException,No message available","path":"/actuator/hystrix.stream,页面不显示服务或者一直loading
踩了几个小时坑,使用仪表盘监控单个服务的时候很容易,但是一到多个服务,瞬间坑就来了,大概碰到下面三个: 1InstanceMonitor$MisconfiguredHostException, No ...
- flask基础之app初始化(四)
前言 flask的核心对象是Flask,它定义了flask框架对于http请求的整个处理逻辑.随着服务器被启动,app被创建并初始化,那么具体的过程是这样的呢? 系列文章 flask基础之安装和使用入 ...
- 十分钟搞懂快速傅里叶变换(FFT)
己学习的笔记,欢迎大家指正.
- linux文件管理 -> 系统目录结构
几乎所有的计算机操作系统都是用目录结构组织文件.具体来说就是在一个目录中存放子目录和文件, 而在子目录中又会进一步存放子目录和文件,以此类推形成一个树状的文件结构,由于其结构很像一棵树的分支, 所以该 ...
- Python 正则表达式提高
re模块的高级用法 search re.search(pattern, string[, flags]) 若string中包含pattern子串,则返回Match对象,否则返回None,注意,如果 ...