
【原创】Kafka Consumer多线程实例续篇
在上一篇《Kafka Consumer多线程实例》中我们讨论了KafkaConsumer多线程的两种写法:多KafkaConsumer多线程以及单KafkaConsumer多线程。在第二种用法中我使用的是自动提交的方式,省去了多线程提交位移的麻烦。很多人跑来问如果是手动提交应该怎么写?由于KafkaConsumer不是线程安全的,因此我们不能简单地在多个线程中直接调用consumer.commitSync来提交位移。本文将给出一个实际的例子来模拟多线程消费以及手动提交位移。
本例中包含3个类:
- ConsumerThreadHandler类:consumer多线程的管理类,用于创建线程池以及为每个线程分配任务。另外consumer位移的提交也在这个类中进行
- ConsumerWorker类:本质上是一个Runnable,执行真正的消费逻辑并上报位移信息给ConsumerThreadHandler
- Main类:测试主方法类
测试代码
ConsumerWorker类
package huxi.test.consumer.multithreaded;

import org.apache.kafka.clients.consumer.ConsumerRecord;

import org.apache.kafka.clients.consumer.ConsumerRecords;

import org.apache.kafka.clients.consumer.OffsetAndMetadata;

import org.apache.kafka.common.TopicPartition;

import java.util.List;

import java.util.Map;

public class ConsumerWorker<K, V> implements Runnable {

    private final ConsumerRecords<K, V> records;

    private final Map<TopicPartition, OffsetAndMetadata> offsets;

    public ConsumerWorker(ConsumerRecords<K, V> record, Map<TopicPartition, OffsetAndMetadata> offsets) {

        this.records = record;

        this.offsets = offsets;

    }

    @Override

    public void run() {

        for (TopicPartition partition : records.partitions()) {

            List<ConsumerRecord<K, V>> partitionRecords = records.records(partition);

            for (ConsumerRecord<K, V> record : partitionRecords) {

                // 插入消息处理逻辑,本例只是打印消息

                System.out.println(String.format("topic=%s, partition=%d, offset=%d",

                        record.topic(), record.partition(), record.offset()));

            }

            // 上报位移信息

            long lastOffset = partitionRecords.get(partitionRecords.size() - 1).offset();

            synchronized (offsets) {

                if (!offsets.containsKey(partition)) {

                    offsets.put(partition, new OffsetAndMetadata(lastOffset + 1));

                } else {

                    long curr = offsets.get(partition).offset();

                    if (curr <= lastOffset + 1) {

                        offsets.put(partition, new OffsetAndMetadata(lastOffset + 1));

                    }

                }

            }

        }

    }

}
ConsumerThreadHandler类
package huxi.test.consumer.multithreaded;

import org.apache.kafka.clients.consumer.ConsumerRebalanceListener;

import org.apache.kafka.clients.consumer.ConsumerRecords;

import org.apache.kafka.clients.consumer.KafkaConsumer;

import org.apache.kafka.clients.consumer.OffsetAndMetadata;

import org.apache.kafka.common.TopicPartition;

import org.apache.kafka.common.errors.WakeupException;

import java.util.Arrays;

import java.util.Collection;

import java.util.Collections;

import java.util.HashMap;

import java.util.Map;

import java.util.Properties;

import java.util.concurrent.ArrayBlockingQueue;

import java.util.concurrent.ExecutorService;

import java.util.concurrent.ThreadPoolExecutor;

import java.util.concurrent.TimeUnit;

public class ConsumerThreadHandler<K, V> {

    private final KafkaConsumer<K, V> consumer;

    private ExecutorService executors;

    private final Map<TopicPartition, OffsetAndMetadata> offsets = new HashMap<>();

    public ConsumerThreadHandler(String brokerList, String groupId, String topic) {

        Properties props = new Properties();

        props.put("bootstrap.servers", brokerList);

        props.put("group.id", groupId);

        props.put("enable.auto.commit", "false");

        props.put("auto.offset.reset", "earliest");

        props.put("key.deserializer", "org.apache.kafka.common.serialization.ByteArrayDeserializer");

        props.put("value.deserializer", "org.apache.kafka.common.serialization.ByteArrayDeserializer");

        consumer = new KafkaConsumer<>(props);

        consumer.subscribe(Arrays.asList(topic), new ConsumerRebalanceListener() {

            @Override

            public void onPartitionsRevoked(Collection<TopicPartition> partitions) {

                consumer.commitSync(offsets);

            }

            @Override

            public void onPartitionsAssigned(Collection<TopicPartition> partitions) {

                offsets.clear();

            }

        });

    }

    /**

     * 消费主方法

     * @param threadNumber  线程池中线程数

     */

    public void consume(int threadNumber) {

        executors = new ThreadPoolExecutor(

                threadNumber,

                threadNumber,

                0L,

                TimeUnit.MILLISECONDS,

                new ArrayBlockingQueue<Runnable>(1000),

                new ThreadPoolExecutor.CallerRunsPolicy());

        try {

            while (true) {

                ConsumerRecords<K, V> records = consumer.poll(1000L);

                if (!records.isEmpty()) {

                    executors.submit(new ConsumerWorker<>(records, offsets));

                }

                commitOffsets();

            }

        } catch (WakeupException e) {

            // swallow this exception

        } finally {

            commitOffsets();

            consumer.close();

        }

    }

    private void commitOffsets() {

        // 尽量降低synchronized块对offsets锁定的时间

        Map<TopicPartition, OffsetAndMetadata> unmodfiedMap;

        synchronized (offsets) {

            if (offsets.isEmpty()) {

                return;

            }

            unmodfiedMap = Collections.unmodifiableMap(new HashMap<>(offsets));

            offsets.clear();

        }

        consumer.commitSync(unmodfiedMap);

    }

    public void close() {

        consumer.wakeup();

        executors.shutdown();

    }

}
Main类
package huxi.test.consumer.multithreaded;

public class Main {

    public static void main(String[] args) {

        String brokerList = "localhost:9092";

        String topic = "test-topic";

        String groupID = "test-group";

        final ConsumerThreadHandler<byte[], byte[]> handler = new ConsumerThreadHandler<>(brokerList, groupID, topic);

        final int cpuCount = Runtime.getRuntime().availableProcessors();

        Runnable runnable = new Runnable() {

            @Override

            public void run() {

                handler.consume(cpuCount);

            }

        };

        new Thread(runnable).start();

        try {

            // 20秒后自动停止该测试程序

            Thread.sleep(20000L);

        } catch (InterruptedException e) {

            // swallow this exception

        }

        System.out.println("Starting to close the consumer...");

        handler.close();

    }

}
测试步骤
1. 首先创建一个测试topic: test-topic,10个分区,并使用kafka-producer-perf-test.sh脚本生产50万条消息
2. 运行Main,假定group.id设置为test-group
3. 新开一个终端,不断地运行以下脚本监控consumer group的消费进度
bin/kafka-consumer-groups.sh --bootstrap-server localhost:9092 --describe --group test-group
测试结果
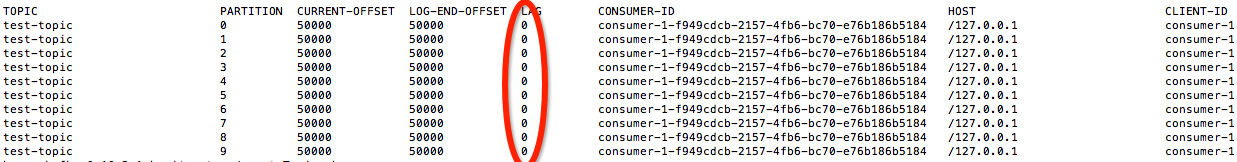
LAG列全部为0表示consumer group的位移提交正常。值得一提的是,各位可以通过控制consumer.poll的超时时间来控制ConsumerThreadHandler类提交位移的频率。
感谢QQ群友的提醒,这种方式有丢失数据的时间窗口——假设T1线程在t0时间消费分区0的位移=100的消息M1,而T2线程在t1时间消费分区0的位移=101的消息M2。现在假设t3时T2线程先完成处理,于是上报位移101给Handler,但此时T1线程尚未处理完成。t4时handler提交位移101,之后T1线程发生错误,抛出异常导致位移100的消息消费失败,但由于位移已经提交到101,故消息丢失~。
【原创】Kafka Consumer多线程实例续篇的更多相关文章
- 【原创】Kafka Consumer多线程实例
Kafka 0.9版本开始推出了Java版本的consumer,优化了coordinator的设计以及摆脱了对zookeeper的依赖.社区最近也在探讨正式用这套consumer API替换Scala ...
- kafka系列 -- 多线程消费者实现
看了一下kafka,然后写了消费Kafka数据的代码.感觉自己功力还是不够. 不能随心所欲地操作数据,数据结构没学好,spark的RDD操作没学好. 不能很好地组织代码结构,设计模式没学好,面向对象思 ...
- 【原创】kafka consumer源代码分析
顾名思义,就是kafka的consumer api包. 一.ConsumerConfig.scala Kafka consumer的配置类,除了一些默认值常量及验证参数的方法之外,就是consumer ...
- 【原创】美团二面:聊聊你对 Kafka Consumer 的架构设计
在上一篇中我们详细聊了关于 Kafka Producer 内部的底层原理设计思想和细节, 本篇我们主要来聊聊 Kafka Consumer 即消费者的内部底层原理设计思想. 1.Consumer之总体 ...
- kafka consumer assign 和 subscribe模式差异分析
转载请注明原创地址:http://www.cnblogs.com/dongxiao-yang/p/7200971.html 最近需要研究flink-connector-kafka的消费行为,发现fli ...
- Kafka设计解析(四)- Kafka Consumer设计解析
本文转发自Jason’s Blog,原文链接 http://www.jasongj.com/2015/08/09/KafkaColumn4 摘要 本文主要介绍了Kafka High Level Con ...
- 读Kafka Consumer源码
最近一直在关注阿里的一个开源项目:OpenMessaging OpenMessaging, which includes the establishment of industry guideline ...
- kafka consumer 配置详解
1.Consumer Group 与 topic 订阅 每个Consumer 进程都会划归到一个逻辑的Consumer Group中,逻辑的订阅者是Consumer Group.所以一条message ...
- [Big Data - Kafka] Kafka设计解析(四):Kafka Consumer解析
High Level Consumer 很多时候,客户程序只是希望从Kafka读取数据,不太关心消息offset的处理.同时也希望提供一些语义,例如同一条消息只被某一个Consumer消费(单播)或被 ...
随机推荐
- redis的主从复制
一.主从复制概述 二.主从复制的过程:
- Kafka学习-Producer和Customer
在上一篇kafka入门的基础之上,本篇主要介绍Kafka的生产者和消费者. Kafka 生产者 kafka Producer发布消息记录到Kakfa集群.生产者是线程安全的,可以在多个线程之间共享生产 ...
- 域名系统DNS和FTP
域名系统概述 域名系统DNS(Domain Name System)是英特网使用的命名系统,用于把便于人们使用机器名字转化为IP地址. 为什么机器在处理IP数据报时要使用IP地址而不使用域名呢?IP地 ...
- Unity非运行模式下实现动画播放/回退工具
实现效果 核心功能 支持选定模型(带Animator)在非运行模式下,播放/暂停/停止动作. 支持动作单帧前进,单帧回退(帧时间默认0.05f,可以代码设置). 支持滚动条拖拽,将动作调整到指定时间. ...
- Tensorflow实践:CNN实现MNIST手写识别模型
前言 本文假设大家对CNN.softmax原理已经比较熟悉,着重点在于使用Tensorflow对CNN的简单实践上.所以不会对算法进行详细介绍,主要针对代码中所使用的一些函数定义与用法进行解释,并给出 ...
- Ubuntu设置终端相对短路径
这个设置相对实际上是比较简单的.在自己的家目录打开.bashrc 找到PS1='${debian_chroot:+($debian_chroot)}\u@\h:\w\$' 只需要将w修改为大写W保存, ...
- java虚拟机学习-JVM调优总结(5)
数据类型 Java虚拟机中,数据类型可以分为两类:基本类型和引用类型.基本类型的变量保存原始值,即:他代表的值就是数值本身:而引用类型的变量保存引用值.“引用值”代表了某个对象的引用,而不是对象本身, ...
- 模拟实现简化版List迭代器&嵌入List
1.迭代器(iterators)概念(1)迭代器是一种抽象的设计概念,其定义为:提供一种方法,使他能够按顺序遍历某个聚合体(容器)所包含的所有元素,但又不需要暴露该容器的内部表现方式. (2)迭代器是 ...
- 阿里云 Centos7.3安装mysql5.7.18 rpm安装
卸载MariaDB CentOS7默认安装MariaDB而不是MySQL,而且yum服务器上也移除了MySQL相关的软件包.因为MariaDB和MySQL可能会冲突,故先卸载MariaDB. 1.安装 ...
- 如何在office2007中插入MathType教学
很多人在安装MathType数学公式编辑器时可能会遇到这个问题,MathType安装好了,可是在office2007的菜单栏中没有MathType这个选项卡,也就是说MathType没有成功加载在of ...