
【Python】Scrapy基础
一、Scrapy 架构
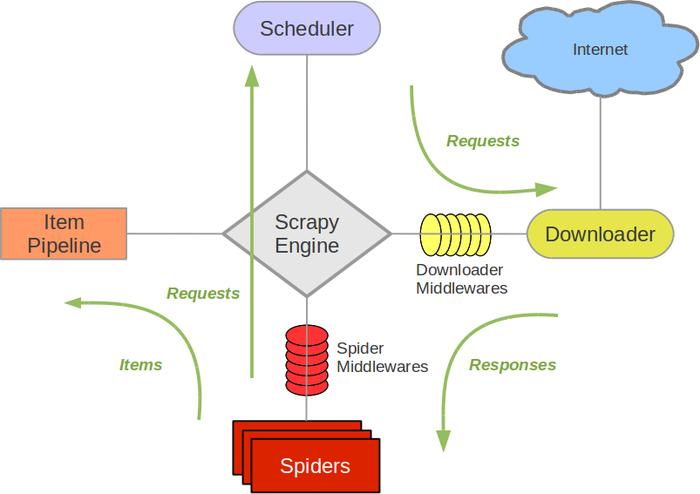
- Engine(引擎):负责 Spider(爬虫)、Item Pipeline(管道)、Downloader(下载器)、Scheduler(调度器)中的通讯和数据传递。
- Scheduler:接受 Engine 发送过来的 Request 请求,按照一定方式入队,再交给 Downloader 下载。可实现去重。Scheduler 的请求队列为空时,程序才会终止。
- Downloader:下载 Engine 发送(中间通过Scheduler)的所有 Requests 请求,并将其获取到的 Responses 交还给 Engine,由 Engine 交给 Spider 处理。
- Spider:处理所有 Responses ①提取 Item 字段需要的数据,交给 Pipeline 存储 ②将需要跟进的 URL 提交给 Engine,再进入 Scheduler。
- Item Pipeline:负责处理 Spider 提取到的 Item,并进行后期处理,例如分析过滤数据,按自己定制的格式保存到 json、数据库等。
- Downloader Middlewares:自定义扩展下载功能,例如给每个 Request 加代理、User-Agent 等。
- Spider Middlewares:自定义扩展 Engine 和 Spider 中间的通信,例如进入 Spider 的 Responses、从 Spider 出去的Requests。用处不大,大部分爬虫功能在 Spider 里实现。
二、Scrapy 安装
1、Windows
- pip install scrapy
2、Linux
- 安装非 python 依赖:sudo apt-get install python-dev python-pip libxml2-dev libxslt1-dev zlib1g-dev libffi-dev libssl-dev
- sudo pip install scrapy
三、官方文档
四、
【Python】Scrapy基础的更多相关文章
- python scrapy 基础
scrapy是用python写的一个库,使用它可以方便的抓取网页. 主页地址http://scrapy.org/ 文档 http://doc.scrapy.org/en/latest/index.ht ...
- 0.Python 爬虫之Scrapy入门实践指南(Scrapy基础知识)
目录 0.0.Scrapy基础 0.1.Scrapy 框架图 0.2.Scrapy主要包括了以下组件: 0.3.Scrapy简单示例如下: 0.4.Scrapy运行流程如下: 0.5.还有什么? 0. ...
- python scrapy 抓取脚本之家文章(scrapy 入门使用简介)
老早之前就听说过python的scrapy.这是一个分布式爬虫的框架,可以让你轻松写出高性能的分布式异步爬虫.使用框架的最大好处当然就是不同重复造轮子了,因为有很多东西框架当中都有了,直接拿过来使用就 ...
- Python——Scrapy初学
Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架.可以应用在包括数据挖掘,信息处理或存储历史数据等一系列的程序中.Scrapy最初是为了页面抓取(更确切来说, 网络抓取)所设计的,也 ...
- python scrapy版 极客学院爬虫V2
python scrapy版 极客学院爬虫V2 1 基本技术 使用scrapy 2 这个爬虫的难点是 Request中的headers和cookies 尝试过好多次才成功(模拟登录),否则只能抓免费课 ...
- python Scrapy安装和介绍
python Scrapy安装和介绍 Windows7下安装1.执行easy_install Scrapy Centos6.5下安装 1.库文件安装yum install libxslt-devel ...
- Python.Scrapy.14-scrapy-source-code-analysis-part-4
Scrapy 源代码分析系列-4 scrapy.commands 子包 子包scrapy.commands定义了在命令scrapy中使用的子命令(subcommand): bench, check, ...
- Python.Scrapy.11-scrapy-source-code-analysis-part-1
Scrapy 源代码分析系列-1 spider, spidermanager, crawler, cmdline, command 分析的源代码版本是0.24.6, url: https://gith ...
- Python文件基础
===========Python文件基础========= 写,先写在了IO buffer了,所以要及时保存 关闭.关闭会自动保存. file.close() 读取全部文件内容用read,读取一行用 ...
- python scrapy cannot import name xmlrpc_client的解决方案,解决办法
安装scrapy的时候遇到如下错误的解决办法: "python scrapy cannot import name xmlrpc_client" 先执行 sudo pip unin ...
随机推荐
- 浅谈USB驱动架构 转载
去年,老师让我分析基于HD3系统芯片的WindowsCE USB驱动的可行性.USB驱动非常庞大,多个软件层次相互交错,以及各种协议,USB系统对于一般人很难理解,我对其也只是理解一个大概,下面,我对 ...
- cookie和sission的原理及异同
Cookie Cookie是存储在客户机的文本文件,它们保存了大量轨迹信息.在servlet技术基础上,JSP显然能够提供对HTTP cookie的支持. 通常有三个步骤来识别回头客: 服务器脚本发送 ...
- Verify_Execute 验证SQL语句执行结果
#region Verify_Execute /// <summary> /// 验证insert.update.delete执行 /// </summary> /// < ...
- vue获得当前页面URL动态拼接URL复制邀请链接方法
vue获得当前页面URL动态拼接URL复制邀请链接方法 当前页面完整url可以用 location.href路由路径可以用 this.$route.path路由路径参数 this.$route.par ...
- toggle,hasClass
toggle 但当toggle(),不带参数时,与show()和hide()的作用一样,切换元素的可见状态,如果元素是可见的,则切换为隐藏状态;如果元素是隐藏的则切换为可见状态,此时括号内可添加()毫 ...
- textfield reload issue and other things reload problem.===================================
https://github.com/flutter/flutter/issues/18828 https://blog.csdn.net/u011272795/article/details/830 ...
- showDialog 必须Stateful
showDialog 必须Stateful 因为需要context
- Linux 启动时profile、bashrc、~/.bash_profile、~/.bashrc、~/.bash_profile执行顺序以及文件说明
Linux 启动时profile.bashrc.~/.bash_profile.~/.bashrc.~/.bash_profile执行顺序以及文件说明 一.执行顺序 登录linux时,/etc/pro ...
- 谷歌浏览器导出excel失败问题解决(网上都没解决)
java poi导出excel报了网络错误,信息已经写回到chrome浏览器(IE/FF均无此问题).如下所示: 从chrome的network大小部分也可以看出是正确的. 网上很多答案说将file. ...
- 算法(第四版)C# 习题题解——1.5
写在前面 整个项目都托管在了 Github 上:https://github.com/ikesnowy/Algorithms-4th-Edition-in-Csharp 这一节内容可能会用到的库文件有 ...