
Sqoop Import HDFS
Sqoop import应用场景——密码访问
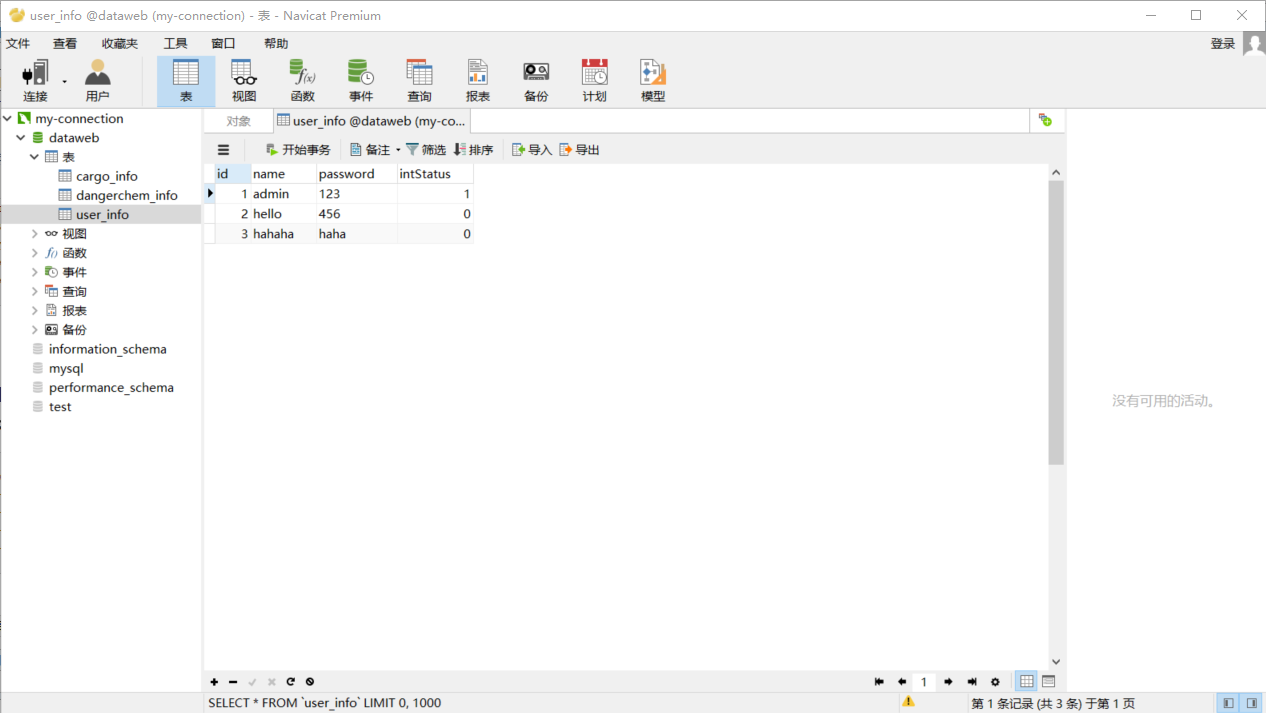
注:测试用表为本地数据库中的表
1.明码访问
sqoop list-databases \

 --connect jdbc:mysql://202.193.60.117/dataweb \

 --username root \

 --password
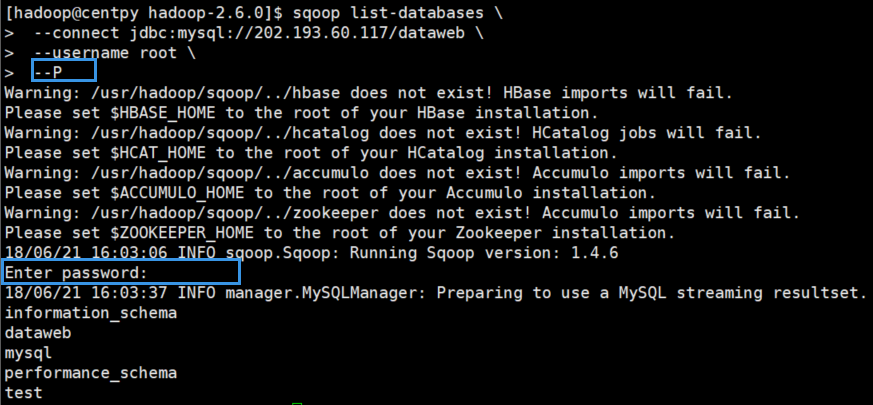
2.交互式密码
sqoop list-databases \
--connect jdbc:mysql://202.193.60.117/dataweb \

 --username root \

 --P
3.文件授权密码
sqoop list-databases \

 --connect jdbc:mysql://202.193.60.117/dataweb \

 --username root \

 --password-file /usr/hadoop/.password
在运行之前先要在指定路径下创建.password文件。
[hadoop@centpy ~]$ cd /usr/hadoop/

[hadoop@centpy hadoop]$ ls

flume  hadoop-2.6.  sqoop

[hadoop@centpy hadoop]$ echo -n "20134997" > .password

[hadoop@centpy hadoop]$ ls -a

.  ..  flume  hadoop-2.6.  .password  sqoop

[hadoop@centpy hadoop]$ more .password

[hadoop@centpy hadoop]$ chmod 400 .password //根据官方文档说明赋予400权限
测试运行之后一定会报以下错误:
// :: WARN tool.BaseSqoopTool: Failed to load password file

java.io.IOException: The provided password file /usr/hadoop/.password does not exist!

    at org.apache.sqoop.util.password.FilePasswordLoader.verifyPath(FilePasswordLoader.java:)

    at org.apache.sqoop.util.password.FilePasswordLoader.loadPassword(FilePasswordLoader.java:)

    at org.apache.sqoop.util.CredentialsUtil.fetchPasswordFromLoader(CredentialsUtil.java:)

    at org.apache.sqoop.util.CredentialsUtil.fetchPassword(CredentialsUtil.java:)

    at org.apache.sqoop.tool.BaseSqoopTool.applyCredentialsOptions(BaseSqoopTool.java:)

    at org.apache.sqoop.tool.BaseSqoopTool.applyCommonOptions(BaseSqoopTool.java:)

    at org.apache.sqoop.tool.ListDatabasesTool.applyOptions(ListDatabasesTool.java:)

    at org.apache.sqoop.tool.SqoopTool.parseArguments(SqoopTool.java:)

    at org.apache.sqoop.Sqoop.run(Sqoop.java:)

    at org.apache.hadoop.util.ToolRunner.run(ToolRunner.java:)

    at org.apache.sqoop.Sqoop.runSqoop(Sqoop.java:)

    at org.apache.sqoop.Sqoop.runTool(Sqoop.java:)

    at org.apache.sqoop.Sqoop.runTool(Sqoop.java:)

    at org.apache.sqoop.Sqoop.main(Sqoop.java:)

Error while loading password file: The provided password file /usr/hadoop/.password does not exist!
为了解决该错误,我们需要将.password文件放到HDFS上面去,这样就能找到该文件了。
[hadoop@centpy hadoop]$ hdfs dfs -ls /

Found  items

drwxr-xr-x   - Zimo   supergroup           -- : /actor

drwxr-xr-x   - Zimo   supergroup           -- : /counter

drwxr-xr-x   - hadoop supergroup           -- : /flume

drwxr-xr-x   - hadoop hadoop               -- : /hdfsOutput

drwxr-xr-x   - Zimo   supergroup           -- : /join

drwxr-xr-x   - hadoop supergroup           -- : /maven

drwxr-xr-x   - Zimo   supergroup           -- : /mergeSmallFiles

drwxrwxrwx   - hadoop supergroup           -- : /phone

drwxr-xr-x   - hadoop hadoop               -- : /test

drwx------   - hadoop hadoop               -- : /tmp

drwxr-xr-x   - hadoop hadoop               -- : /weather

drwxr-xr-x   - hadoop hadoop               -- : /weibo

[hadoop@centpy hadoop]$ hdfs dfs -mkdir -p /user/hadoop

[hadoop@centpy hadoop]$ hdfs dfs -put .password /user/hadoop

[hadoop@centpy hadoop]$ hdfs dfs -chmod 400 /user/hadoop/.password
现在测试运行一下,注意路径改为HDFS上的/user/hadoop。
[hadoop@centpy hadoop-2.6.]$ sqoop list-databases  --connect jdbc:mysql://202.193.60.117/dataweb  --username root  --password-file /user/hadoop/.password

Warning: /usr/hadoop/sqoop/../hbase does not exist! HBase imports will fail.

Please set $HBASE_HOME to the root of your HBase installation.

Warning: /usr/hadoop/sqoop/../hcatalog does not exist! HCatalog jobs will fail.

Please set $HCAT_HOME to the root of your HCatalog installation.

Warning: /usr/hadoop/sqoop/../accumulo does not exist! Accumulo imports will fail.

Please set $ACCUMULO_HOME to the root of your Accumulo installation.

Warning: /usr/hadoop/sqoop/../zookeeper does not exist! Accumulo imports will fail.

Please set $ZOOKEEPER_HOME to the root of your Zookeeper installation.

// :: INFO sqoop.Sqoop: Running Sqoop version: 1.4.

// :: INFO manager.MySQLManager: Preparing to use a MySQL streaming resultset.

information_schema

dataweb

mysql

performance_schema

test
可以看到成功了。
Sqoop import应用场景——导入全表
1.不指定目录
sqoop import \

 --connect jdbc:mysql://202.193.60.117/dataweb \

 --username root \

 --password-file /user/hadoop/.password \
 --table user_info
运行过程如下
// :: INFO client.RMProxy: Connecting to ResourceManager at /0.0.0.0:

// :: INFO db.DBInputFormat: Using read commited transaction isolation

// :: INFO db.DataDrivenDBInputFormat: BoundingValsQuery: SELECT MIN(`id`), MAX(`id`) FROM `user_info`

// :: INFO mapreduce.JobSubmitter: number of splits:

// :: INFO mapreduce.JobSubmitter: Submitting tokens for job: job_1529567189245_0001

// :: INFO impl.YarnClientImpl: Submitted application application_1529567189245_0001

// :: INFO mapreduce.Job: The url to track the job: http://centpy:8088/proxy/application_1529567189245_0001/

// :: INFO mapreduce.Job: Running job: job_1529567189245_0001

// :: INFO mapreduce.Job: Job job_1529567189245_0001 running in uber mode : false

// :: INFO mapreduce.Job:  map % reduce %

// :: INFO mapreduce.Job:  map % reduce %

// :: INFO mapreduce.Job:  map % reduce %

// :: INFO mapreduce.Job:  map % reduce %

// :: INFO mapreduce.Job: Job job_1529567189245_0001 completed successfully

// :: INFO mapreduce.Job: Counters:

    File System Counters

        FILE: Number of bytes read=

        FILE: Number of bytes written=

        FILE: Number of read operations=

        FILE: Number of large read operations=

        FILE: Number of write operations=

        HDFS: Number of bytes read=

        HDFS: Number of bytes written=

        HDFS: Number of read operations=

        HDFS: Number of large read operations=

        HDFS: Number of write operations=

    Job Counters

        Launched map tasks=

        Other local map tasks=

        Total time spent by all maps in occupied slots (ms)=

        Total time spent by all reduces in occupied slots (ms)=

        Total time spent by all map tasks (ms)=

        Total vcore-seconds taken by all map tasks=

        Total megabyte-seconds taken by all map tasks=

    Map-Reduce Framework

        Map input records=

        Map output records=

        Input split bytes=

        Spilled Records=

        Failed Shuffles=

        Merged Map outputs=

        GC time elapsed (ms)=

        CPU time spent (ms)=

        Physical memory (bytes) snapshot=

        Virtual memory (bytes) snapshot=

        Total committed heap usage (bytes)=

    File Input Format Counters

        Bytes Read=

    File Output Format Counters

        Bytes Written=

// :: INFO mapreduce.ImportJobBase: Transferred  bytes in 54.3141 seconds (0.8101 bytes/sec)

// :: INFO mapreduce.ImportJobBase: Retrieved  records.
再查看一下HDFS下的运行结果

[hadoop@centpy hadoop-2.6.]$ hdfs dfs -cat /user/hadoop/user_info/part-m-*

,admin,,

,hello,,

,hahaha,haha,
运行结果和数据库内容匹配。
以上就是博主为大家介绍的这一板块的主要内容,这都是博主自己的学习过程,希望能给大家带来一定的指导作用,有用的还望大家点个支持,如果对你没用也望包涵,有错误烦请指出。如有期待可关注博主以第一时间获取更新哦,谢谢!
Sqoop Import HDFS的更多相关文章
- (MySQL里的数据)通过Sqoop Import HDFS 里 和 通过Sqoop Export HDFS 里的数据到(MySQL)(五)
下面我们结合 HDFS,介绍 Sqoop 从关系型数据库的导入和导出 一.MySQL里的数据通过Sqoop import HDFS 它的功能是将数据从关系型数据库导入 HDFS 中,其流程图如下所示. ...
- Sqoop Export HDFS
Sqoop Export应用场景——直接导出 直接导出 我们先复制一个表,然后将上一篇博文(Sqoop Import HDFS)导入的数据再导出到我们所复制的表里. sqoop export \ -- ...
- (MySQL里的数据)通过Sqoop Import Hive 里 和 通过Sqoop Export Hive 里的数据到(MySQL)
Sqoop 可以与Hive系统结合,实现数据的导入和导出,用户需要在 sqoop-env.sh 中添加HIVE_HOME的环境变量. 具体,见我的如下博客: hadoop2.6.0(单节点)下Sqoo ...
- (MySQL里的数据)通过Sqoop Import HBase 里 和 通过Sqoop Export HBase 里的数据到(MySQL)
Sqoop 可以与HBase系统结合,实现数据的导入和导出,用户需要在 sqoop-env.sh 中添加HBASE_HOME的环境变量. 具体,见我的如下博客: hadoop2.6.0(单节点)下Sq ...
- Hive学习之七《 Sqoop import 从关系数据库抽取到HDFS》
一.什么是sqoop Sqoop是一款开源的工具,主要用于在Hadoop(Hive)与传统的数据库(mysql.postgresql...)间进行数据的传递,可以将一个关系型数据库(例如 :MySQL ...
- MSBI BigData demo—sqoop import
--sp_readerrorlog 读取错误的信息记录 exec sys.sp_readerrorlog 0, 1, 'listening'查看端口号 首先hadoop环境要配置完毕,并检验可以正常启 ...
- Hadoop生态组件Hive,Sqoop安装及Sqoop从HDFS/hive抽取数据到关系型数据库Mysql
一般Hive依赖关系型数据库Mysql,故先安装Mysql $: yum install mysql-server mysql-client [yum安装] $: /etc/init.d/mysqld ...
- 通过sqoop将hdfs数据导入MySQL
简介:Sqoop是一款开源的工具,主要用于在Hadoop(Hive)与传统的数据库(mysql.postgresql...)间进行数据的传递,可以将一个关系型数据库(例如 : MySQL ,Oracl ...
- 使用sqoop往hdfs中导入数据供hive使用
sqoop import -fs hdfs://x.x.x.x:8020 -jt local --connect "jdbc:oracle:thin:@x.x.x.x:1521:testdb ...
随机推荐
- IPC的使用
IPC,Inter-Processor Communication是SYS/BIOS处理核间通信的组件: IPC的几种应用方式: 1.最小使用(Minimal use) 这种情况是通过核间的通知机制( ...
- 在浏览器中输入url并回车后发生了什么?
1 解析url url主要由以下几个部分组成: 1 传输协议 2 服务器 3 域名 4 端口 5 虚拟目录 6 文件名 7 锚 8 参数 2 DNS(域名)解析 找到域名对应的ip 3 浏览器与网站建 ...
- 对象流demo1----
对象流demo1: package com.etc.test; import java.io.BufferedInputStream; import java.io.BufferedOutputStr ...
- 10个C语言经典
1.计算Fibonacci数列Fibonacci数列又称斐波那契数列,又称黄金分割数列,指的是这样一个数列:1.1.2.3.5.8.13.21.C语言实现的代码如下: /* t3ing Fibonac ...
- 把Nutch爬虫部署到Hadoop集群上
原文地址:http://cn.soulmachine.me/blog/20140204/ 把Nutch爬虫部署到Hadoop集群上 Feb 4th, 2014 | Comments 软件版本:Nutc ...
- R: 关于 table 函数的应用
################################################### 问题:关于 table 函数 18.5.9 来一个关于 table 函数的例子,说明tabl ...
- 1、linux-wget
1.常用下载与参数 wget + 空格 + 要下载文件的url路径 例如: # wget linuxsense.org/xxxx/xxx.tar.gz">http://www.linu ...
- SRAtoolkit软件的使用介绍
Using the SRA Toolkit to convert .sra files into other formats Sequence Read Archive Submissions Sta ...
- 让开发更简单 —— Coding Enterprise 发布
今天,我们很高兴地宣布 Coding Enterprise 发布了 —— Coding Enterprise 是 CODING 专为企业打造的软件开发协作平台,提供了针对中小型企业的公有云版本和针对大 ...
- 实验楼Linux基础入门第一周
&&使用oschina的git服务器 1.创建了项目 https://git.oschina.net/abc99/wyq20169314 2.配置项目 (1)为项目添加公钥 项目管理- ...