
9、共享变量(Broadcast Variable和Accumulator)
一、共享变量
1、共享变量工作原理
Spark一个非常重要的特性就是共享变量。

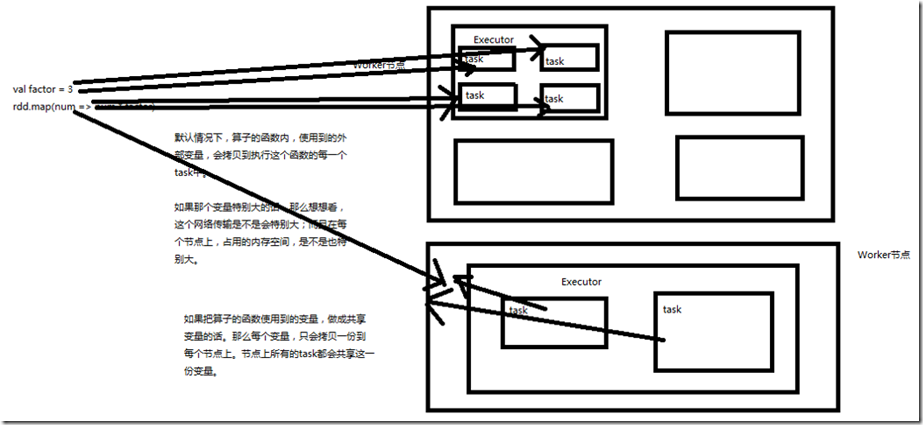
默认情况下,如果在一个算子的函数中使用到了某个外部的变量,那么这个变量的值会被拷贝到每个task中。此时每个task只能操作自己的那份变量副本。如果多个task想

要共享某个变量,那么这种方式是做不到的。

Spark为此提供了两种共享变量,一种是Broadcast Variable(广播变量),另一种是Accumulator(累加变量)。Broadcast Variable会将使用到的变量,仅仅为每个节点拷贝
一份,更大的用处是优化性能,减少网络传输以及内存消耗。Accumulator则可以让多个task共同操作一份变量,主要可以进行累加操作。
2、Broadcast Variable
Spark提供的Broadcast Variable,是只读的。并且在每个节点上只会有一份副本,而不会为每个task都拷贝一份副本。因此其最大作用,就是减少变量到各个节点的网络传

输消耗,以及在各个节点上的内存消耗。此外,spark自己内部也使用了高效的广播算法来减少网络消耗。

可以通过调用SparkContext的broadcast()方法,来针对某个变量创建广播变量。然后在算子的函数内,使用到广播变量时,每个节点只会拷贝一份副本了。每个节点可以使

用广播变量的value()方法获取值。记住,广播变量,是只读的。

------java实现------

package cn.spark.study.core;

import java.util.Arrays;

import java.util.List;

import org.apache.spark.SparkConf;

import org.apache.spark.api.java.JavaRDD;

import org.apache.spark.api.java.JavaSparkContext;

import org.apache.spark.api.java.function.Function;

import org.apache.spark.api.java.function.VoidFunction;

import org.apache.spark.broadcast.Broadcast;

/**

 * 广播变量

 * @author bcqf

 *

 */

public class BroadcastVariable {

    public static void main(String[] args) {

        SparkConf conf = new SparkConf().setAppName("BroadcastVariable").setMaster("local");

        JavaSparkContext sc = new JavaSparkContext(conf);

        // 在java中,创建共享变量,就是调用SparkContext的broadcast()方法

        // 获取的返回结果是Broadcast<T>类型

        final int factor = 3;

        final Broadcast<Integer> factorBroadcast = sc.broadcast(factor);

        List<Integer> numberList = Arrays.asList(1,2,3,4,5);

        JavaRDD<Integer> numbers = sc.parallelize(numberList);

        //让集合中的每个数字,都乘以外部定义的那个factor

        JavaRDD<Integer> multipleNumbers = numbers.map(new Function<Integer, Integer>() {

            private static final long serialVersionUID = 1L;

            @Override

            public Integer call(Integer v1) throws Exception {

                // 使用共享变量时,调用其value()方法,即可获取其内部封装的值

                int factor = factorBroadcast.value();

                return v1 * factor;

            }

        });

        multipleNumbers.foreach(new VoidFunction<Integer>() {

            private static final long serialVersionUID = 1L;

            @Override

            public void call(Integer t) throws Exception {

                System.out.println(t);

            }

        });

        sc.close();

    }

}

//结果
3
6
9
12
15
--------scala实现--------

package cn.spark.study.core

import org.apache.spark.SparkConf

import org.apache.spark.SparkContext

object BroadcastVariable {

  def main(args: Array[String]) {

    val conf = new SparkConf().setAppName("BroadcastVariable").setMaster("local")

    val sc = new SparkContext(conf)

    val factor = 3;

    val factorBroadcast = sc.broadcast(factor)

    val numberArray = Array(1,2,3,4,5)

    val numbers = sc.parallelize(numberArray, 1)

    val multipleNumbers = numbers.map { num => num * factorBroadcast.value}

    multipleNumbers.foreach { num => println(num)}

  }

}
3、Accumulator
Spark提供的Accumulator,主要用于多个节点对一个变量进行共享性的操作。Accumulator只提供了累加的功能。但是确给我们提供了多个task对一个变量并行操作的功能。

但是task只能对Accumulator进行累加操作,不能读取它的值。只有Driver程序可以读取Accumulator的值。

------java实现-------

package cn.spark.study.core;

import java.util.Arrays;

import java.util.List;

import org.apache.spark.Accumulator;

import org.apache.spark.SparkConf;

import org.apache.spark.api.java.JavaRDD;

import org.apache.spark.api.java.JavaSparkContext;

import org.apache.spark.api.java.function.VoidFunction;

public class AccumulatorVariable {

    public static void main(String[] args) {

        SparkConf conf = new SparkConf().setAppName("Accumulator").setMaster("local");

        JavaSparkContext sc = new JavaSparkContext(conf);

        // 创建Accumulator变量

        // 需要调用SparkContext的accumulator()方法

        final Accumulator<Integer> sum = sc.accumulator(0);

        List<Integer> numberList = Arrays.asList(1,2,3,4,5);

        JavaRDD<Integer> numbers = sc.parallelize(numberList);

        numbers.foreach(new VoidFunction<Integer>() {

            private static final long serialVersionUID = 1L;

            @Override

            public void call(Integer t) throws Exception {

                // 然后在函数内部,就可以对Accumulator变量,调用add()方法,累加值

                sum.add(t);

            }

        });

        // 在driver程序中,可以调用Accumulator的value()方法,获取其值

        System.out.println(sum.value());

        sc.close();

    }

}

//结果
15

--------scala实现---------

package cn.spark.study.core

import org.apache.spark.SparkConf

import org.apache.spark.SparkContext

object AccumulatorVariable {

  def main(args: Array[String]) {

    val conf = new SparkConf().setAppName("AccumulatorVariable").setMaster("local")

    val sc = new SparkContext(conf)

    val sum = sc.accumulator(0)

    val numberArray = Array(1,2,3,4,5)

    val numbers = sc.parallelize(numberArray, 1)

    numbers.foreach {num => sum += num }

    println(sum)

  }

}
9、共享变量(Broadcast Variable和Accumulator)的更多相关文章
- 08、共享变量(Broadcast Variable和Accumulator)
共享变量工作原理 Spark一个非常重要的特性就是共享变量. 默认情况下,如果在一个算子的函数中使用到了某个外部的变量,那么这个变量的值会被拷贝到每个task中.此时每个task只能操作自己的那份 ...
- Spark2.x(六十二):(Spark2.4)共享变量 - Broadcast原理分析
之前对Broadcast有分析,但是不够深入<Spark2.3(四十三):Spark Broadcast总结>,本章对其实现过程以及原理进行分析. 带着以下几个问题去写本篇文章: 1)dr ...
- (升级版)Spark从入门到精通(Scala编程、案例实战、高级特性、Spark内核源码剖析、Hadoop高端)
本课程主要讲解目前大数据领域最热门.最火爆.最有前景的技术——Spark.在本课程中,会从浅入深,基于大量案例实战,深度剖析和讲解Spark,并且会包含完全从企业真实复杂业务需求中抽取出的案例实战.课 ...
- spark 学习路线及参考课程
一.Scala编程详解: 第1讲-Spark的前世今生 第2讲-课程介绍.特色与价值 第3讲-Scala编程详解:基础语法 第4讲-Scala编程详解:条件控制与循环 第5讲-Scala编程详解:函数 ...
- Spark踩坑记——共享变量
[TOC] 前言 Spark踩坑记--初试 Spark踩坑记--数据库(Hbase+Mysql) Spark踩坑记--Spark Streaming+kafka应用及调优 在前面总结的几篇spark踩 ...
- Spark分布式编程之全局变量专题【共享变量】
转载自:http://www.aboutyun.com/thread-19652-1-1.html 问题导读 1.spark共享变量的作用是什么?2.什么情况下使用共享变量?3.如何在程序中使用共享变 ...
- Spark共享变量(广播变量、累加器)
转载自:https://blog.csdn.net/Android_xue/article/details/79780463 Spark两种共享变量:广播变量(broadcast variable)与 ...
- Spark踩坑记:共享变量
收录待用,修改转载已取得腾讯云授权 前言 前面总结的几篇spark踩坑博文中,我总结了自己在使用spark过程当中踩过的一些坑和经验.我们知道Spark是多机器集群部署的,分为Driver/Maste ...
- 常用Actoin算子 与 内存管理 、共享变量、内存机制
一.常用Actoin算子 (reduce .collect .count .take .saveAsTextFile . countByKey .foreach ) collect:从集群中将所有的计 ...
随机推荐
- postgres 序列
postgres序列(serial)和类型:https://www.cnblogs.com/alianbog/p/5654604.html 序列:https://www.cnblogs.com/mch ...
- iOS - 外加字体(只需三步-教你轻松实现)
外加字体 1.首先info.plist中加入属性Fonts provided by application,在item 0 处填写导入的ttf文件名 eg: <key>UIAppFonts ...
- img中alt和title属性的区别
在图像标签img中,除了常用的宽度width和高度height属性之外,还有两个比较重要并且也会用到的属性,就是alt和title,这都是用来显示图片内容的具体信息的,但是这两个属性也有不同的地方.a ...
- 9.如何让一个div 上下左右居中?【CS
方法1:[绝对定位50%-本身50%] position:absolute; left:50%; top:50%; transform: tra ...
- Selenium文件上传
转自:https://www.cnblogs.com/miaojjblog/p/9679915.html Web上本地上传图片,弹出的框Selenium是无法识别的,也就是说,selenium本身没有 ...
- docker 安装及使用介绍
docker 安装及使用用介绍 安装docker所依赖的基础环境 1 64 bits CPU 2 Linux Kernel 3.10+ //如果低于则需要手动给内核打补丁.因为分层构建联合挂载系统得在 ...
- CPN tools 帮助文档资料和实例
1.替代变迁 包含有替代变迁的页面叫做父页,当CPN网使用替代变迁的时候,替代变迁所表达的逻辑必须在某一个位置得到实现,实现替代变迁逻辑页面叫做子页或者子网. 将替代变迁相邻的库所叫做槽库所,也即是在 ...
- 网卡启动安装dell服务器OS
参照视频 需要将boot改成bois启动 https://www.dell.com/support/contents/cn/zh/cndhs1/videos/videoPlayer/k1ajZzdjo ...
- React系列,jsx
<script type="text/babel"> var name = "kimoo"; var fn = ()=> "kimo ...
- 【转】spring 自定义注解(annotation)与 aop获取注解
首先我们先介绍Java自定义注解. 在开发过程中,我们实现接口的时候,会出现@Override,有时还会提示写@SuppressWarnings.其实这个就是Java特有的特性,注解. 注解就是某种注 ...