
Kafka数据辅助和Failover
数据辅助与Failover
CAP理论(它具有一致性、可用性、分区容忍性)
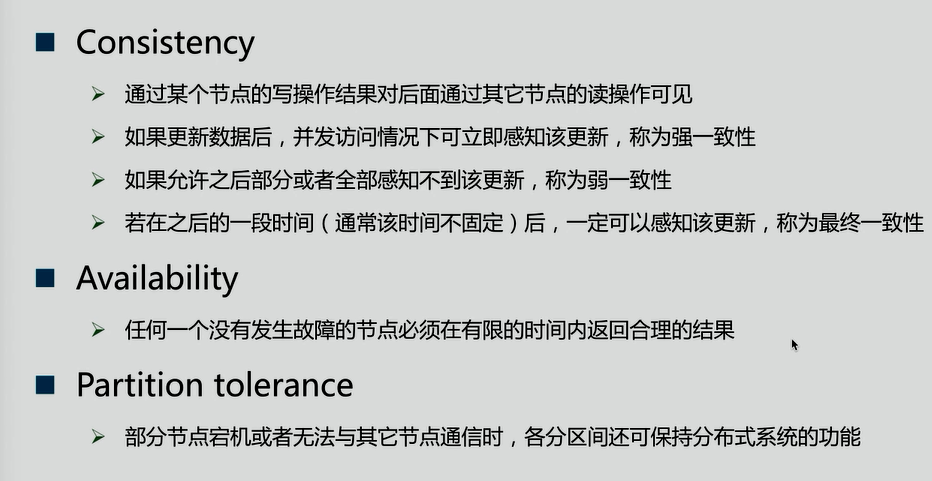
CAP理论:分布式系统中,一致性、可用性、分区容忍性最多只可同时满足两个。一般分区容忍性都要求有保障,因此很多时候在可用性与一致性之间做权衡。
一致性方案
1.Master-slave
》RDBMS的读写分离即为典型的Master-slave方案
》同步复制可保证强一致性但会影响可用性(等master确保将数据复制给全部的slave,slave才返回结果)
》异步复制可提供高可用性但会降低一致性
2.WNR
》主要用于去中心化(P2P)的分布式系统,DynameDB与Cassandra即采用此方案
》N代表副本数,W代表每次写操作要保证的最少写成功的副本数,R代表每次读至少读取的副本数
》当W+R>N时,可保证每次读取的数据至少有一个副本具有最新的更新
》多个写操作的顺序难以保证,可能导致多副本间的写操作顺序不一致,Dynamo通过向量时钟保证最终一致性
3.Paxos及其变种
》Google的Chubby,Zookeeper的Zab,RAFT等
Kafka是如何权衡CA的呢?
Replica
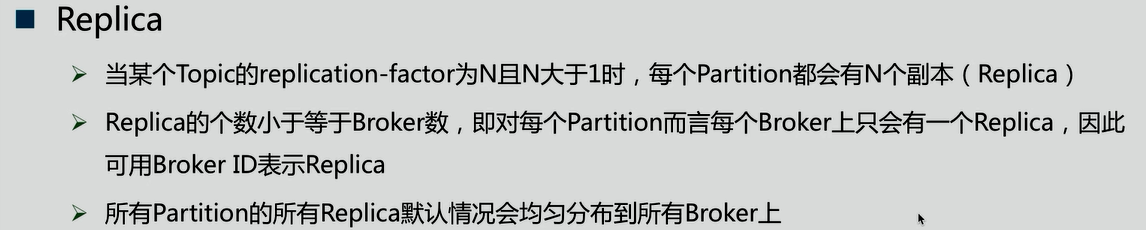
如:
当一个Patiton副本数超过Broker时,就会报错
Data Replication要解决的问题
1.如何Propagate(扩散)消息
2.何时Commit
3.如何处理Replica恢复
4.如何处理Replica全部宕机
1.如何Propagate(扩散)消息
以写入数据为例,Patiton分为leader和follower,follower周期性的向leader pull数据(和consumer相似)。
在读取数据时,与数据库读写分离不一样,follower并不参与读取操作,读取只和leader有关。
为了提高性能,每个Follower在接收到数据后就立马向Leader发送ACK,而非等到数据写入Log中。因此,对于已经commit的消息,Kafka只能保证它被存于多个Replica的内存中,而不能保证它们被持久化到磁盘中,也就不能完全保证异常发生后该条消息一定能被Consumer消费。但考虑到这种场景非常少见,可以认为这种方式在性能和数据持久化上做了一个比较好的平衡。在将来的版本中,Kafka会考虑提供更高的持久性。
2.何时Commit
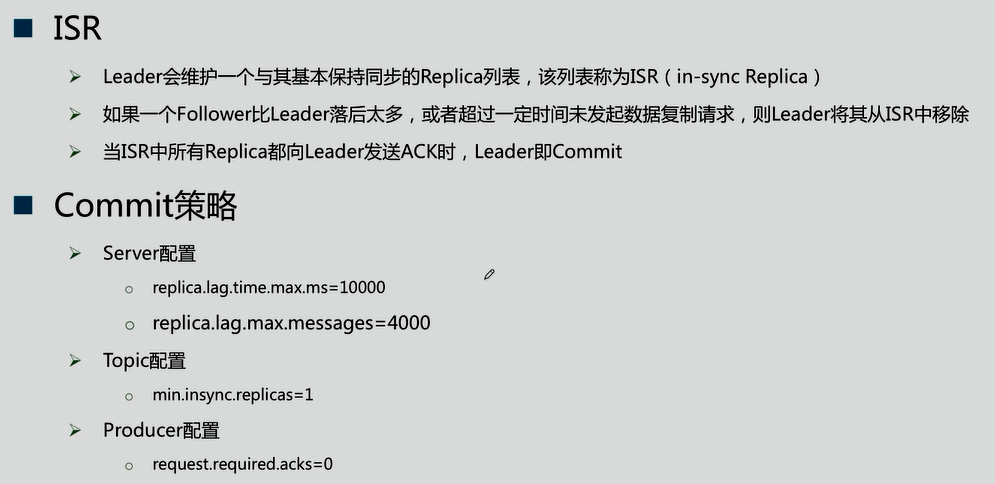
由上图可知,leader数据发送给follower既不是同步通信也不是异步通信,而是在一致性和可用性做了动态的平衡
3.如何处理Replica恢复
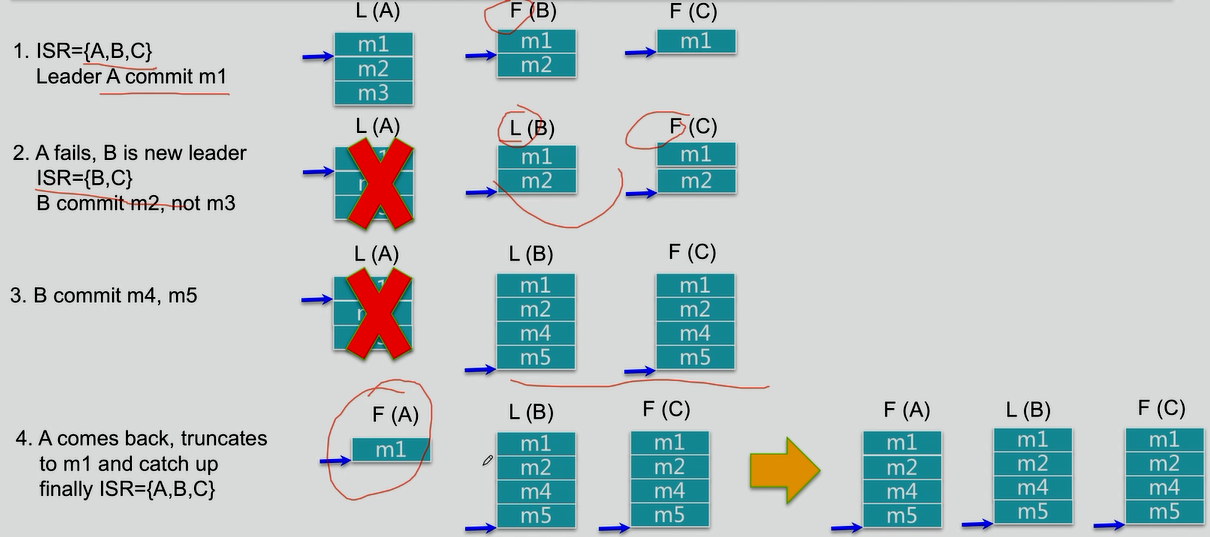
4.如何处理Replica全部宕机
等待ISR中任一Replica恢复,并选它为Leader
》等待时间较长,降低可用性
》或ISR中的所有Replica都无法恢复或者数据丢失,则该Patition将永不可用
选择第一个恢复的Replica为新的Leader,无论它是否在ISR中
》可能会有数据丢失
》可用性较高
Kafka数据辅助和Failover的更多相关文章
- kafka数据祸福和failover
k CAP帽子理论. consistency:一致性 Availability:可用性 partition tolerance:分区容忍型 CA :mysql oracle(抛弃了网络分区) CP:h ...
- Gobblin采集kafka数据
作者:Syn良子 出处:http://www.cnblogs.com/cssdongl 转载请注明出处 找时间记录一下利用Gobblin采集kafka数据的过程,话不多说,进入正题 一.Gobblin ...
- java spark-streaming接收TCP/Kafka数据
本文将展示 1.如何使用spark-streaming接入TCP数据并进行过滤: 2.如何使用spark-streaming接入TCP数据并进行wordcount: 内容如下: 1.使用maven,先 ...
- Flink消费Kafka数据并把实时计算的结果导入到Redis
1. 完成的场景 在很多大数据场景下,要求数据形成数据流的形式进行计算和存储.上篇博客介绍了Flink消费Kafka数据实现Wordcount计算,这篇博客需要完成的是将实时计算的结果写到redis. ...
- 工具篇-Spark-Streaming获取kafka数据的两种方式(转载)
转载自:https://blog.csdn.net/weixin_41615494/article/details/7952173 一.基于Receiver的方式 原理 Receiver从Kafka中 ...
- spark streaming从指定offset处消费Kafka数据
spark streaming从指定offset处消费Kafka数据 -- : 770人阅读 评论() 收藏 举报 分类: spark() 原文地址:http://blog.csdn.net/high ...
- Spark Streaming接收Kafka数据存储到Hbase
Spark Streaming接收Kafka数据存储到Hbase fly spark hbase kafka 主要参考了这篇文章https://yq.aliyun.com/articles/60712 ...
- flume 读取kafka 数据
本文介绍flume读取kafka数据的方法 代码: /************************************************************************* ...
- Kafka数据安全性、运行原理、存储
直接贴面试题: 怎么保证数据 kafka 里的数据安全? 答: 生产者数据的不丢失kafka 的 ack 机制: 在 kafka 发送数据的时候,每次发送消息都会有一个确认反馈机制,确保消息正常的能够 ...
随机推荐
- Co. - Apple - Apple ID
有些应用或游戏,在国内 App Store 没上架或者被下架了,但是其他国家或地区(如美国.香港和台湾等)的 App Store 却提供下载,这时我们需要登陆一个相应地区的 Apple ID 才可以下 ...
- 使用Win32DiskImager后重置SD卡
再1.Windows diskpart命令 diskpart 2.列出所有的磁盘 lisk disk 3.选择U盘所在的磁盘 4.清除磁盘 clean 5.创建主分区 create primary p ...
- laravel 基础 --内置函数
简介 Laravel 自带了一系列 PHP 辅助函数,很多被框架自身使用,如果你觉得方便的话也可以在代码中使用它们. https://laravelacademy.org/post/8967.html ...
- hive自定义函数(UDF)
首先什么是UDF,UDF的全称为user-defined function,用户定义函数,为什么有它的存在呢?有的时候 你要写的查询无法轻松地使用Hive提供的内置函数来表示,通过写UDF,Hive就 ...
- SpringMVC+Mybatis框架搭建
一.新建javaweb项目,并建好相应的包结构 二.添加项目jar到lib目录下 三.在config包中新建配置文件 sping-mvc.xml,内容如下: <?xml version=&quo ...
- 学习photoshop心得
简要的学习了ps的三大功能p图,抠图,作图, p图主要是学了换脸这一效果,用到套索工具,把范冰冰的脸接到郭德纲身上, 首先使用套索工具把脸圈起来 然后移动到 另一个人脸上 再然后混合图层,自动混合 差 ...
- python,函数式编程
函数式编程: 特点:允许传递的参数是函数,且允许返回一个函数. 由于Python允许使用变量,因此,Python不是纯函数式编程语言,同样的输入可能输出不同,有副作用.纯函数式编程语言没有变量,输入和 ...
- torndb在python3中运用
#连接数据库:db = torndb.Connect() #查询一条的数据get() #查询多行的数据query() #创建数据表,数据库execute() #插入一条数据:sql = "i ...
- IOException: win32 io returned 267. Path:
unity3d在导出android项目时出现了这个错误,找了一圈也没找到原因,最后把项目名中空格去掉后OK了,坑啊!!!!
- cachel-control
nodejs: res.set('Cache-Control', 'public, max-age=31557600'); express全局设置: app.use(express.sta ...