
详解Apache Hudi如何配置各种类型分区
1. 引入
Apache Hudi支持多种分区方式数据集,如多级分区、单分区、时间日期分区、无分区数据集等,用户可根据实际需求选择合适的分区方式,下面来详细了解Hudi如何配置何种类型分区。
2. 分区处理
为说明Hudi对不同分区类型的处理,假定写入Hudi的Schema如下
{

  "type" : "record",

  "name" : "HudiSchemaDemo",

  "namespace" : "hoodie.HudiSchemaDemo",

  "fields" : [ {

    "name" : "age",

    "type" : [ "long", "null" ]

  }, {

    "name" : "location",

    "type" : [ "string", "null" ]

  }, {

    "name" : "name",

    "type" : [ "string", "null" ]

  }, {

    "name" : "sex",

    "type" : [ "string", "null" ]

  }, {

    "name" : "ts",

    "type" : [ "long", "null" ]

  }, {

    "name" : "date",

    "type" : [ "string", "null" ]

  } ]

}
其中一条具体数据如下
{

  "name": "zhangsan",

  "ts": 1574297893837,

  "age": 16,

  "location": "beijing",

  "sex":"male",

  "date":"2020/08/16"

}
2.1 单分区
单分区表示使用一个字段表示作为分区字段的场景,可具体分为非日期格式字段(如location)和日期格式字段(如date)
2.1.1 非日期格式字段分区
如使用上述location字段做为分区字段,在写入Hudi并同步至Hive时配置如下
df.write().format("org.apache.hudi").

                options(getQuickstartWriteConfigs()).

                option(DataSourceWriteOptions.TABLE_TYPE_OPT_KEY(), "COPY_ON_WRITE").

                option(DataSourceWriteOptions.PRECOMBINE_FIELD_OPT_KEY(), "ts").

                option(DataSourceWriteOptions.RECORDKEY_FIELD_OPT_KEY(), "name").

                option(DataSourceWriteOptions.PARTITIONPATH_FIELD_OPT_KEY(), partitionFields).

                option(DataSourceWriteOptions.KEYGENERATOR_CLASS_OPT_KEY(), keyGenerator).

                option(TABLE_NAME, tableName).

                option("hoodie.datasource.hive_sync.enable", true).

                option("hoodie.datasource.hive_sync.table", tableName).

                option("hoodie.datasource.hive_sync.username", "root").

                option("hoodie.datasource.hive_sync.password", "123456").

                option("hoodie.datasource.hive_sync.jdbcurl", "jdbc:hive2://localhost:10000").

                option("hoodie.datasource.hive_sync.partition_fields", hivePartitionFields).

                option("hoodie.datasource.write.table.type", "COPY_ON_WRITE").

                option("hoodie.embed.timeline.server", false).

                option("hoodie.datasource.hive_sync.partition_extractor_class", hivePartitionExtractorClass).

                mode(saveMode).

                save(basePath);
值得注意如下几个配置项
DataSourceWriteOptions.PARTITIONPATH_FIELD_OPT_KEY()配置为location;hoodie.datasource.hive_sync.partition_fields配置为location,与写入Hudi的分区字段相同;DataSourceWriteOptions.KEYGENERATOR_CLASS_OPT_KEY()配置为org.apache.hudi.keygen.SimpleKeyGenerator,或者不配置该选项,默认为org.apache.hudi.keygen.SimpleKeyGenerator;hoodie.datasource.hive_sync.partition_extractor_class配置为org.apache.hudi.hive.MultiPartKeysValueExtractor;
Hudi同步到Hive创建的表如下
CREATE EXTERNAL TABLE `notdateformatsinglepartitiondemo`(

  `_hoodie_commit_time` string,

  `_hoodie_commit_seqno` string,

  `_hoodie_record_key` string,

  `_hoodie_partition_path` string,

  `_hoodie_file_name` string,

  `age` bigint,

  `date` string,

  `name` string,

  `sex` string,

  `ts` bigint)

PARTITIONED BY (

  `location` string)

ROW FORMAT SERDE

  'org.apache.hadoop.hive.ql.io.parquet.serde.ParquetHiveSerDe'

STORED AS INPUTFORMAT

  'org.apache.hudi.hadoop.HoodieParquetInputFormat'

OUTPUTFORMAT

  'org.apache.hadoop.hive.ql.io.parquet.MapredParquetOutputFormat'

LOCATION

  'file:/tmp/hudi-partitions/notDateFormatSinglePartitionDemo'

TBLPROPERTIES (

  'last_commit_time_sync'='20200816154250',

  'transient_lastDdlTime'='1597563780')
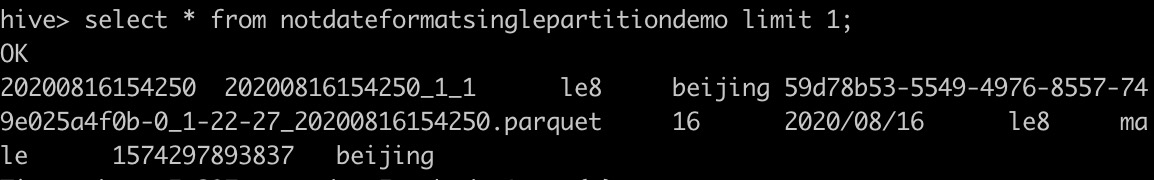
查询表notdateformatsinglepartitiondemo
tips: 查询时请先将hudi-hive-sync-bundle-xxx.jar包放入$HIVE_HOME/lib下
2.1.2 日期格式分区
如使用上述date字段做为分区字段,核心配置项如下
DataSourceWriteOptions.PARTITIONPATH_FIELD_OPT_KEY()配置为date;hoodie.datasource.hive_sync.partition_fields配置为date,与写入Hudi的分区字段相同;DataSourceWriteOptions.KEYGENERATOR_CLASS_OPT_KEY()配置为org.apache.hudi.keygen.SimpleKeyGenerator,或者不配置该选项,默认为org.apache.hudi.keygen.SimpleKeyGenerator;hoodie.datasource.hive_sync.partition_extractor_class配置为org.apache.hudi.hive.SlashEncodedDayPartitionValueExtractor;
Hudi同步到Hive创建的表如下
CREATE EXTERNAL TABLE `dateformatsinglepartitiondemo`(

  `_hoodie_commit_time` string,

  `_hoodie_commit_seqno` string,

  `_hoodie_record_key` string,

  `_hoodie_partition_path` string,

  `_hoodie_file_name` string,

  `age` bigint,

  `location` string,

  `name` string,

  `sex` string,

  `ts` bigint)

PARTITIONED BY (

  `date` string)

ROW FORMAT SERDE

  'org.apache.hadoop.hive.ql.io.parquet.serde.ParquetHiveSerDe'

STORED AS INPUTFORMAT

  'org.apache.hudi.hadoop.HoodieParquetInputFormat'

OUTPUTFORMAT

  'org.apache.hadoop.hive.ql.io.parquet.MapredParquetOutputFormat'

LOCATION

  'file:/tmp/hudi-partitions/dateFormatSinglePartitionDemo'

TBLPROPERTIES (

  'last_commit_time_sync'='20200816155107',

  'transient_lastDdlTime'='1597564276')
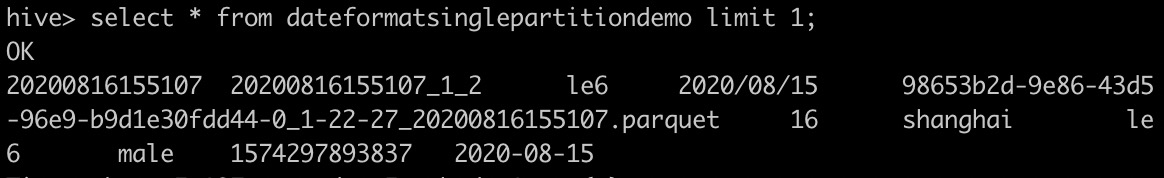
查询表dateformatsinglepartitiondemo
2.2 多分区
多分区表示使用多个字段表示作为分区字段的场景,如上述使用location字段和sex字段,核心配置项如下
DataSourceWriteOptions.PARTITIONPATH_FIELD_OPT_KEY()配置为location,sex;hoodie.datasource.hive_sync.partition_fields配置为location,sex,与写入Hudi的分区字段相同;DataSourceWriteOptions.KEYGENERATOR_CLASS_OPT_KEY()配置为org.apache.hudi.keygen.ComplexKeyGenerator;hoodie.datasource.hive_sync.partition_extractor_class配置为org.apache.hudi.hive.MultiPartKeysValueExtractor;
Hudi同步到Hive创建的表如下
CREATE EXTERNAL TABLE `multipartitiondemo`(

  `_hoodie_commit_time` string,

  `_hoodie_commit_seqno` string,

  `_hoodie_record_key` string,

  `_hoodie_partition_path` string,

  `_hoodie_file_name` string,

  `age` bigint,

  `date` string,

  `name` string,

  `ts` bigint)

PARTITIONED BY (

  `location` string,

  `sex` string)

ROW FORMAT SERDE

  'org.apache.hadoop.hive.ql.io.parquet.serde.ParquetHiveSerDe'

STORED AS INPUTFORMAT

  'org.apache.hudi.hadoop.HoodieParquetInputFormat'

OUTPUTFORMAT

  'org.apache.hadoop.hive.ql.io.parquet.MapredParquetOutputFormat'

LOCATION

  'file:/tmp/hudi-partitions/multiPartitionDemo'

TBLPROPERTIES (

  'last_commit_time_sync'='20200816160557',

  'transient_lastDdlTime'='1597565166')
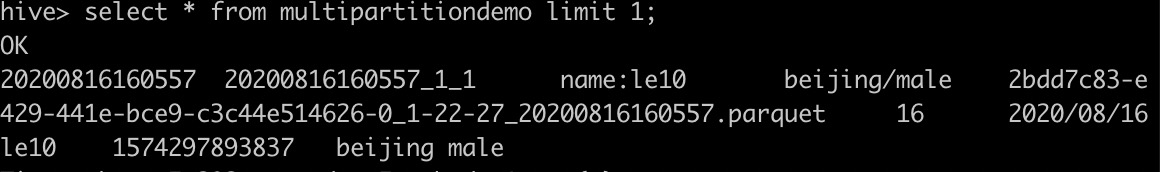
查询表multipartitiondemo
2.3 无分区
无分区场景是指无分区字段,写入Hudi的数据集无分区。核心配置如下
DataSourceWriteOptions.PARTITIONPATH_FIELD_OPT_KEY()配置为空字符串;hoodie.datasource.hive_sync.partition_fields配置为空字符串,与写入Hudi的分区字段相同;DataSourceWriteOptions.KEYGENERATOR_CLASS_OPT_KEY()配置为org.apache.hudi.keygen.NonpartitionedKeyGenerator;hoodie.datasource.hive_sync.partition_extractor_class配置为org.apache.hudi.hive.NonPartitionedExtractor;
Hudi同步到Hive创建的表如下
CREATE EXTERNAL TABLE `nonpartitiondemo`(

  `_hoodie_commit_time` string,

  `_hoodie_commit_seqno` string,

  `_hoodie_record_key` string,

  `_hoodie_partition_path` string,

  `_hoodie_file_name` string,

  `age` bigint,

  `date` string,

  `location` string,

  `name` string,

  `sex` string,

  `ts` bigint)

ROW FORMAT SERDE

  'org.apache.hadoop.hive.ql.io.parquet.serde.ParquetHiveSerDe'

STORED AS INPUTFORMAT

  'org.apache.hudi.hadoop.HoodieParquetInputFormat'

OUTPUTFORMAT

  'org.apache.hadoop.hive.ql.io.parquet.MapredParquetOutputFormat'

LOCATION

  'file:/tmp/hudi-partitions/nonPartitionDemo'

TBLPROPERTIES (

  'last_commit_time_sync'='20200816161558',

  'transient_lastDdlTime'='1597565767')
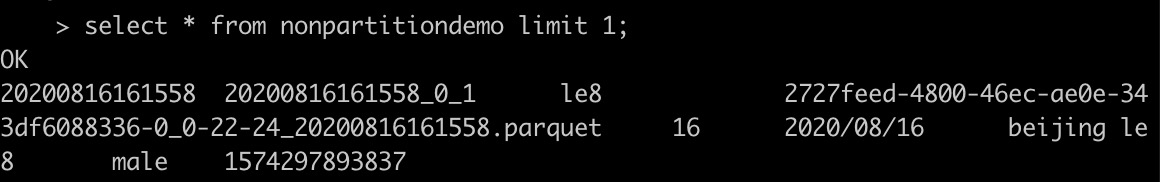
查询表nonpartitiondemo
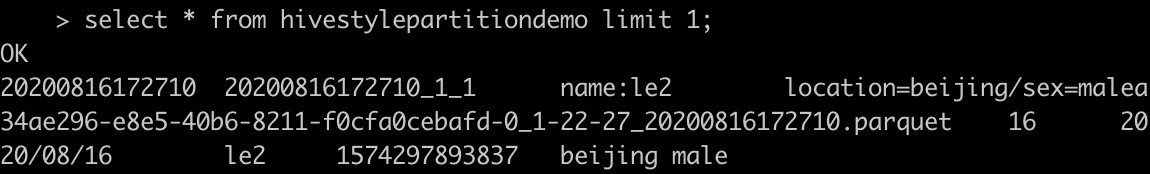
2.4 Hive风格分区
除了上述几种常见的分区方式,还有一种Hive风格分区格式,如location=beijing/sex=male格式,以location,sex作为分区字段,核心配置如下
DataSourceWriteOptions.PARTITIONPATH_FIELD_OPT_KEY()配置为location,sex;hoodie.datasource.hive_sync.partition_fields配置为location,sex,与写入Hudi的分区字段相同;DataSourceWriteOptions.KEYGENERATOR_CLASS_OPT_KEY()配置为org.apache.hudi.keygen.ComplexKeyGenerator;hoodie.datasource.hive_sync.partition_extractor_class配置为org.apache.hudi.hive.SlashEncodedDayPartitionValueExtractor;DataSourceWriteOptions.HIVE_STYLE_PARTITIONING_OPT_KEY()配置为true;
生成的Hudi数据集目录结构会为如下格式
/location=beijing/sex=male
Hudi同步到Hive创建的表如下
CREATE EXTERNAL TABLE `hivestylepartitiondemo`(

  `_hoodie_commit_time` string,

  `_hoodie_commit_seqno` string,

  `_hoodie_record_key` string,

  `_hoodie_partition_path` string,

  `_hoodie_file_name` string,

  `age` bigint,

  `date` string,

  `name` string,

  `ts` bigint)

PARTITIONED BY (

  `location` string,

  `sex` string)

ROW FORMAT SERDE

  'org.apache.hadoop.hive.ql.io.parquet.serde.ParquetHiveSerDe'

STORED AS INPUTFORMAT

  'org.apache.hudi.hadoop.HoodieParquetInputFormat'

OUTPUTFORMAT

  'org.apache.hadoop.hive.ql.io.parquet.MapredParquetOutputFormat'

LOCATION

  'file:/tmp/hudi-partitions/hiveStylePartitionDemo'

TBLPROPERTIES (

  'last_commit_time_sync'='20200816172710',

  'transient_lastDdlTime'='1597570039')
查询表hivestylepartitiondemo
3. 总结
本篇文章介绍了Hudi如何处理不同分区场景,上述配置的分区类配置可以满足绝大多数场景,当然Hudi非常灵活,还支持自定义分区解析器,具体可查看KeyGenerator和PartitionValueExtractor类,其中所有写入Hudi的分区字段生成器都是KeyGenerator的子类,所有同步至Hive的分区值解析器都是PartitionValueExtractor的子类。上述示例代码都已经上传至https://github.com/leesf/hudi-demos,该仓库会持续补充各种使用Hudi的Demo,方便开发者快速了解Hudi,构建企业级数据湖,欢迎star & fork。
详解Apache Hudi如何配置各种类型分区的更多相关文章
- 详解 Apache Hudi Schema Evolution(模式演进)
Schema Evolution(模式演进)允许用户轻松更改 Hudi 表的当前模式,以适应随时间变化的数据. 从 0.11.0 版本开始,支持 Spark SQL(spark3.1.x 和 spar ...
- 【转】 详解Kafka生产者Producer配置
粘贴一下这个配置,与我自己的程序做对比,看看能不能完善我的异步带代码: ----------------------------------------- 详解Kafka生产者Produce ...
- ubuntu apache2配置详解(含虚拟主机配置方法)
ubuntu apache2配置详解(含虚拟主机配置方法) 在Windows下,Apache的配置文件通常只有一个,就是httpd.conf.但我在Ubuntu Linux上用apt-get inst ...
- 使用IDEA详解Spring中依赖注入的类型(上)
使用IDEA详解Spring中依赖注入的类型(上) 在Spring中实现IoC容器的方法是依赖注入,依赖注入的作用是在使用Spring框架创建对象时动态地将其所依赖的对象(例如属性值)注入Bean组件 ...
- Ubuntu19.04的安装过程详解以及操作系统初始化配置
Ubuntu19.04的安装过程详解以及操作系统初始化配置 ...
- Spring、Spring事务详解;使用XML配置事务
@Transactional可以设置以下参数: @Transactional(readOnly=false) // 指定事务是否只读的 true/false @Transactional(rollba ...
- NUint使用详解及Visual Studio配置
NUint使用详解及Visual Studio配置 阅读目录 什么是单元测试? 为什么使用单元测试? NUint使用详解: 示例 属性 断言 简单测试 VS配置: External Tools Vis ...
- c# 把一个匿名对象赋值给一个Object类型的变量后,怎么取这个变量? c# dynamic动态类型和匿名类 详解C# 匿名对象(匿名类型)、var、动态类型 dynamic 深入浅析C#中的var和dynamic
比如有一个匿名对象,var result =......Select( a=>new { id=a.id, name=a.name});然后Object obj = result ;我怎 ...
- SpringBoot27 JDK动态代理详解、获取指定的类类型、动态注册Bean、接口调用框架
1 JDK动态代理详解 静态代理.JDK动态代理.Cglib动态代理的简单实现方式和区别请参见我的另外一篇博文. 1.1 JDK代理的基本步骤 >通过实现InvocationHandler接口来 ...
随机推荐
- FaaS 给前端带来了什么?
一.Serverless 与 FaaS Serverless 是一种云计算理念,即无服务器计算(Serverless Computing): Serverless suggests that the ...
- H5移动端,ios从后台返回到app,页面会白一下
visibilitychange事件可以检查从后台返回事件,然后通过添加div,强制浏览器刷新页面 var divEle = document.createElement("DIV" ...
- 惠普EX920强打760P驱动后无法开机,无法启动系统。
Windows10 1909与Intel 760P驱动版本不匹配的原因,造成了强打驱动后,无法启动系统的原因. 惠普EX920强打Intel 760P驱动教程:http://tieba.baidu.c ...
- 前端学习(六):body标签(四)
进击のpython ***** 前端学习--body标签 关于前面的都是大部分的标签内容 但是就像衣服一样,除了要有,还要放到适当的位置 我们先来看看一下网页的布局: 就可以看出来,网页都是一块一块的 ...
- C#中子类对基类方法的继承、重写和隐藏
提起子类.基类和方法继承这些概念,肯定大家都非常熟悉.毕竟,作为一门支持OOP的语言,掌握子类.基类是学习C#的基础.不过,这些概念虽然简单,但是也有一些初学者可能会遇到的坑,我们一起看看吧. 子 ...
- Python环境那点儿事(Windows篇)
Python环境配置那点儿事(Windows篇) 版本选择 (根据你的开发经验选择合适版) 适当版2.7 适当版3.6 适当版3.7 下载链接:python.org 安装 正规的Windows10操作 ...
- pv绑定pvc
创建pvapiVersion: v1kind: PersistentVolumemetadata: name: pv003 labels: app: vnc003 namespace: vnc-spa ...
- PHP array_diff_uassoc() 函数
实例 比较两个数组的键名和键值(使用用户自定义函数比较键名),并返回差集: <?phpfunction myfunction($a,$b){if ($a===$b){return 0;}retu ...
- PHP curl_strerror函数
(PHP 5 >= 5.5.0) curl_strerror — 返回错误码的描述. 说明 string curl_strerror ( int $errornum ) 返回错误码的文本描述信息 ...
- PHP strnatcasecmp() 函数
实例 使用"自然"算法来比较两个字符串(不区分大小写): <?php高佣联盟 www.cgewang.comecho strnatcasecmp("2Hello w ...