
CS224--1:语言模型和词向量
参考:
https://www.cnblogs.com/pinard/p/7243513.html
https://blog.csdn.net/cindy_1102/article/details/88079703
http://web.stanford.edu/class/cs224n/readings/cs224n-2019-notes01-wordvecs1.pdf
1、NLP简介
1.1、什么是自然语言?
用来表示某种意义或东西的符号
1.2、NLP任务
1)、简单
拼写检查
关键词提取
同义词查询
2)、中等
信息抽取
3)、高难
机器翻译
语义分析
指代
问答
2、词向量(word vectors)
2.1、ont-hot
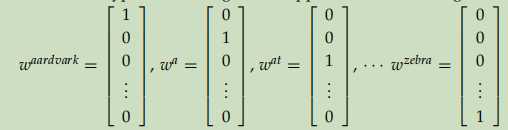

如图,每个词由V维的0,1向量组成,V是词典大小。有以下缺点:
1)、词之间凉凉正交,体现不出诸如男人、女人,中国、日本之间的相关性。
2)、当词典很大时,词向量太大。
那么我们是不是可以找到一种可以以低维的方式且能表示词之间相关性的词向量表示方法呢?
3、基于SVD的方法
4、基于迭代的方法-word2vector
4.1、语言模型
语言模型就是对一个语言序列进行建模。
比如
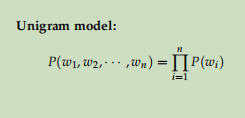
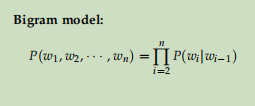
4.2、CBOW
模型思路:一个语言序列,通过某个词其周围的词预测中心词。
符号说明:
- wi : 词典里第i个词
- V : shape: (n, v), 输入的单词矩阵,n代表词向量的维度,v代表词典大小
- vi : V的第i列,shape=(n,1)
- U : shape=(v, n), 输出的单词矩阵
- ui : U的第i行,wi的输出向量表示
模型步骤:
- 对于一个序列,假设某词为x(c),其上下文为x(c-m), ...,x(c-1), x(c+1), ..., x(c+m),将其做one-hot表示
- 通过lookup得到上下文单词的嵌入词向量:v(c-m), v(c-m+1), ..., v(c+m)
- 对上下文词向量求平均:

- 将U与3中得到的向量做点乘,得到一个分。
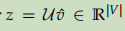
- 对z做softmax进行分类,预测属于哪个词:
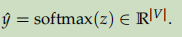
- 定义损失函数,交叉熵损失:

- 根据梯度下降法不断迭代反向传播,直到loss收敛。
模型结构:

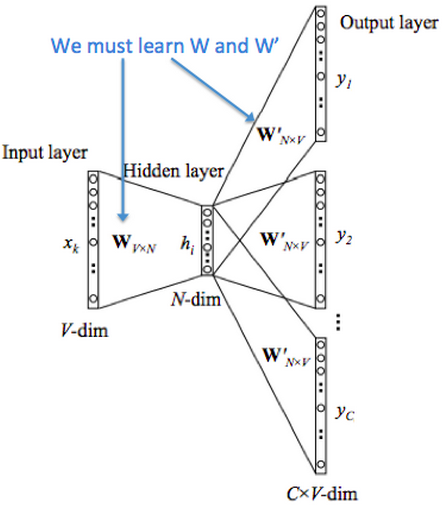
4.3、skip-gram model
模型思路:一个序列,通过中心词预测其上下文的词。
符号说明:
- wi : 词典里第i个词
- V : shape: (n, v), 输入的单词矩阵,n代表词向量的维度,v代表词典大小
- vi : V的第i列,shape=(n,1)
- U : shape=(v, n), 输出的单词矩阵
- ui : U的第i行,wi的输出向量表示
模型步骤:
- 得到中心词的one-hot表示
- lookup得到中心词的词向量
- 计算得分:

- 根据得分计算softmax, 预测上下文的词:

- 根据4得出的概率,计算预测出的词
- 同样采用交叉熵作为损失函数,此处值得留意的是,预测出的多个上下文单词之间假设是独立的,不因其与中心词的距离而受到影响,因此loss可以这么计算:

- 使用随机梯度下降法优化loss, 直到loss收敛。
模型结构:
4.4、负采样
4.5、hierarchical softmax
词向量训练的时候,假如说词典的大小为v,那么每次前向传播通常需要进行v次的点击运算,然后算出每个词的概率,非常耗时。
这里采用了两个方法减少计算,一个是把词向量进来后经过线性运算通常会加的非线性激活函数给去掉,换成求平均值。第二个就是把词分类的softmax换成一颗二叉霍夫曼树。

和之前的神经网络语言模型相比,我们的霍夫曼树的所有内部节点就类似之前神经网络隐藏层的神经元,其中,根节点的词向量对应我们的投影后的词向量,而所有叶子节点就类似于之前神经网络softmax输出层的神经元,叶子节点的个数就是词汇表的大小。在霍夫曼树中,隐藏层到输出层的softmax映射不是一下子完成的,而是沿着霍夫曼树一步步完成的,因此这种softmax取名为"Hierarchical Softmax"。
如何“沿着霍夫曼树一步步完成”呢?在word2vec中,我们采用了二元逻辑回归的方法,即规定沿着左子树走,那么就是负类(霍夫曼树编码1),沿着右子树走,那么就是正类(霍夫曼树编码0)。判别正类和负类的方法是使用sigmoid函数,即:

其中xwxw是当前内部节点的词向量,而θθ则是我们需要从训练样本求出的逻辑回归的模型参数。
使用霍夫曼树有什么好处呢?首先,由于是二叉树,之前计算量为VV,现在变成了log2Vlog2V。第二,由于使用霍夫曼树是高频的词靠近树根,这样高频词需要更少的时间会被找到,这符合我们的贪心优化思想。
CS224--1:语言模型和词向量的更多相关文章
- Deep Learning In NLP 神经网络与词向量
0. 词向量是什么 自然语言理解的问题要转化为机器学习的问题,第一步肯定是要找一种方法把这些符号数学化. NLP 中最直观,也是到目前为止最常用的词表示方法是 One-hot Representati ...
- 第一节——词向量与ELmo(转)
最近在家听贪心学院的NLP直播课.都是比较基础的内容.放到博客上作为NLP 课程的简单的梳理. 本节课程主要讲解的是词向量和Elmo.核心是Elmo,词向量是基础知识点. Elmo 是2018年提出的 ...
- NLP直播-1 词向量与ELMo模型
翻车2次,试水2次,今天在B站终于成功直播了. 人气11万. 主要讲了语言模型.词向量的训练.ELMo模型(深度.双向的LSTM模型) 预训练与词向量 词向量的常见训练方法 深度学习与层次表示 LST ...
- PyTorch基础——词向量(Word Vector)技术
一.介绍 内容 将接触现代 NLP 技术的基础:词向量技术. 第一个是构建一个简单的 N-Gram 语言模型,它可以根据 N 个历史词汇预测下一个单词,从而得到每一个单词的向量表示. 第二个将接触到现 ...
- [Algorithm & NLP] 文本深度表示模型——word2vec&doc2vec词向量模型
深度学习掀开了机器学习的新篇章,目前深度学习应用于图像和语音已经产生了突破性的研究进展.深度学习一直被人们推崇为一种类似于人脑结构的人工智能算法,那为什么深度学习在语义分析领域仍然没有实质性的进展呢? ...
- word2vec生成词向量原理
假设每个词对应一个词向量,假设: 1)两个词的相似度正比于对应词向量的乘积.即:$sim(v_1,v_2)=v_1\cdot v_2$.即点乘原则: 2)多个词$v_1\sim v_n$组成的一个上下 ...
- 学习笔记CB009:人工神经网络模型、手写数字识别、多层卷积网络、词向量、word2vec
人工神经网络,借鉴生物神经网络工作原理数学模型. 由n个输入特征得出与输入特征几乎相同的n个结果,训练隐藏层得到意想不到信息.信息检索领域,模型训练合理排序模型,输入特征,文档质量.文档点击历史.文档 ...
- 词向量之Word2vector原理浅析
原文地址:https://www.jianshu.com/p/b2da4d94a122 一.概述 本文主要是从deep learning for nlp课程的讲义中学习.总结google word2v ...
- DNN模型训练词向量原理
转自:https://blog.csdn.net/fendouaini/article/details/79821852 1 词向量 在NLP里,最细的粒度是词语,由词语再组成句子,段落,文章.所以处 ...
随机推荐
- Linux echo和cat和grep和tr的基础用法
Linux vim 搜索 echo : 显示输出功能 echo oldboy>1.txtx cat 1.txtx > 重定向 文件内容覆盖 >> 追加重定向 ...
- [系列] Go - 基于 GORM 获取当前请求所执行的 SQL 信息
前言 为了便于精准排查问题,需要将当前的请求信息与当前执行的 SQL 信息设置对应关系记录下来,记录的 SQL 信息包括: 执行 SQL 的当前时间: 执行 SQL 的文件地址和行号: 执行 SQL ...
- uni-app开发经验分享二十一: 图片滑动解锁插件制作解析
在开发用户模块的时候,相信大家都碰到过一个功能,图片滑动解锁后发送验证码,这里分享我用uni-app制作的一个小控件 效果如下: 需要如下图片资源 template <template> ...
- k8s之共享存储概述以及演示
共享存储机制 k8s对有状态的容器应用或者需要对数据进行持久化的应用,在之前的篇章说过,可以将容器内的目录挂载到宿主机的容器目录或者emptyDir临时存储卷. 另外,k8s还开放了两个资源,分别是P ...
- 04. struts2中Result配置的各种视图转发类型
概述 <action name="helloworld" class="com.liuyong666.action.HelloWorldAction"&g ...
- Java面向对象(一)----初次见面
面向对象 面向过程:根据业务逻辑从上到下写代码 函数式编程:对一些功能的代码封装到函数中,日后无需重复编写,直接调用函数就可以了 面向对象:将所有的功能进行封装,面对的事封装了功能的实体(对象),即面 ...
- get_or_create update_or_create
django/query.py at master · django/django https://github.com/django/django/blob/master/django/db/mod ...
- I/O 复用 multiplexing data race 同步 coroutine 协程
小结: 1.A file descriptor is considered ready if it is possible to perform the corresponding I/O opera ...
- MySql(三)存储过程和函数
MySql(三)存储过程和函数 一.什么是存储过程和函数 二.存储过程和函数的相关操作 一.什么是存储过程和函数 存储过程和函数是事先经过编译并存储在数据库中的一段SQL语句的集合,调用存储过程和函数 ...
- GeoServer发布Shapfile、PostGIS数据
GeoServer发布Shapfile.PostGIS数据 一.GeoServer发布Shapfile数据 1.1 创建工作区 1.1.1 工作区 1.2 在工作区中加入新的数据存储 1.2.1 数据 ...