
Python爬虫(一):爬虫伪装
1 简介
对于一些有一定规模或盈利性质比较强的网站,几乎都会做一些防爬措施,防爬措施一般来说有两种:一种是做身份验证,直接把虫子挡在了门口,另一种是在网站设置各种反爬机制,让虫子知难而返。
2 伪装策略
我们知道即使是一些规模很小的网站通常也会对来访者的身份做一下检查,如验证请求 Headers,而对于那些上了一定规模的网站就更不用说了。因此,为了让我们的爬虫能够成功爬取所需数据信息,我们需要让爬虫进行伪装,简单来说就是让爬虫的行为变得像普通用户访问一样。
2.1 Request Headers问题
为了演示我使用百度搜索 163邮箱

使用 F12 工具看一下请求信息
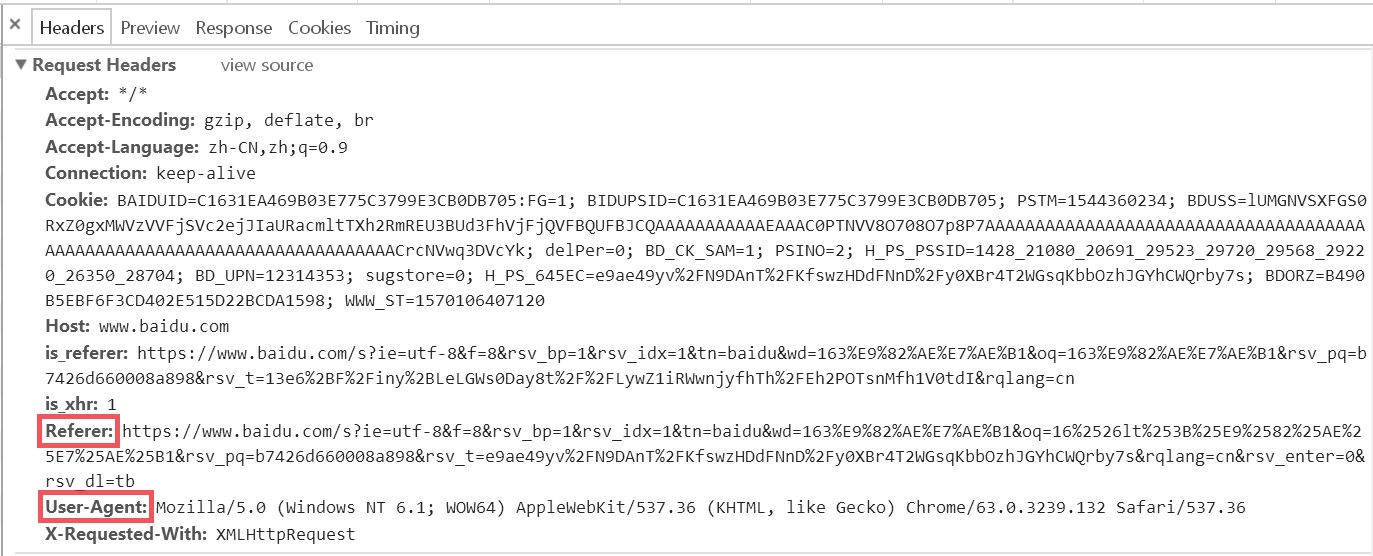
在上图中,我们可以看到 Request Headers 中包含 Referer 和 User-Agent 两个属性信息,Referer 的作用是告诉服务器该网页是从哪个页面链接过来的,User-Agent 中文是用户代理,它是一个特殊字符串头,作用是让服务器能够识别用户使用的操作系统、CPU 类型、浏览器等信息。通常的处理策略是:1)对于要检查 Referer 的网站就加上;2)对于每个 request 都添加 User-Agent。
2.2 IP限制问题
有时我们可能会对一些网站进行长期或大规模的爬取,而我们在爬取时基本不会变换 IP,有的网站可能会监控一个 IP 的访问频率和次数,一但超过这个阈值,就可能认作是爬虫,从而对其进行了屏蔽,对于这种情况,我们要采取间歇性访问的策略。
通常我们爬取是不会变换 IP 的,但有时可能会有一些特殊情况,要长时间不间断对某网站进行爬取,这时我们就可能需要采用 IP 代理的方式,但这种方式一般会增加我们开销,也就是可能要多花钱。
3 总结
有些时候我们进行爬取时 Request Headers 什么的已经做好了伪装,却并未得到如愿以偿的结果,可能会出现如下几种情况:得到的信息不完整、得到不相关的信息、得不到信息,这种情况我们就需要研究网站的防爬机制,对其进行详细分析了。常见的几种我列一下:
1)不规则信息:网址上会有一些没有规则的一长串信息,这种情况通常采用 selenium(模拟浏览器,效率会低一些) 解决;
2)动态校验码:比如根据时间及一些其他自定义规则生成,这种情况我们就需要找到其规则进行破解了;
3)动态交互:需要与页面进行交互才能通过验证,可以采用 selenium 解决;
4)分批次异步加载:这种情况获取的信息可能不完整,可以采用 selenium 解决。
Python爬虫(一):爬虫伪装的更多相关文章
- Python做简单爬虫(urllib.request怎么抓取https以及伪装浏览器访问的方法)
一:抓取简单的页面: 用Python来做爬虫抓取网站这个功能很强大,今天试着抓取了一下百度的首页,很成功,来看一下步骤吧 首先需要准备工具: 1.python:自己比较喜欢用新的东西,所以用的是Pyt ...
- Python 开发轻量级爬虫05
Python 开发轻量级爬虫 (imooc总结05--网页下载器) 介绍网页下载器 网页下载器是将互联网上url对应的网页下载到本地的工具.因为将网页下载到本地才能进行后续的分析处理,可以说网页下载器 ...
- Python学习网络爬虫--转
原文地址:https://github.com/lining0806/PythonSpiderNotes Python学习网络爬虫主要分3个大的版块:抓取,分析,存储 另外,比较常用的爬虫框架Scra ...
- Python基础及爬虫入门
**写在前面**我们在学习任何一门技术的时候,往往都会看很多技术博客,很多程序员也会写自己的技术博客.但是我想写的这些不是纯技术博客,我暂时也没有这个能力写出 Python 或者爬虫相关的技术博客来. ...
- Python 爬虫1——爬虫简述
Python除了可以用来开发Python Web之后,其实还可以用来编写一些爬虫小工具,可能还有人不知道什么是爬虫的. 一.爬虫的定义: 爬虫——网络爬虫(又被称为网页蜘蛛,网络机器人,在FOAF社区 ...
- Python 开发轻量级爬虫08
Python 开发轻量级爬虫 (imooc总结08--爬虫实例--分析目标) 怎么开发一个爬虫?开发一个爬虫包含哪些步骤呢? 1.确定要抓取得目标,即抓取哪些网站的哪些网页的哪部分数据. 本实例确定抓 ...
- Python 开发轻量级爬虫07
Python 开发轻量级爬虫 (imooc总结07--网页解析器BeautifulSoup) BeautifulSoup下载和安装 使用pip install 安装:在命令行cmd之后输入,pip i ...
- Python 开发轻量级爬虫06
Python 开发轻量级爬虫 (imooc总结06--网页解析器) 介绍网页解析器 将互联网的网页获取到本地以后,我们需要对它们进行解析才能够提取出我们需要的内容. 也就是说网页解析器是从网页中提取有 ...
- Python 开发轻量级爬虫04
Python 开发轻量级爬虫 (imooc总结04--url管理器) 介绍抓取URL管理器 url管理器用来管理待抓取url集合和已抓取url集合. 这里有一个问题,遇到一个url,我们就抓取它的内容 ...
- Python 开发轻量级爬虫03
Python 开发轻量级爬虫 (imooc总结03--简单的爬虫架构) 现在来看一下一个简单的爬虫架构. 要实现一个简单的爬虫,有哪些方面需要考虑呢? 首先需要一个爬虫调度端,来启动爬虫.停止爬虫.监 ...
随机推荐
- 牛客暑假多校第五场 D inv
题意:给你一个n, 接来下给你一个 [1,n] 中偶数的排列, 还有一个 [1, n] 中 奇数 按照递增的顺序排列, 现在求一个原数列, 使得偶数列排序 和 奇数列 都是原数列的一个子序列, 现在求 ...
- bzoj2049 Cave 洞穴勘测 lct
这里比上次多了几个操作. 1. make_root(u) 换根节点, 先access(u), 再splay(u),将u移动到splay树的最顶上, 现在这棵splay对于root来说 只有左子树上有东 ...
- codeforces 233 D. Table(思维+dp )
题目链接:http://codeforces.com/contest/233/problem/D 题意:问在n*m的矩阵中满足在每一个n*n的矩阵里画k个点,一共有几种画法. 题解:其实这题挺简单的但 ...
- Spreading the Wealth uva 11300
A Communist regime is trying to redistribute wealth in a village. They have have decided to sit ever ...
- hdu1576 扩展欧几里德 A/B
A/B Time Limit: 1000/1000 MS (Java/Others) Memory Limit: 32768/32768 K (Java/Others)Total Submiss ...
- Catch That Cow POJ - 3278 [kuangbin带你飞]专题一 简单搜索
Farmer John has been informed of the location of a fugitive cow and wants to catch her immediately. ...
- github 授权登录教程与如何设计第三方授权登录的用户表
需求:在网站上想评论一篇文章,而评论文章是要用户注册与登录的,那么怎么免去这麻烦的步骤呢?答案是通过第三方授权登录.本文讲解的就是 github 授权登录的教程. 效果体验地址:http://biao ...
- java 面试题 1-10
1. Java 基础部分 基础部分的顺序:基本语法,类相关的语法,内部类的语法,继承相关的语法,异常的语法, 线程的语法,集合的语法,io 的语法,虚拟机方面的语法 1.一个".java&q ...
- 【Bit String Reordering UVALive - 6832 】【模拟】
题意分析 题目讲的主要是给你一个01串,然后给你要变成的01串格式,问你要转换成这一格式最少需要移动的步数. 题目不难,但当时并没有AC,3个小时的个人赛1道没AC,归根到底是没有逼自己去想,又想的太 ...
- 【Offer】[35] 【复杂链表的复制】
题目描述 思路分析 测试用例 Java代码 代码链接 题目描述 输入一个复杂链表(每个节点中有节点值,以及两个指针,一个指向下一个节点,另一个特殊指针指向任意一个节点),返回结果为复制后复杂链表的he ...