
[spark程序]统计人口平均年龄(本地文件)(详细过程)
一、题目描述
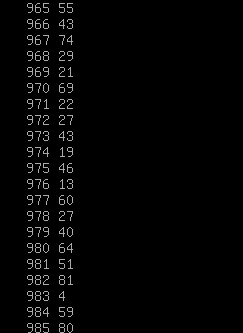
(1)编写Spark应用程序,该程序可以在本地文件系统中生成一个数据文件peopleage.txt,数据文件包含若干行(比如1000行,或者100万行等等)记录,每行记录只包含两列数据,第1列是序号,第2列是年龄。效果如下:
1    89

2    67

3    69

4    78
(2)编写Spark应用程序,对本地文件系统中的数据文件peopleage.txt的数据进行处理,计算出所有人口的平均年龄。
二、实现
1、生成数据文件peopleage.txt
1)创建程序的目录结构
创建一个存放代码的目录,进入目录下创建一个目录用来保存该题目所有文件(/swy/resource/spark/peopleage)
在peopleage目录下建立src/main/scala代码目录,专门用来保存scala代码文件,命令如下:

2)生成数据文件peopleage.txt的代码
创建一个代码文件GeneratePeopleAge.scala,用来生成数据文件peopleage.txt,命令如下:


代码如下:
import java.io.FileWriter

import java.io.File

import scala.util.Random

object GeneratePeopleAge{

    def main(args:Array[String]){

            val fileWriter = new FileWriter(new File("/swy/resource/spark/peopleage/peopleage.txt"),false)

            val rand = new Random()

            for (i <- 1 to 1000){

                fileWriter.write(i+" "+rand.nextInt(100))

                fileWriter.write(System.getProperty("line.separator"))

        }

            fileWriter.flush()

            fileWriter.close()

    }

}
3)sbt打包
退回到people目录下:

输入如下:
name := "Simple Project"

version := "1.0"

scalaVersion := "2.11.12"

libraryDependencies += "org.apache.spark" %% "spark-core" % "2.1.0"
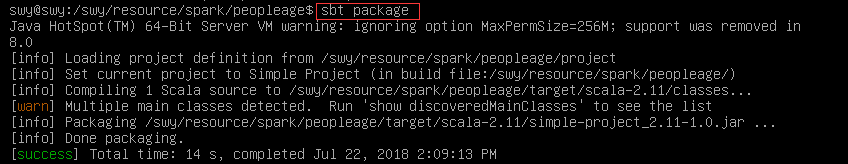
输入命令打包:
sbt package
打包成功:

4)运行文件,生成peopleage.txt

可以看到目录下已经生成peopleage.txt,查看文件:
2、计算所有人口的平均年龄
1)创建CountAvgage.scala

2)代码
import org.apache.spark.SparkConf

import org.apache.spark.SparkContext

object CountAvgAge {

    def main(args:Array[String]) {

        if (args.length < 1) {

            println("Usage: CountAvgAge inputdatafile")

            System.exit(1)

        }

        val conf = new SparkConf().setAppName("Count average age")

        val sc = new SparkContext(conf)

        val lines = sc.textFile(args(0),3)

        val peopleNum =lines.count()

                val totalAge = lines.map(line => line.split(" ")(1)).map(t => t.trim.toInt).collect().reduce((a,b) => a+b)

        println("Total Age is: " +totalAge+ "; Number of People is: " +peopleNum)

        val avgAge : Double = totalAge.toDouble / peopleNum.toDouble

        println("Average Age is: " +avgAge)

    }

}
3)打包
退回people文件夹,输入命令打包:
4)运行程序
输入如下命令:

结果:
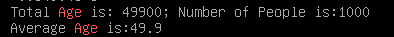
原文:http://dblab.xmu.edu.cn/blog/1756-2/
[spark程序]统计人口平均年龄(本地文件)(详细过程)的更多相关文章
- [spark程序]统计人口平均年龄(HDFS文件)(详细过程)
一.题目描述 (1)请编写Spark应用程序,该程序可以在分布式文件系统HDFS中生成一个数据文件peopleage.txt,数据文件包含若干行(比如1000行,或者100万行等等)记录,每行记录只包 ...
- 记录一次用宝塔部署微信小程序Node.js后端接口代码的详细过程
一直忙着写毕设,上一次写博客还是元旦,大半年过去了.... 后面会不断分享各种新项目的源码与技术.欢迎关注一起学习哈! 记录一次部署微信小程序Node.js后端接口代码的详细过程,使用宝塔来部署. 我 ...
- R语言—统计结果输出至本地文件方法总结
1.sink()在代码开始前加一行:sink(“output.txt”),就会自动把结果全部输出到工作文件夹下的output.txt文本文档.这时在R控制台的输出窗口中是看不到输出结果的.代码结束时用 ...
- JNI初级:android studio生成so文件详细过程
本文主要参考blog:http://blog.csdn.net/jkan2001/article/details/54316375 下面是本人结合blog生成so包过程中遇到一些问题和解决方法 (1) ...
- Spark保存到HDFS或本地文件相关问题
spark中saveAsTextFile如何最终生成一个文件 http://www.lxway.com/641062624.htm 一般而言,saveAsTextFile会按照执行task的多少生成多 ...
- 5、创建RDD(集合、本地文件、HDFS文件)
一.创建RDD 1.创建RDD 进行Spark核心编程时,首先要做的第一件事,就是创建一个初始的RDD.该RDD中,通常就代表和包含了Spark应用程序的输入源数据.然后在创建了初始的RDD之后,才可 ...
- Spark程序本地运行
Spark程序本地运行 本次安装是在JDK安装完成的基础上进行的! SPARK版本和hadoop版本必须对应!!! spark是基于hadoop运算的,两者有依赖关系,见下图: 前言: 1.环境 ...
- Spark学习笔记1——第一个Spark程序:单词数统计
Spark学习笔记1--第一个Spark程序:单词数统计 笔记摘抄自 [美] Holden Karau 等著的<Spark快速大数据分析> 添加依赖 通过 Maven 添加 Spark-c ...
- spark本地环境的搭建到运行第一个spark程序
搭建spark本地环境 搭建Java环境 (1)到官网下载JDK 官网链接:https://www.oracle.com/technetwork/java/javase/downloads/jdk8- ...
随机推荐
- s32k144 bootloader
s32k144 bootloader升级 mcu : s32k144 can_tool : kvaser 摘要:实现can升级app程序,现在网上大多是CAN_FD升级bootloade ...
- MS12-042 用户态调度机制特权提升漏洞
漏洞编号:MS12-042 披露日期: 2012/6/12 受影响的操作系统:Windows 2000;XP;Server 2003;windows 7;Server 2008; 测试系统:windo ...
- java web项目下的lib和build path 中jar包问题解惑
一.build path&WEB-INFO/lib介绍 build path:可以说是引用: WEB-INFO/lib:可以说是固定在一个地方: eclipse编译项目的时候是根据build ...
- 快速排序方法——python实现
参考博文:http://www.cnblogs.com/jingmoxukong/p/4302891.html 快速排序是一种交换排序. 快速排序由C. A. R. Hoare在1962年提出. 它的 ...
- vue 开发插件流程
UI demo UI 插件汇总 我的github iSAM2016 在练习写UI组件的,用到全局的插件,网上看了些资料.看到些的挺好的,我也顺便总结一下写插件的流程: 声明插件-> 写插件-&g ...
- Leetcode Tags(8)Binary Search
一.475. Heaters 输入: [1,2,3],[2] 输出: 1 解释: 仅在位置2上有一个供暖器.如果我们将加热半径设为1,那么所有房屋就都能得到供暖. 输入: [1,2,3,4],[1,4 ...
- Java基础(十六)断言(Assertions)
1.断言的概念 假设确信某个属性符合要求,并且代码的执行依赖于这个属性. 断言机制允许在测试期间向代码插入一些检查语句,当代码发布时,这些插入的检查语句将会被自动地移走. 断言失败是致命的,不可恢复的 ...
- style.html
<!DOCTYPE html> <html> <head> <meta charset="UTF-8"> <title> ...
- MarkDown的常用语法
个人比较喜欢Markdown的语法,常用来做一些笔记,下面就简单介绍一下它的语法. 概览 宗旨 Markdown 的目标是实现「易读易写」. 可读性,无论如何,都是最重要的.一份使用 Markdown ...
- dbms_job基础
a.创建job: dbms_job.submit(jobno,what,next_date,interval);b.删除job: dbms_job.remove(jobno); c.修改要执行的操作: ...