
小白学 Python 爬虫(6):前置准备(五)爬虫框架的安装
人生苦短,我用 Python
前文传送门:
小白学 Python 爬虫(2):前置准备(一)基本类库的安装
小白学 Python 爬虫(3):前置准备(二)Linux基础入门
小白学 Python 爬虫(4):前置准备(三)Docker基础入门
小编,你还有完没完!!!前置准备都准备这么多了,还不开始正文!!!
别急别急,前置准备的最后一篇了,我们这几篇总共介绍了基本类库的安装、 Linux 基础、 Docker 基础和本篇的爬虫框架的安装。主要是内容有些多,小编怕写在一起各位同学看不下去,所以才分成多篇内容(悄悄的说,这样小编也能多推几天嘛)。
pyspider 安装
pyspider 是由国人 binux 开源的强大的网络爬虫框架。 pyspider 自带 WebUI (这个很关键),这样我们可以实时的看到更多的数据,并且它还带有脚本编辑器、任务监控器、项目管理器以及结果处理器,同时支持多种数据库后端、多种消息队列,还支持JavaScript渲染页面的爬取,异常强大。
Github 链接: https://github.com/binux/pyspider
官方文档: http://docs.pyspider.org/
开始安装,我们还是使用 pip 进行安装:
pip install pyspider
如果各位是跟着小编一步一步装环境的话,这里应该会报错。会报我们安装 pycurl 失败。这里我们需要使用 wheel 进行安装。
第一步,安装 wheel 。
pip install wheel
下载 pycurl 的 wheel 文件进行安装,下载站点:http://www.lfd.uci.edu/~gohlke/pythonlibs/ ,找到对应的 wheel 文件版本。比如小编这里的电脑是 win64 , python3.7 ,那么就下载 pycurl‑7.43.0.3‑cp37‑cp37m‑win_amd64.whl 这个文件。
小编这里将下载好的文件放到了 D 盘的跟目录,顾使用以下命令安装。
pip install D:\pycurl-7.43.0.3-cp37-cp37m-win_amd64.whl
安装完成后,重新执行上面的安装语句。
pip install pyspider
静静等待进度条读完,完成后可以直接在命令行下启动 pyspider ,命令如下:
pyspider all
然后发现,启动报错了,错误内容如下:
SyntaxError: invalid syntax
因为 async 和 await 从 python3.7 开始已经加入保留关键字中。所以async不能作为函数的参数名。
所以我们需要修改 pyspider 代码中有用到 async 的地方,具体路径为:
修改 %homepath%\AppData\Local\Programs\Python\Python37\Lib\site-packages\pyspider\ 路径下的 python 文件中的 async 为 async1 (全部替换)
- run.py
- fetcher\tornado_fetcher.py
- webui\app.py
修改完成后,再执行 pyspider all ,发现还是报错,这不过这次的错误换成了:
ValueError: Invalid configuration: - Deprecated option 'domaincontroller': use 'http_authenticator
原因是因为 WsgiDAV 发布了版本 pre-release 3.x。
解决办法:
还是在刚才的路径中找到webui文件里面的 webdav.py 文件打开,修改第 209 行。
将:
'domaincontroller': NeedAuthController(app),
修改为:
'http_authenticator':{

    'HTTPAuthenticator':NeedAuthController(app),

},
然后再执行 pyspider all ,发现还是起不来,这是因为 pyspider 有依赖 PhantomJS ,我们再去下载 PhantomJS 进行安装,下载路径为:https://phantomjs.org/download.html ,下载完成后,从压缩包中将可执行文件 phantomjs.exe 放入 %homepath%\AppData\Local\Programs\Python\Python37\Scripts ,有没有感觉很熟悉,对嘞,这个和之前的 Chrome 的驱动文件放的是同一个位置。
这次我们输入 pyspider all 进行启动,这次应该可以启动成功,然后打开浏览器访问:http://localhost:5000/ ,可以看到如下页面:
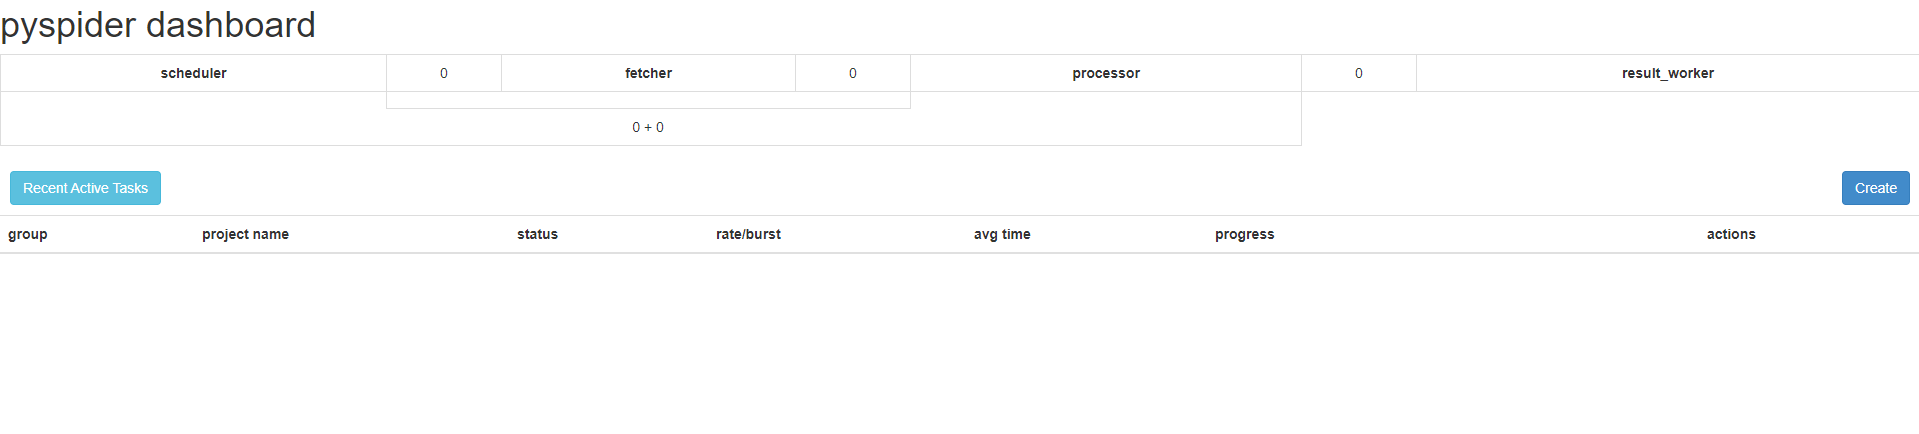
证明我们的 pyspider 已经安装成功了。
Scrapy 安装
Scrapy 这个就不用我介绍了吧,鼎鼎大名,接下来我们主要介绍安装过程。
Scrapy 官网: https://scrapy.org/
各位同学的电脑环境应该和小编的相差不远(如果是使用 win10 的话),小编也没有背着各位同学装过其他东西。
安装命令:
pip install scrapy
由于 Scrapy 依赖了大量的第三方的包,所以在执行上面的命令后并不会马上就下载 Scrapy ,而是会先不断的下载第三方包,包括并不限于以下几种:
- pyOpenSSL:Python 用于支持 SSL(Security Socket Layer)的包。
- cryptography:Python 用于加密的库。
- CFFI:Python 用于调用 C 的接口库。
- zope.interface:为 Python 缺少接口而提供扩展的库。
- lxml:一个处理 XML、HTML 文档的库,比 Python 内置的 xml 模块更好用。
- cssselect:Python 用于处理 CSS 选择器的扩展包。
- Twisted:为 Python 提供的基于事件驱动的网络引擎包。
- ......
等待命令执行完成后,直接输入 scrapy 进行验证。
Scrapy 1.8.0 - no active project

Usage:

  scrapy <command> [options] [args]

Available commands:

  bench         Run quick benchmark test

  fetch         Fetch a URL using the Scrapy downloader

  genspider     Generate new spider using pre-defined templates

  runspider     Run a self-contained spider (without creating a project)

  settings      Get settings values

  shell         Interactive scraping console

  startproject  Create new project

  version       Print Scrapy version

  view          Open URL in browser, as seen by Scrapy

  [ more ]      More commands available when run from project directory

Use "scrapy <command> -h" to see more info about a command
如果能正常出现以上内容,说明我们已经安装成功了。
因为小编电脑安装 Scrapy 未出现其他问题,一切都很顺利,无法做其他有问题情况的演示,理论上 Scrapy 安装出现各种问题才算正常情况,小编这种一次过的只能说是运气好。
前置准备到这里就全部结束,我们接下来开始介绍 HTTP 基础。
参考
http://c.biancheng.net/view/2745.html
https://cuiqingcai.com/5407.html
小白学 Python 爬虫(6):前置准备(五)爬虫框架的安装的更多相关文章
- 小白学 Python 爬虫(15):urllib 基础使用(五)
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 小白学 Python 爬虫(37):爬虫框架 Scrapy 入门基础(五) Spider Middleware
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 小白学 Python 爬虫(3):前置准备(二)Linux基础入门
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 Linux 基础 CentOS 官网: https: ...
- 小白学 Python 爬虫(4):前置准备(三)Docker基础入门
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 小白学 Python 爬虫(5):前置准备(四)数据库基础
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 小白学 Python 爬虫(2):前置准备(一)基本类库的安装
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 本篇内容较长,各位同学可以先收藏后再看~~ 在开始讲爬虫之前,还是先把环境搞搞好,工欲善其事必先利其器嘛~~~ 本篇 ...
- 小白学 Python 爬虫(7):HTTP 基础
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 小白学 Python 爬虫(8):网页基础
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 小白学 Python 爬虫(9):爬虫基础
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
随机推荐
- 百万年薪python之路 -- MySQL数据库之 常用数据类型
MySQL常用数据类型 一. 常用数据类型概览 # 1. 数字: 整型: tinyint int bigint 小数: float: 在位数比较短的情况下不精确 double: 在位数比较长的情况下不 ...
- 使用C++代码打印数字正方形
使用C++代码打印数字正方形 作为一名初学者,最近在跟着网课学习C++程序设计基础.在学习过程中遇到了一些习题,我根据自己的理解和思路写了一些代码实现,算是对自己学习过程的一个记录,也希望可以对别人有 ...
- lamda和匿名内部类
匿名内部类 匿名内部类在日常编程中还是经常会使用的.比如 ArrayList<String> list=new ArrayList<>(); list.add(new Stri ...
- 再谈 APISIX 高性能实践
2019 年 8 月 31 日,OpenResty 社区联合又拍云,举办 OpenResty × Open Talk 全国巡回沙龙·成都站,APISIX 主要作者王院生在活动上做了<APISIX ...
- OptimalSolution(2)--二叉树问题(2)BST、BBT、BSBT
一.判断二叉树是否为平衡二叉树(时间复杂度O(N)) 平衡二叉树就是:要么是一棵空树,要么任何一个节点的左右子树高度差的绝对值不超过1. 解法:整个过程为二叉树的后序遍历.对任何一个节点node来说, ...
- 设计模式(十五)Facade模式
Facade模式可以为相互关联在一起的错综复杂的类整理出高层接口,可以让系统对外只有一个简单的接口,而且还会考虑到系统内部各个类之间的责任关系和依赖关系,按照正常的顺序调用各个类. 还是先看一下示例程 ...
- QQ聊天记录分析
今天我们用R语言来处理一下.我们会用到一下技术:. (1)正则表达式 (2)词频统计 (3)文本可视化 (4)ggplot2绘图 (5)中文分词 一.数据处理 首先我们要讲QQ聊天记录导出成txt文件 ...
- 自定义segue的方向
花了挺久时间,终于通过google在stake overflow上找到了解决方式. 总结一下:重写一个custom的segue,在storyboard的右边设置segue为custom,并设置其对应的 ...
- open_basedir限制目录
1.open_basedir介绍 前言:前些日我用lnmp一键安装包出现了open_basedir的问题,因为我把项目目录变了,所以要在的fastcgi.conf下面加上open_basedir的目录 ...
- 使用Magicodes.SwaggerUI快速配置SwaggerUI以及设置API分组
Magicodes.SwaggerUI 快速配置和集成SwaggerUI 特点 通过配置文件简单配置即可完成SwaggerUI的API格式JSON生成和集成 支持API分组和隐藏 支持自定义页面和验证 ...