
Faiss使用多线程出现的性能问题
Faiss使用多线程出现的性能问题
faiss在增加CPU的情况下,反而出现效率低下的问题。
从理论上看,作为一个CPU/GPU计算型的应用,更多的核意味着更大的计算吞吐能力,性能只会越来越好才是。
在实际过程中,通过taskset命令分配更多的核给faiss只会带来更长响应时间以及更大的响应时间偏差(variation)。
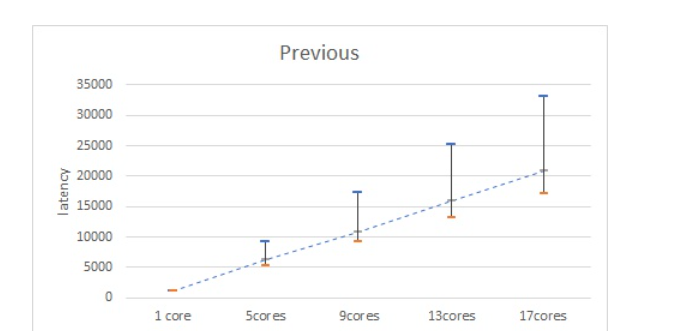
faiss的主要流程:建库(train)、校验(sanity check)、搜索。
由于建库是一次性操作,就不考虑建库带来的影响。对校验分析,也没有发现需要耗时太多的时间,那么主要问题就在搜索上面。
对于”核心越多,性能越差”的奇怪表现,搜索阶段又分两个部分,一个是quantizer,一个是search_preassigned。考虑应该跟线程的计算有关,于是将nprobe值和batch设置强置为1,从算法上保证search_preassigned只能用单核单线程。结果发现多核cpu依然满载。
那么直接用perf top命令查看系统调用栈。发现在多核、单线程的模式下占比最高的居然是libgomp,而真正的benchmark(6-IVFPQ)只占了很少的CPU资源。
这就是核心的问题了:
- Faiss的多核心是通过openMP实现的。
- 默认OMP_NUM_THREADS等于所有可用的CPU数,即OpenMP默认将会在启动与核心数相同的线程数作为线程池。
- 默认情况下,openmp假定所有的调用都是计算密集型的。为了减少线程启动/唤醒过程需要上下文开销,系统必须时刻保证每一个线程都是alive状态。换句话说,要让线程活着,OpenMP会让线程池的每个线程做大量的无意义计算占据时间片而不是wait挂起。
- quantizer 的过程中系统启动了omp线程池,理论上在修改后的search_preassigned开始后,线程池已经没有任何意义。但在放任不管的情况下,系统的每个核心的CPU使用率都会被空白计算占据,理论上100%。主线程结束之前线程池不会自己销毁。
- 这个时候如果位于主线程上的search_preassigned函数需要执行,那就不得不与OMP线程池抢占CPU time。这就是核心越多性能越差的原因。而放大这个影响的原因是我们的测试程序经过了变态级别的优化之后导致OMP的线程维护开销远远大于任务的CPU开销(微秒级响应,少于0.1个最小上下文)。这个测试事实上成为了某种程度“系统调度时延”测量。这个结果恰恰反应了预期。
剩下的就是解这个问题了,那只要在合适的时候让线程池销毁所有线程就迎刃而解了。OpenMP的实现是基于编译器的,发现没有办法可以直接实现目的,只有两个对应的环境变量可以缓解:
- GOMP_SPINCOUNT= omp线程经过了n个spin lock之后便被挂起。自然,n值越小就越早的挂起线程。
- OMP_WAIT_POLICY=PASSIVE 通过使用wait方法挂起 omp线程。对应的ACTIVE 意味着线程池中的线程始终处于活动状态——消耗大量的CPU。
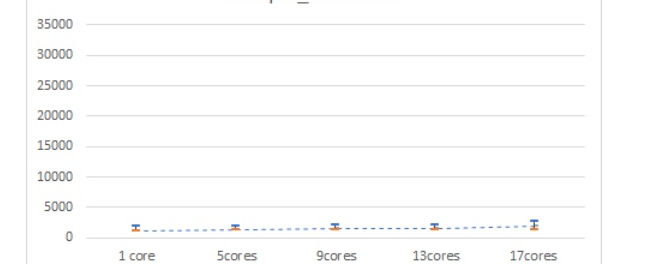
看上去效果还是不错的。
PS:并没有对所有情况进行测试,现在的结果指向是由于faiss依赖的openblat库中额外的omp线程池出现了问题导致主线程性能受到影响。理论上多线程也会如此,只是概率上导致看上去性能不是线性下降。
然后OMP_WAIT_POLICY的问题,主要是对在openmp下使用OpenBLAS的BLAS实现的时候起作用,此外,如果用了MKL库,一定条件下的MKL同样也会触发。
然后在faiss建立索引(train),也可能会出现这种情况,使用最新的faiss1.6.5及以后建立索引,CPU占用率明显有下降。
参考:http://www.litrin.net/2020/03/26/faiss的多线程效率问题/
https://www.cnblogs.com/yhzhou/p/10568728.html
https://www.cnblogs.com/yangyangcv/archive/2012/03/23/2413335.html
Faiss使用多线程出现的性能问题的更多相关文章
- [.net 面向对象程序设计进阶] (18) 多线程(Multithreading)(三) 利用多线程提高程序性能(下)
[.net 面向对象程序设计进阶] (18) 多线程(Multithreading)(二) 利用多线程提高程序性能(下) 本节导读: 上节说了线程同步中使用线程锁和线程通知的方式来处理资源共享问题,这 ...
- [.net 面向对象程序设计进阶] (17) 多线程(Multithreading)(二) 利用多线程提高程序性能(中)
[.net 面向对象程序设计进阶] (17) 多线程(Multithreading)(二) 利用多线程提高程序性能(中) 本节要点: 上节介绍了多线程的基本使用方法和基本应用示例,本节深入介绍.NET ...
- [.net 面向对象程序设计进阶] (16) 多线程(Multithreading)(一) 利用多线程提高程序性能(上)
[.net 面向对象程序设计进阶] (16) 多线程(Multithreading)(一) 利用多线程提高程序性能(上) 本节导读: 随着硬件和网络的高速发展,为多线程(Multithreading) ...
- DirectX* 11 多线程渲染的性能、方法和实践
对于在 CPU 上运行的 PC 游戏,渲染通常是主要的性能瓶颈:多线程渲染是一种消除瓶颈的有效方法.本文研究了 DirectX* 11 多线程渲染的性能可扩展性,讨论了多线程渲染的两种基本方法,并介绍 ...
- DELPHI用const来提高应用程序在多核多线程下的性能
来自:http://bbs.csdn.net/topics/330048800 --------------------------------------------------------- 我们 ...
- 【原创】python多线程测试接口性能
除了使用性能测试工具进行性能测试,我们也可以直接用python多线程进行性能测试. 下面,使用这几个模块,对一个查询接口做性能测试: requests:发送http请求 json:返回的字符串转换成j ...
- 【Bugly干货】Android性能优化典范之多线程篇
本文涉及的内容有:多线程并发的性能问题,介绍了 AsyncTask,HandlerThread,IntentService 与 ThreadPool 分别适合的使用场景以及各自的使用注意事项,这是一篇 ...
- [转载] Python的GIL是什么鬼,多线程性能究竟如何
原文: http://cenalulu.github.io/python/gil-in-python/ GIL是什么 首先需要明确的一点是GIL并不是Python的特性,它是在实现Python解析器( ...
- python GIL 全局锁,多核cpu下的多线程性能究竟如何?
python GIL 全局锁,多核cpu下的多线程性能究竟如何?GIL全称Global Interpreter Lock GIL是什么? 首先需要明确的一点是GIL并不是Python的特性,它是在实现 ...
随机推荐
- 分别在Update和FixedUpdate使用GetKeyDown
测试目的 探究分别在Update和FixedUpdate使用GetKeyDown执行次数,会不同的 测试开始 在Update测试 我们先在Update测试,很正常是一帧重置一下状态,以防止点击一下执行 ...
- Java 获取、删除Word文本框中的表格
本文介绍如何来获取Word文本框中包含的表格,以及删除表格. 程序测试环境包括: IDEA JDK 1.8.0 Spire.Doc.jar 注:jar导入,可通过创建Maven程序项目,并在pom.x ...
- Leetcode:169. 多数元素
Leetcode:169. 多数元素 传送门 思路 一开始想到的一个很简单的做法就是hash法,直接利用打表记录次数再输出结果. 而利用BM算法可以令算法复杂度同样也在\(O(n)\)的情况下,将空间 ...
- create-react-app 创建的项目执行npm run eject后,运行报错
create-react-app 创建的项目执行npm run eject后,运行报错:Cannot find module '@babel/plugin-transform-react-jsx-so ...
- 【阿菜用工具】利用 Web3.js 在 ganache 上部署以及调用智能合约
合约部署 要部署的合约 pragma solidity ^0.4.23; contract test { uint256 value; function setValue(uint256 _value ...
- 百度地图API基本使用(一)
本文系作者 chaoCode原创,转载请私信并在文章开头附带作者和原文地址链接. 违者,作者保留追究权利. 前言 由于最近项目有需要,所以最近开始研究百度地图API的使用,简单的介绍一下百度地图Jav ...
- 洛谷P2962题解
题面 看到 \(n \leq 35\) ,这是一个非常小的数据,但是 \(O(2^n)\) 的暴力跑不过去,所以考虑玄学做法 \(\text{Meet in Middle}\) .就是先做左边,然后做 ...
- CentOS 永久修改系统时间
1.查看当前系统时间 date 2.修改当前系统时间 date -s "2018-2-22 19:10:30 3.查看硬件时间 hwclock --show ...
- UVa120 煎饼(选择排序思想)
题目背景 给你一迭薄煎饼,请你写一个程式来指出要如何安排才能使这些薄煎饼由上到下依薄煎饼的半径由小到大排好.所有的薄煎饼半径均不相同. 要把薄煎饼排好序需要对这些薄煎饼做翻面(flip)的动作.方法是 ...
- Run Clojure Script with External Dependencies without leiningen
The normal way of deploy clojure files is using leiningen. But if we have no leiningen, or the scrip ...