
【NLP_Stanford课堂】情感分析
一、简介
实例:
- 电影评论、产品评论是positive还是negative
- 公众、消费者的信心是否在增加
- 公众对于候选人、社会事件等的倾向
- 预测股票市场的涨跌
Affective States又分为:
- emotion:短暂的情感,比如生气、伤心、joyful开心、害怕、羞愧、骄傲等
- mood:漫无原因的低强度长时间持续的主观感觉变化,比如cheerful,gloomy阴郁、irritable急躁、
- interpersonal stance:人际关系中对另一个人的立场,比如友好的、友善的
- attitude:态度,比如喜欢、讨厌
- personality trait:个性品质,比如鲁莽、焦虑
在情感分析中,我们针对的是attitude,分析的是:
- attitude的持有者(来源)
- attitude的目标(方面)
- attitude的类型:
- 来自一组类型:喜欢、爱、恨hate、重视value、渴望desire等
- 简单的带权重的极性:积极、消极和中性,均带有强度
- attitude的文本:句子或者整个文档
情感分析的任务:
- 简单任务:文本的attitude是积极还是消极
- 复杂任务:按照1-5对文本的attitude评级
- 高级任务:检查attitude的来源、目标或者复杂的attitude类型
二、基准算法
任务:极性检测:一部IMDB上的电影评论是积极还是消极
数据:Polarity Data 2.0: http://www.cs.cornell.edu/people/pabo/movie-review-data
步骤:
- Tokenization:将文本切分成词汇
- 特征提取
- 使用分类器分类:
- Naive Bayes
- MaxEnt
- SVM
1. Tokenization
需要应对:
- HTML和XML标记
- Twitter的标记(如,用户名、@)
- 大写单词(有时候需要保留)
- 电话号码、日期
- 表情符号
- 其他:
2. 特征提取
有效特征:
- 否定词
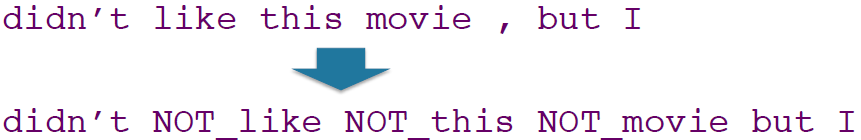
- 把在not后面直到下一个标点符号之间的词都加上NOT_,如下:
- 只选择形容词或者所有词(所有词的效果更好)
3. 二值多项式朴素贝叶斯
主要思想:在情感分析或者其他文本分类的任务中,认定一个词是否出现比起出现的频次更重要
训练过程:
- 将所有词的计数都重设为1
- 从训练语料中提取词汇表
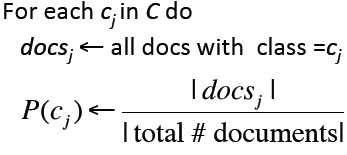
- 将每个文档中的词去重,只保留一个实例
- 将所有属于docsj类别的文档都连接成一个文档得到Textj
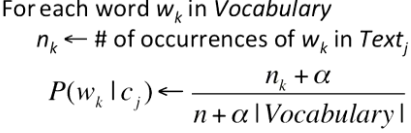
测试过程:
- 将测试文档中的词去重
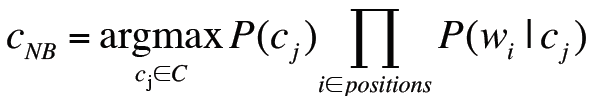
交叉验证:
- 将数据分成10组,每组内的测试集和训练集中positive和negative的比例一样
- 用前9组数据分别训练9个分类器,将最后一组数据完全作为测试集
- 以下是其中五组数据:
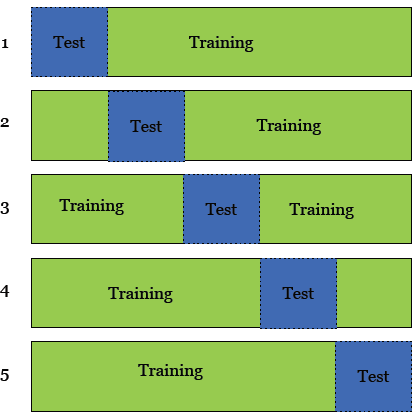
- 每组数据得到一个正确率,然后计算平均正确率
4. 难点
- 有些评论很隐晦,难以被分类器察觉
- 评论说的是原来自身的期望,然后说不符合期望,比如It should be brilliant,但是最后一句往往会说一句消极的话,所以语序也很重要
三、情感词典
词典中的每个词都存储了所属的情感。
1. 一般的情感词典
如下:
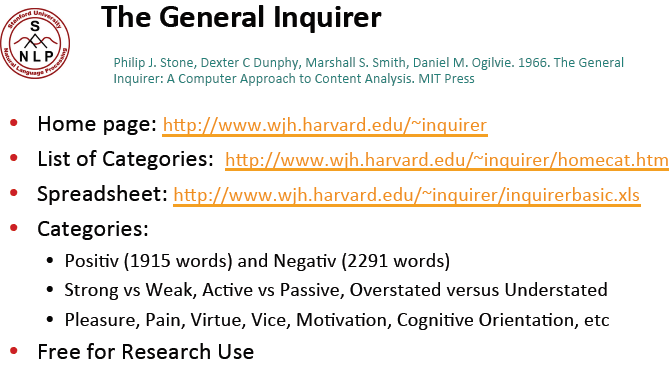
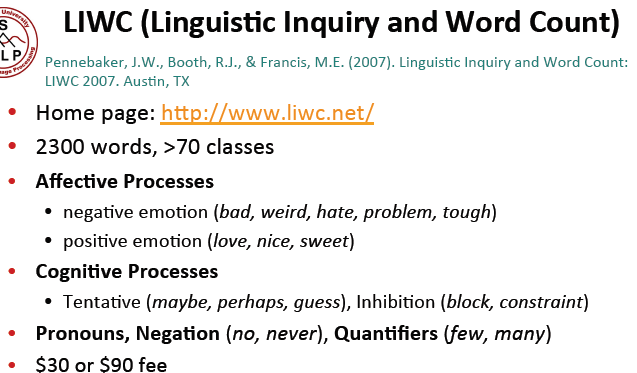
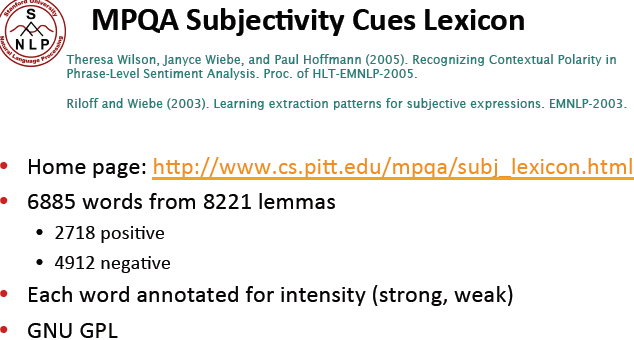

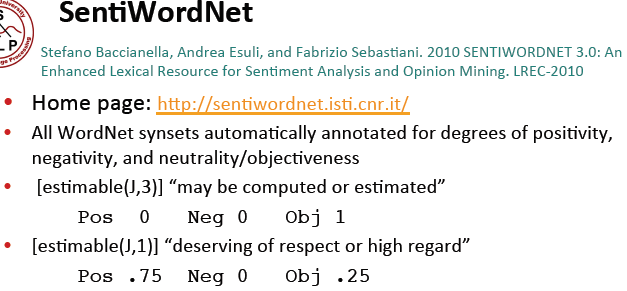
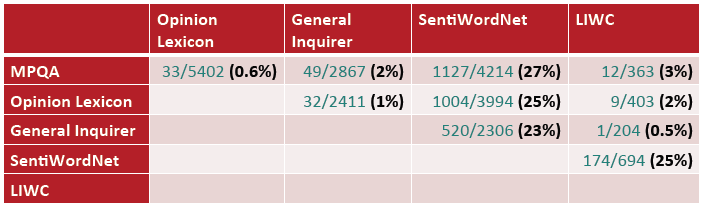
不同情感词典之间的同一个词极性的不一致性
2. 实例分析
分析IMDB中的每个词的极性
类别为1-10星,电影评论中都会附有星级评价,用这个来做类别,然后分析每个评论中的词,用以确定每个词的极性。
同一个词“bad”在不同的星级下计数如下:
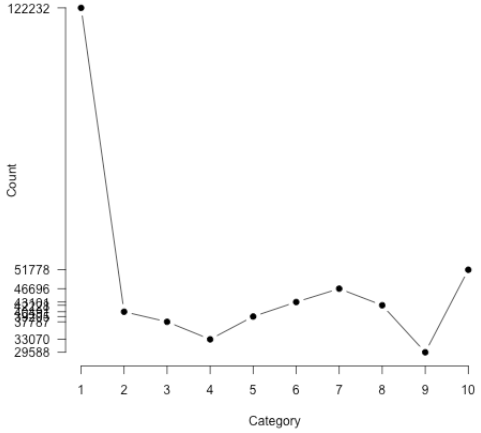
可以发现1星最多,这也是因为1星的评价最多,所以我们不能直接用这个来确定极性,而是用如下计算:
最大似然估计: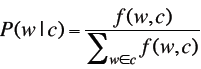
不同词之间的比较使用范围最大似然估计Scaled likelihood:
具体分析不同词在不同星级下的范围最大似然估计如下:
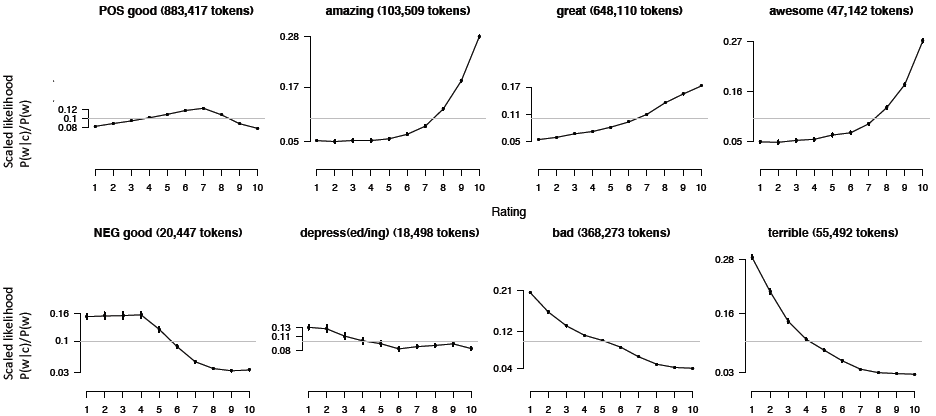
可以发现amazing和awesome在高分星级上出现的比较多,而bad和terrible在低分星级上出现较多
其他情感特征:否定词(no, not)
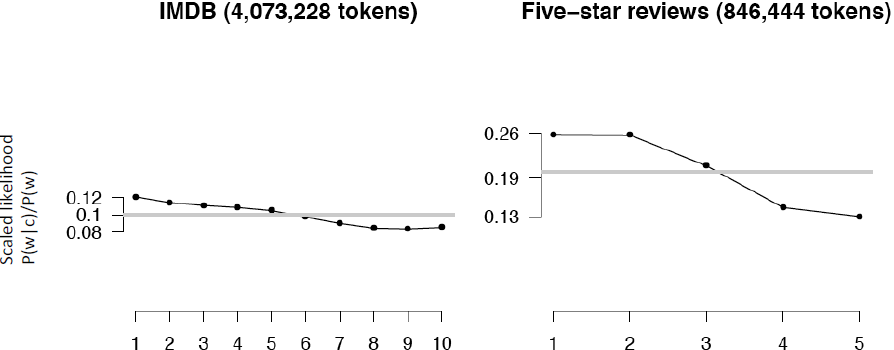
可以发现否定词在低分星级上出现的比较多
四、建立情感词典
主要使用半监督学习
- 先使用一个小的数据集,可能是
- 一些带标签的实例
- 一些手动建立的模式
- 然后建立一个词典
1. 基准算法
基本思想:源于
- 如果两个形容词用“and”连接,那么他们有相同的极性
- 如果用“but"连接,那么他们有相反的极性
步骤:
- 手动标记一个包括1336个形容词的种子数据集,其中有657个词是positive,679个词是negative
- 通过连接的形容词来扩展种子数据集。
- 比如使用Google:
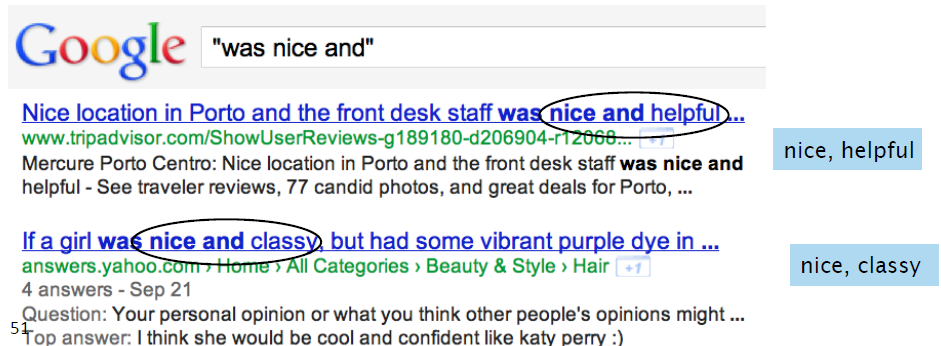
- 建立一个有监督的分类器,用以给每个词对分配极性相似性,即两个词极性上有多相似,主要使用count(AND)和count(BUT)。得到如下示意图:
- 将上图聚类成两堆,分别为positive和negative,如下:
- 输出极性的词典:positive和negative
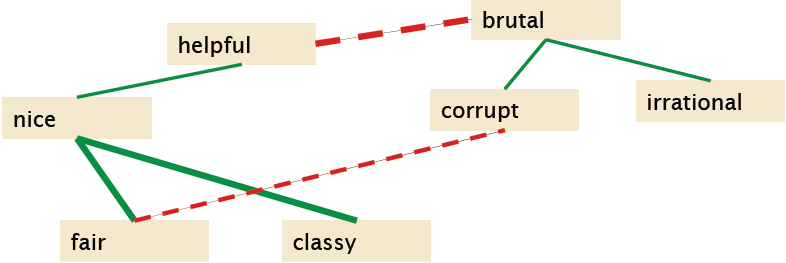
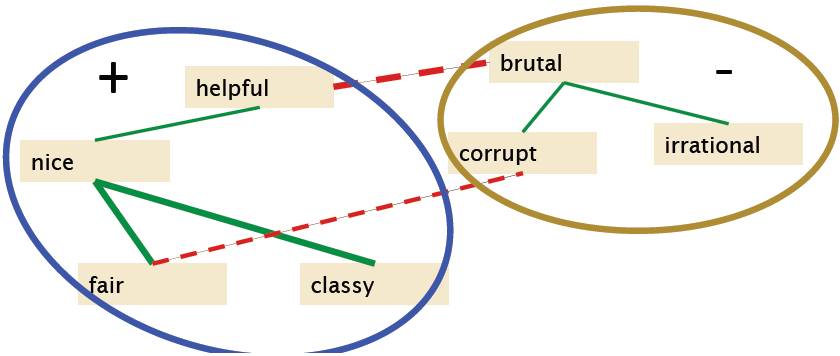
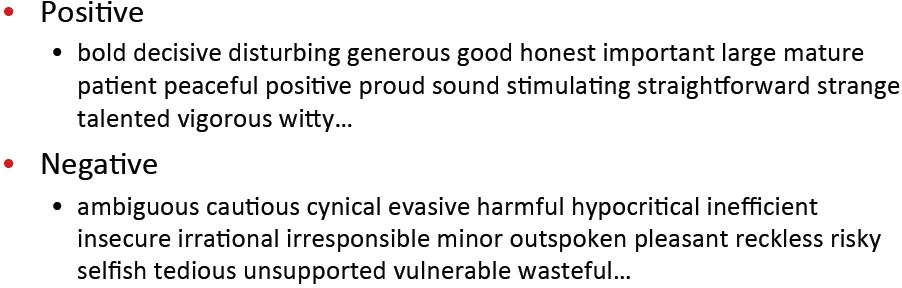
以上是针对形容词,下面介绍一种针对短语的词典的建立方法Turney Algorithm。
2. Turney算法
步骤类似,如下:
- 从评论中提取建立一个短语词典
- 将有如下词性组合的两个词都作为一个短语:
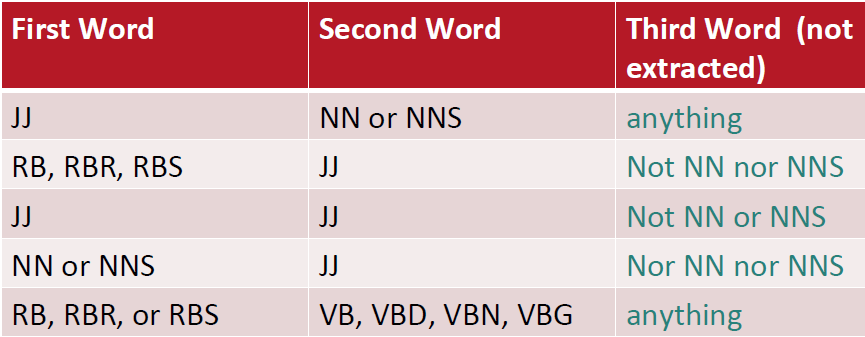 ,其中JJ表示形容词,NN表示名词,NNS表示复数形式的名词
- 将有如下词性组合的两个词都作为一个短语:
- 学习每个短语的词性:使用点间互信息PMI,基本思想也是使用两个词“and”共现的词的计数
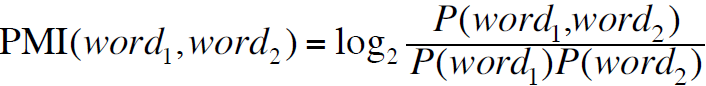
- 如何预估PMI:使用查询机制,类似于上述的搜索Google:
- 然后计算一个短语的极性:
- 对一个评论,计算其中的短语的平均极性,再评级
- 一个评论结果如下:
- 一个评论结果如下:
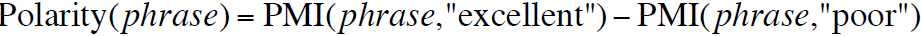
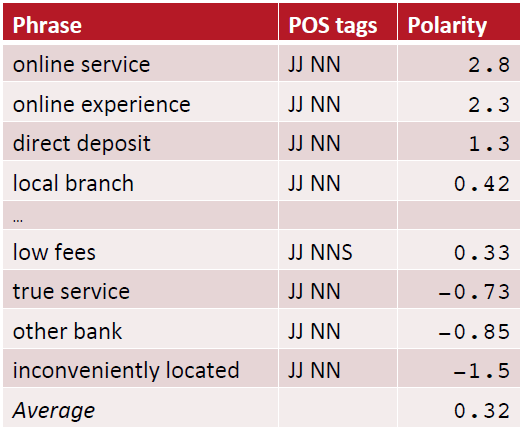
Turney Algorithm结果如下:
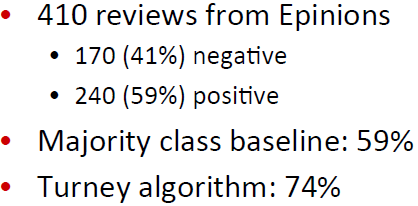
可以发现Turney算法比起基准算法更准确,或许是因为
- 短语比起单个词更准确
- Turney算法可以学到特定领域的信息
3. 使用WordNet学习极性
WordNet:在线同义词词典
步骤:
- 创建positive和negative的种子词典(“good”和“terrible”)
- 找到各种子词典里的同义词和反义词
- 重复以上步骤
- 过滤
五、其他情感分析任务
【NLP_Stanford课堂】情感分析的更多相关文章
- 朴素贝叶斯算法下的情感分析——C#编程实现
这篇文章做了什么 朴素贝叶斯算法是机器学习中非常重要的分类算法,用途十分广泛,如垃圾邮件处理等.而情感分析(Sentiment Analysis)是自然语言处理(Natural Language Pr ...
- Stanford NLP学习笔记:7. 情感分析(Sentiment)
1. 什么是情感分析(别名:观点提取,主题分析,情感挖掘...) 应用: 1)正面VS负面的影评(影片分类问题) 2)产品/品牌评价: Google产品搜索 3)twitter情感预测股票市场行情/消 ...
- 情感分析的现代方法(包含word2vec Doc2Vec)
英文原文地址:https://districtdatalabs.silvrback.com/modern-methods-for-sentiment-analysis 转载文章地址:http://da ...
- SA: 情感分析资源(Corpus、Dictionary)
先主要摘自一篇中文Survey,http://wenku.baidu.com/view/0c33af946bec0975f465e277.html 4.2 情感分析的资源建设 4.2.1 情感分析 ...
- 爬虫再探实战(五)———爬取APP数据——超级课程表【四】——情感分析
仔细看的话,会发现之前的词频分析并没有什么卵用...文本分析真正的大哥是NLP,不过,这个坑太大,小白不大敢跳...不过还是忍不住在坑边上往下瞅瞅2333. 言归正传,今天刚了解到boson公司有py ...
- Python爬虫和情感分析简介
摘要 这篇短文的目的是分享我这几天里从头开始学习Python爬虫技术的经验,并展示对爬取的文本进行情感分析(文本分类)的一些挖掘结果. 不同于其他专注爬虫技术的介绍,这里首先阐述爬取网络数据动机,接着 ...
- C#编程实现朴素贝叶斯算法下的情感分析
C#编程实现 这篇文章做了什么 朴素贝叶斯算法是机器学习中非常重要的分类算法,用途十分广泛,如垃圾邮件处理等.而情感分析(Sentiment Analysis)是自然语言处理(Natural Lang ...
- R语言做文本挖掘 Part5情感分析
Part5情感分析 这是本系列的最后一篇文章,该.事实上这种单一文本挖掘的每一个部分进行全部值获取水落石出细致的研究,0基础研究阶段.用R里面现成的算法,来实现自己的需求,当然还參考了众多网友的智慧结 ...
- 如何科学地蹭热点:用python爬虫获取热门微博评论并进行情感分析
前言:本文主要涉及知识点包括新浪微博爬虫.python对数据库的简单读写.简单的列表数据去重.简单的自然语言处理(snowNLP模块.机器学习).适合有一定编程基础,并对python有所了解的盆友阅读 ...
随机推荐
- HTML5获取地理经纬度并通过百度接口得到实时位置
注:用的时候将获取北京位置那放到获取经度纬度后面即可 -----------实际用的时候的代码如下:start -------- var myCity;getLocation()function g ...
- Docker安装及常用操作
Docker简介: Docker是一个轻量级容器技术,类似于虚拟机技术,但性能远远高于虚拟机,Docker支持将软件编译成一个镜像(image),在这个镜像中做好对软件的各种配置,然后可以运行这个镜像 ...
- jQuery validate 设置失去焦点就校验
<script type="text/javascript"> $(function(){ var flag = $("#addForm").val ...
- document.documentElement和document.body 与document.compatMode的关系
首先我们看看document.compatMode(兼容模式): document.compatMode它有两种可能的返回值:BackCompat和CSS1Compat, document.compa ...
- 前端emmet插件的一些常用用法
以下是在webstorm中简单使用emmet插件,注意一点就是当编写完emmet命令后一定要把光标移动到命令的结尾处,不然生成的代码会不一样 <!DOCTYPE html> <htm ...
- JavaScript弹出层
1.这个弹出层就是一个DIV 2.看需要什么效果 2.1.如果是仅仅需要弹出层,而背后的网页同样可以点击,那么只需要一个DIV即可,效果如图: 2.2.需要一层透明背景,而后面的网页只能看不能点,效果 ...
- Go的接口总结
一.什么是接口 接口类型是一种抽象的类型,它描述了一系列方法的集合. 接口约定:接口类型中定义的方法即为约定,若一个具体类型实现了所有这些方法,则该类型就满足该接口的约定,或者说它是这个接口类型的实例 ...
- c#实现16进制和字符串之间转换的代码
以下示例演示如何执行下列任务: 获取字符串中每个字符的十六进制值. 获取与十六进制字符串中的每个值对应的字符. 将十六进制 string 转换为整型. 将十六进制 string 转换为浮点型. 将字节 ...
- 从代理模式到Spring AOP
什么是代理模式 假如我喜欢上隔壁班的翠花,但是我没胆量向她送花,这时候我需要一个铁杆哥们帮我做这件事, 很明显这哥们是个代理,是去执行任务的,但是花实际上是我"送"的,代理和我一样 ...
- Spring学习笔记:Spring整合Mybatis(mybatis-spring.jar)(二:mybatis整合spring)
http://blog.csdn.net/qq598535550/article/details/51703190 二.Spring整合mybatis其实是在mybatis的基础上实现Spring框架 ...