
6.Spark streaming技术内幕 : Job动态生成原理与源码解析
原创文章,转载请注明:转载自 周岳飞博客(http://www.cnblogs.com/zhouyf/)
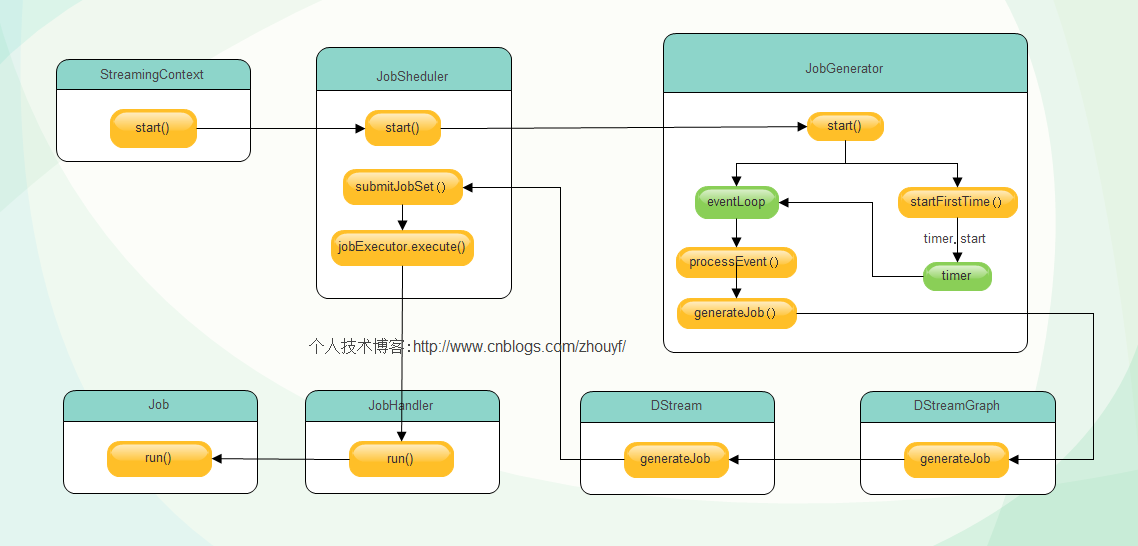
try {validate()// Start the streaming scheduler in a new thread, so that thread local properties// like call sites and job groups can be reset without affecting those of the// current thread.ThreadUtils.runInNewThread("streaming-start") {sparkContext.setCallSite(startSite.get)sparkContext.clearJobGroup()sparkContext.setLocalProperty(SparkContext.SPARK_JOB_INTERRUPT_ON_CANCEL, "false")savedProperties.set(SerializationUtils.clone(sparkContext.localProperties.get()).asInstanceOf[Properties])scheduler.start()}state = StreamingContextState.ACTIVE} catch {case NonFatal(e) =>logError("Error starting the context, marking it as stopped", e)scheduler.stop(false)state = StreamingContextState.STOPPEDthrow e}
eventLoop = new EventLoop[JobSchedulerEvent]("JobScheduler") {override protected def onReceive(event: JobSchedulerEvent): Unit = processEvent(event)override protected def onError(e: Throwable): Unit = reportError("Error in job scheduler", e)}eventLoop.start()// attach rate controllers of input streams to receive batch completion updatesfor {inputDStream <- ssc.graph.getInputStreamsrateController <- inputDStream.rateController} ssc.addStreamingListener(rateController)listenerBus.start()receiverTracker = new ReceiverTracker(ssc)inputInfoTracker = new InputInfoTracker(ssc)executorAllocationManager = ExecutorAllocationManager.createIfEnabled(ssc.sparkContext,receiverTracker,ssc.conf,ssc.graph.batchDuration.milliseconds,clock)executorAllocationManager.foreach(ssc.addStreamingListener)receiverTracker.start()jobGenerator.start()executorAllocationManager.foreach(_.start())logInfo("Started JobScheduler")
private def processEvent(event: JobSchedulerEvent) {try {event match {case JobStarted(job, startTime) => handleJobStart(job, startTime)case JobCompleted(job, completedTime) => handleJobCompletion(job, completedTime)case ErrorReported(m, e) => handleError(m, e)}} catch {case e: Throwable =>reportError("Error in job scheduler", e)}}
   /** Start generation of jobs */

  def start(): Unit = synchronized {

    if (eventLoop != null) return // generator has already been started

    // Call checkpointWriter here to initialize it before eventLoop uses it to avoid a deadlock.

    // See SPARK-10125

    checkpointWriter

    eventLoop = new EventLoop[JobGeneratorEvent]("JobGenerator") {

      override protected def onReceive(event: JobGeneratorEvent): Unit = processEvent(event)

      override protected def onError(e: Throwable): Unit = {

        jobScheduler.reportError("Error in job generator", e)

      }

    }

    eventLoop.start()

    if (ssc.isCheckpointPresent) {

      restart()

    } else {

      startFirstTime()

    }

  }
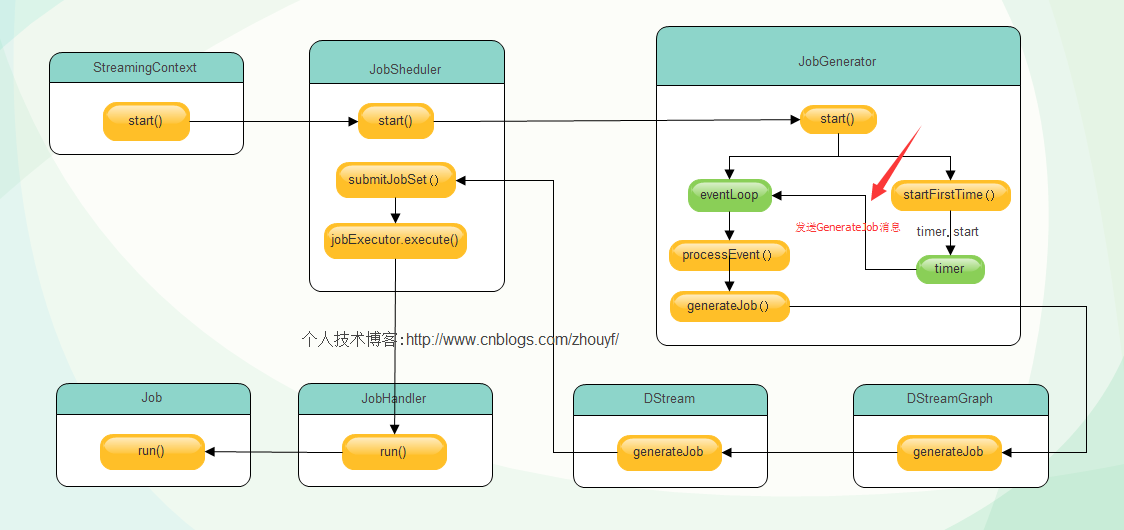
/** Generate jobs and perform checkpoint for the given `time`. */private def generateJobs(time: Time) {// Checkpoint all RDDs marked for checkpointing to ensure their lineages are// truncated periodically. Otherwise, we may run into stack overflows (SPARK-6847).ssc.sparkContext.setLocalProperty(RDD.CHECKPOINT_ALL_MARKED_ANCESTORS, "true")Try {jobScheduler.receiverTracker.allocateBlocksToBatch(time) // allocate received blocks to batchgraph.generateJobs(time) // generate jobs using allocated block} match {case Success(jobs) =>val streamIdToInputInfos = jobScheduler.inputInfoTracker.getInfo(time)jobScheduler.submitJobSet(JobSet(time, jobs, streamIdToInputInfos))case Failure(e) =>jobScheduler.reportError("Error generating jobs for time " + time, e)}eventLoop.post(DoCheckpoint(time, clearCheckpointDataLater = false))}
def generateJobs(time: Time): Seq[Job] = {logDebug("Generating jobs for time " + time)val jobs = this.synchronized {outputStreams.flatMap { outputStream =>val jobOption = outputStream.generateJob(time)jobOption.foreach(_.setCallSite(outputStream.creationSite))jobOption}}logDebug("Generated " + jobs.length + " jobs for time " + time)jobs}
def submitJobSet(jobSet: JobSet) {if (jobSet.jobs.isEmpty) {logInfo("No jobs added for time " + jobSet.time)} else {listenerBus.post(StreamingListenerBatchSubmitted(jobSet.toBatchInfo))jobSets.put(jobSet.time, jobSet)jobSet.jobs.foreach(job => jobExecutor.execute(new JobHandler(job)))logInfo("Added jobs for time " + jobSet.time)}}
Attachment List
6.Spark streaming技术内幕 : Job动态生成原理与源码解析的更多相关文章
- Spark streaming技术内幕6 : Job动态生成原理与源码解析
原创文章,转载请注明:转载自 周岳飞博客(http://www.cnblogs.com/zhouyf/) Spark streaming 程序的运行过程是将DStream的操作转化成RDD的操作,S ...
- Spark技术内幕: Task向Executor提交的源码解析
在上文<Spark技术内幕:Stage划分及提交源码分析>中,我们分析了Stage的生成和提交.但是Stage的提交,只是DAGScheduler完成了对DAG的划分,生成了一个计算拓扑, ...
- 7.spark Streaming 技术内幕 : 从DSteam到RDD全过程解析
原创文章,转载请注明:转载自 听风居士博客(http://www.cnblogs.com/zhouyf/) 上篇博客讨论了Spark Streaming 程序动态生成Job的过程,并留下一个疑问: ...
- Spark技术内幕:Stage划分及提交源码分析
http://blog.csdn.net/anzhsoft/article/details/39859463 当触发一个RDD的action后,以count为例,调用关系如下: org.apache. ...
- 9. Spark Streaming技术内幕 : Receiver在Driver的精妙实现全生命周期彻底研究和思考
原创文章,转载请注明:转载自 听风居士博客(http://www.cnblogs.com/zhouyf/) Spark streaming 程序需要不断接收新数据,然后进行业务逻辑 ...
- JDK1.8 动态代理机制及源码解析
动态代理 a) jdk 动态代理 Proxy, 核心思想:通过实现被代理类的所有接口,生成一个字节码文件后构造一个代理对象,通过持有反射构造被代理类的一个实例,再通过invoke反射调用被代理类实例的 ...
- Spark集群任务提交流程----2.1.0源码解析
Spark的应用程序是通过spark-submit提交到Spark集群上运行的,那么spark-submit到底提交了什么,集群是怎样调度运行的,下面一一详解. 0. spark-submit提交任务 ...
- 贯通Spark Streaming JobScheduler内幕实现和深入思考
本节主要内容: 一.SparkStreaming Job生成深度思考 二.SparkStreaming Job生成源码解析 JobScheduler的地位非常的重要,所有的关键都在JobSchedul ...
- Spark Streaming运行流程及源码解析(一)
本系列主要描述Spark Streaming的运行流程,然后对每个流程的源码分别进行解析 之前总听同事说Spark源码有多么棒,咱也不知道,就是疯狂点头.今天也来撸一下Spark源码. 对Spark的 ...
随机推荐
- [ubuntu]对指定区域截图
ctrl+shift 鼠标变成正十字. 按住右键就可以随意截图了. 设置方法: 打开系统设置面板 system settings --> keyboard --> shortcuts - ...
- UVA 11922 Splay tree
UVA 11922 题意: 有n个数1~n 操作a,b表示取出第a~b个数,翻转后添加到数列的尾部 输入n,m 输入m条指令a,b 输出最终的序列 代码: #include<iostream&g ...
- CentOS 下安装Mplayer播放器(转载)
一.准备工作 需要的安装包及下载地址:1.mplayer源代码包(MPlayer-1.0rc4.tar.bz2)下载:http://www.mplayerhq.hu/MPlayer/releases/ ...
- gulp压缩css和js
压缩 css 代码可降低 css 文件大小,提高页面打开速度. 规律转换为 gulp 代码 找到 css/ 目录下的所有 css 文件,压缩它们,将压缩后的文件存放在 dist/css/ 目录下.一. ...
- java发送邮件(一)
一:前言 一直想做有关java发邮件的功能,但是了一直没有成功,特别的无语啊,所以今天有时间我终于成功了啊,虽然是最简单的,但是还是记载下来吧! 二:内容 这里主要需要的是spring-context ...
- 可以随时拿取spring容器中Bean的工具类
前言 在Spring帮我们管理bean后,编写一些工具类的时候需要从容器中拿到一些对象来做一些操作,比如字典缓存工具类,在没有找到字典缓存时,需要dao对象从数据库load一次,再次存入缓存中.此时需 ...
- Divergent Change(发散式变化)---要重构的信号
“ 当你看着一个类说,呃,如果新加入一个数据库,我必须修改这三个函数:如果新出现一种金融工具,我必须修改这四个函数.那么,此时也许将这个类分成两个会更好,这么一来每个对象就可以只因一种变化而需要修改. ...
- 【Foreign】登山 [DP][数学]
登山 Time Limit: 10 Sec Memory Limit: 256 MB Description 恶梦是一个登山爱好者,今天他来到了黄山 俗话说的好,不走回头路.所以在黄山,你只能往前走 ...
- 「6月雅礼集训 2017 Day11」jump
[题目大意] 有$n$个位置,每个位置有一个数$x_i$,代表从$i$经过1步可以到达的点在$[\max(1, i-x_i), \min(i+x_i, n)]$中. 定义$(i,j)$的距离表示从$i ...
- bzoj 1004 burnside 引理+DP
对于burnside引理需要枚举染色,这道题属于burnside的一种简单求解的方法,就是polya,我们可以使每一种置换中的循环节中的元素的颜色都相同,那么这样的话就可以直接DP了,我们可以将m个置 ...