
7.spark Streaming 技术内幕 : 从DSteam到RDD全过程解析
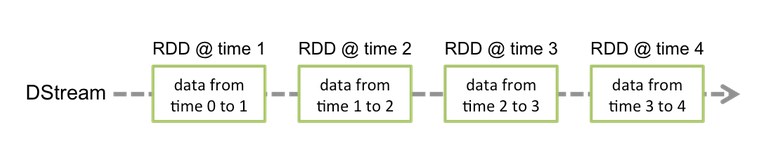
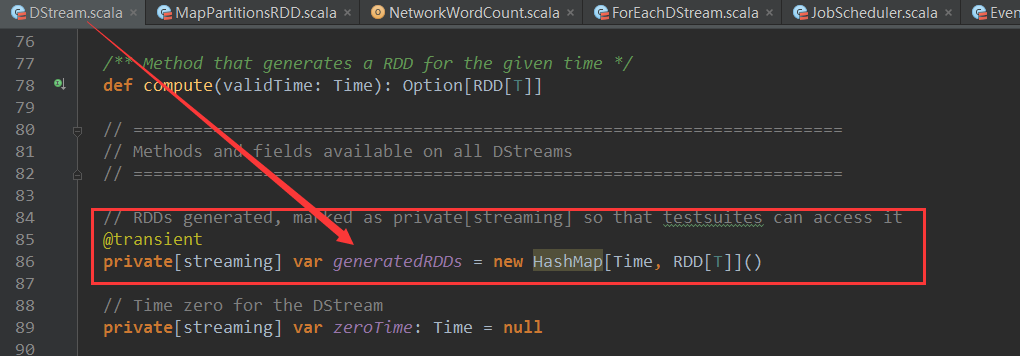
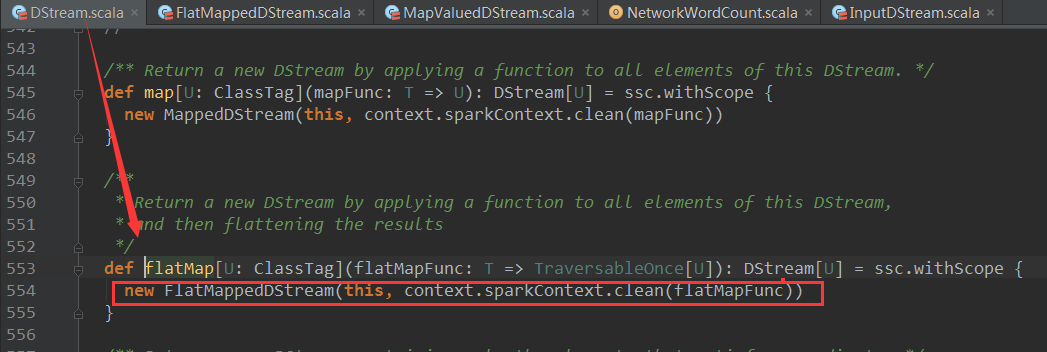
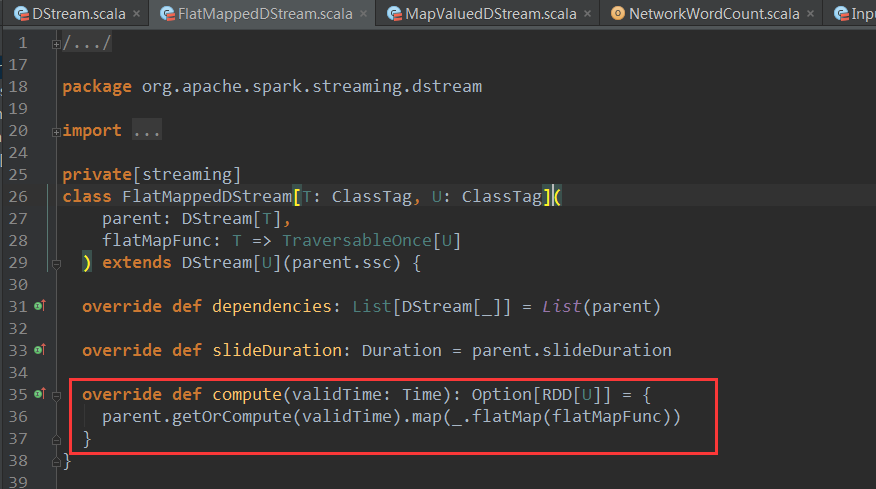
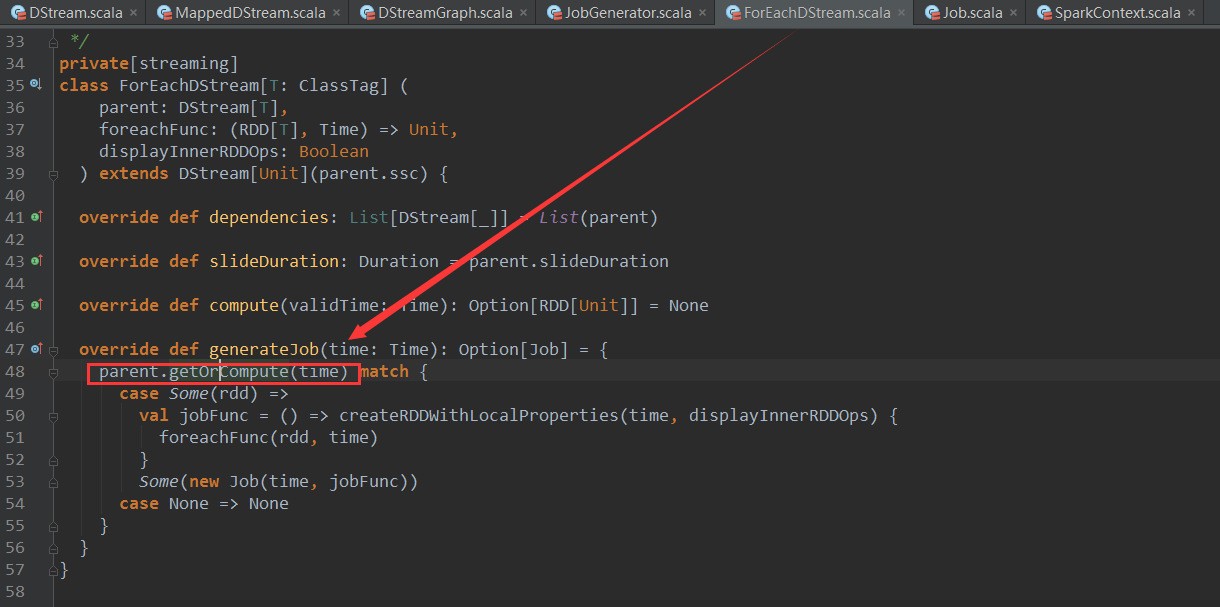
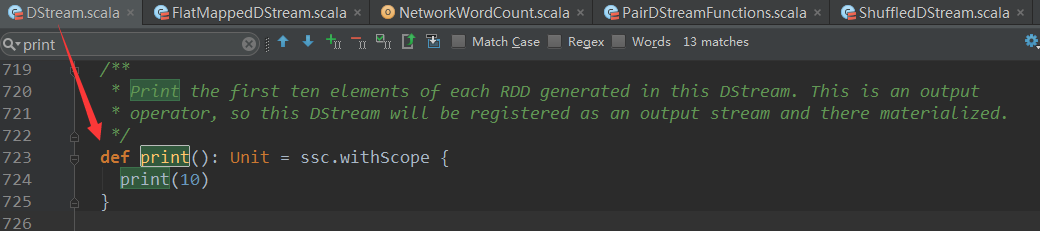
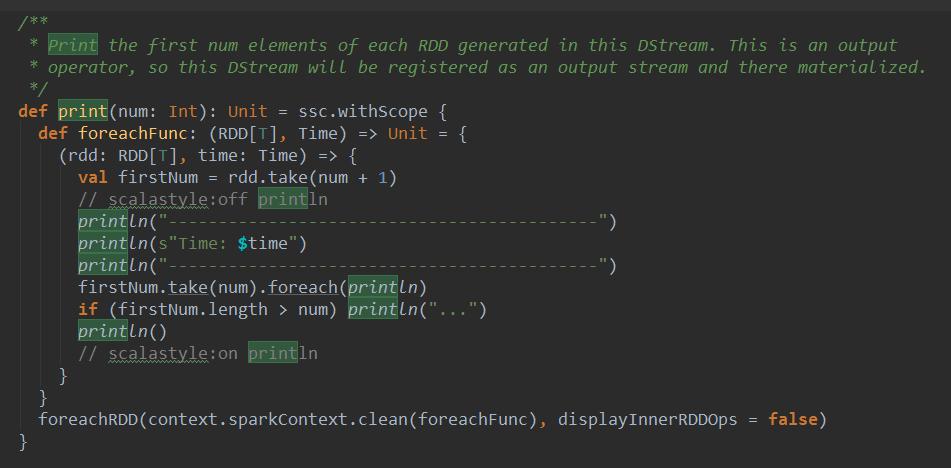
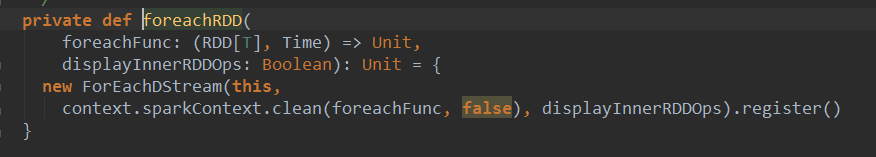
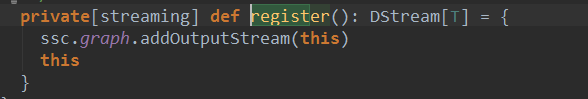
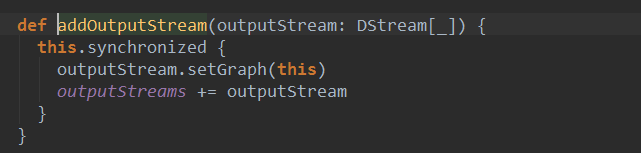
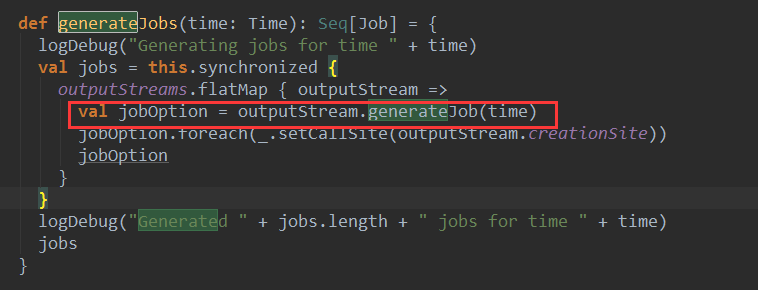
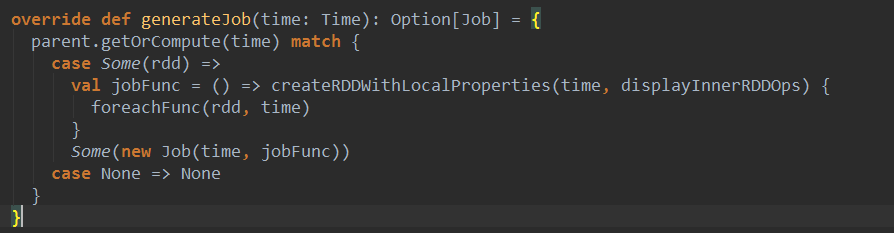
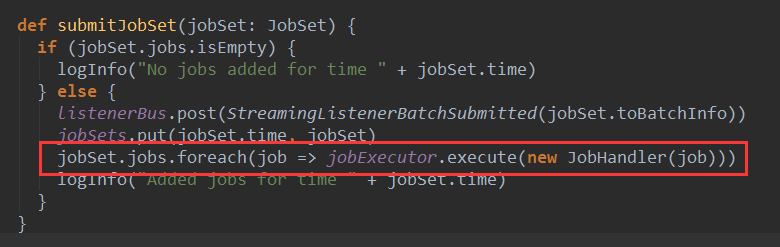
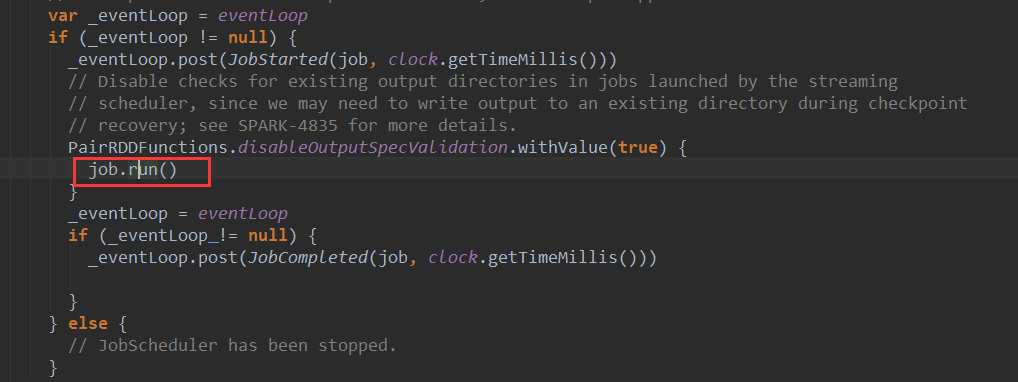
上篇博客讨论了Spark Streaming 程序动态生成Job的过程,并留下一个疑问: JobScheduler将动态生成的Job提交,然后调用了Job对象的run方法,最后run方法的调用是如何触发RDD的Action操作,从而真正触发Job的执行的呢?本文就具体讲解这个问题。
object WordCount{def main(args:Array[String]):Unit={val sparkConf =newSparkConf().setMaster("local[4]").setAppName("WordCount")val ssc =newStreamingContext(sparkConf,Seconds(1))val lines = ssc.socketTextStream("localhost",9999)val words = lines.flatMap(_.split(" "))val wordCounts = words.map(x =>(x,1)).reduceByKey(_+_)wordCounts.print()ssc.start()ssc.awaitTermination()}}



| Output Operation | Meaning |
|---|---|
| print() | Prints the first ten elements of every batch of data in a DStream on the driver node running the streaming application. This is useful for development and debugging. Python API This is called pprint() in the Python API. |
| saveAsTextFiles(prefix, [suffix]) | Save this DStream's contents as text files. The file name at each batch interval is generated based onprefix and suffix: "prefix-TIME_IN_MS[.suffix]". |
| saveAsObjectFiles(prefix, [suffix]) | Save this DStream's contents as SequenceFiles of serialized Java objects. The file name at each batch interval is generated based on prefix and suffix: "prefix-TIME_IN_MS[.suffix]". Python API This is not available in the Python API. |
| saveAsHadoopFiles(prefix, [suffix]) | Save this DStream's contents as Hadoop files. The file name at each batch interval is generated based on prefix and suffix: "prefix-TIME_IN_MS[.suffix]". Python API This is not available in the Python API. |
| foreachRDD(func) | The most generic output operator that applies a function, func, to each RDD generated from the stream. This function should push the data in each RDD to an external system, such as saving the RDD to files, or writing it over the network to a database. Note that the function func is executed in the driver process running the streaming application, and will usually have RDD actions in it that will force the computation of the streaming RDDs. |
7.spark Streaming 技术内幕 : 从DSteam到RDD全过程解析的更多相关文章
- 9. Spark Streaming技术内幕 : Receiver在Driver的精妙实现全生命周期彻底研究和思考
原创文章,转载请注明:转载自 听风居士博客(http://www.cnblogs.com/zhouyf/) Spark streaming 程序需要不断接收新数据,然后进行业务逻辑 ...
- Spark streaming技术内幕6 : Job动态生成原理与源码解析
原创文章,转载请注明:转载自 周岳飞博客(http://www.cnblogs.com/zhouyf/) Spark streaming 程序的运行过程是将DStream的操作转化成RDD的操作,S ...
- 6.Spark streaming技术内幕 : Job动态生成原理与源码解析
原创文章,转载请注明:转载自 周岳飞博客(http://www.cnblogs.com/zhouyf/) Spark streaming 程序的运行过程是将DStream的操作转化成RDD的操作, ...
- 贯通Spark Streaming JobScheduler内幕实现和深入思考
本节主要内容: 一.SparkStreaming Job生成深度思考 二.SparkStreaming Job生成源码解析 JobScheduler的地位非常的重要,所有的关键都在JobSchedul ...
- 16.Spark Streaming源码解读之数据清理机制解析
原创文章,转载请注明:转载自 听风居士博客(http://www.cnblogs.com/zhouyf/) 本期内容: 一.Spark Streaming 数据清理总览 二.Spark Streami ...
- 10.Spark Streaming源码分析:Receiver数据接收全过程详解
原创文章,转载请注明:转载自 听风居士博客(http://www.cnblogs.com/zhouyf/) 在上一篇中介绍了Receiver的整体架构和设计原理,本篇内容主要介绍Receiver在 ...
- Spark技术内幕:Sort Based Shuffle实现解析
在Spark 1.2.0中,Spark Core的一个重要的升级就是将默认的Hash Based Shuffle换成了Sort Based Shuffle,即spark.shuffle.manager ...
- 9.Spark Streaming
Spark Streaming 1 Why Apache Spark 2 关于Apache Spark 3 如何安装Apache Spark 4 Apache Spark的工作原理 5 spark弹性 ...
- Spark Streaming的优化之路—从Receiver到Direct模式
作者:个推数据研发工程师 学长 1 业务背景 随着大数据的快速发展,业务场景越来越复杂,离线式的批处理框架MapReduce已经不能满足业务,大量的场景需要实时的数据处理结果来进行分析.决 ...
随机推荐
- 题解【luogu P2421 bzoj P1407 [NOI2002]荒岛野人】
洛谷题目链接 bzoj题目链接 题目大意:给定\(n\)组\(C_i, P_i, L_i\),求最小的\(M\)使得对于任意的\(i,j (1 \leq i, j \leq n)\) \[C_i + ...
- 002 第一个Python简易游戏
1.初始版本 print('---------------我爱鱼C工作室-------------') temp = input("不妨猜一下小甲鱼现在心里想的是0~10中哪个数字:&quo ...
- Moodle简介
Moodle简介 一.概述 Moodle是Modular Object-Oriented Dynamic Learning Environment(模块化面向对象动态学习环境)的简称,中文译名为魔灯, ...
- session 超时设置
Java Web开发Session超时设置 博客分类: Java Web 在Java Web开发中,Session为我们提供了很多方便,Session是由浏览器和服务器之间维护的.Session超时理 ...
- 【设计模式】 模式PK:代理模式VS装饰模式
1.概述 对于两个模式,首先要说的是,装饰模式就是代理模式的一个特殊应用,两者的共同点是都具有相同的接口,不同点则是代理模式着重对代理过程的控制,而装饰模式则是对类的功能进行加强或减弱,它着重类的功能 ...
- Ubuntu12.04 SVN安装过程
一.安装SVN和配置SVN 1.安装SVN apt-get install subversion 2.创建SVN目录,项目目录和配置文件目录 mkdir /var/svn mkdir /var/svn ...
- 【Foreign】不等式 [数论]
不等式 Time Limit: 10 Sec Memory Limit: 128 MB Description 小z热衷于数学. 今天数学课的内容是解不等式:L<=S*x<=R .小z心 ...
- Html5学习2(Html表格、Html列表、Html5新元素、Canvas (坐标、路径、画圆、文本、渐变、图像))
Html表格 1.表格中的表头:<th></th>.其中表头部分字体加粗,颜色深绿色 <h4>水平标题:</h4> <table border=& ...
- bzoj 2733 平衡树启发式合并
首先对于一个连通块中,询问我们可以直接用平衡树来求出排名,那么我们可以用并查集来维护各个块中的连通情况,对于合并两个平衡树,我们可以暴力的将size小的平衡树中的所有节点删掉,然后加入大的平衡树中,因 ...
- 2017-2018-1 20179205《Linux内核原理与设计》第九周作业
<Linux内核原理与设计>第九周作业 视频学习及代码分析 一.进程调度时机与进程的切换 不同类型的进程有不同的调度需求,第一种分类:I/O-bound 会频繁的进程I/O,通常会花费很多 ...