
Update(Stage4):spark_rdd算子:第2节 RDD_action算子_分区_缓存:缓存、Checkpoint
4. 缓存
缓存的意义
缓存相关的 API
缓存级别以及最佳实践
4.1. 缓存的意义
- 使用缓存的原因 - 多次使用 RDD
-
需求: 在日志文件中找到访问次数最少的 IP 和访问次数最多的 IP
val conf = new SparkConf().setMaster("local[6]").setAppName("debug_string")

val sc = new SparkContext(conf)

val interimRDD = sc.textFile("dataset/access_log_sample.txt")

  .map(item => (item.split(" ")(0), 1))

  .filter(item => StringUtils.isNotBlank(item._1))

  .reduceByKey((curr, agg) => curr + agg)

val resultLess = interimRDD.sortBy(item => item._2, ascending = true).first()

val resultMore = interimRDD.sortBy(item => item._2, ascending = false).first()

println(s"出现次数最少的 IP : $resultLess, 出现次数最多的 IP : $resultMore")

sc.stop()
这是一个 Shuffle 操作, Shuffle 操作会在集群内进行数据拷贝 在上述代码中, 多次使用到了
interimRDD, 导致文件读取两次, 计算两次, 有没有什么办法增进上述代码的性能? - 使用缓存的原因 - 容错
-
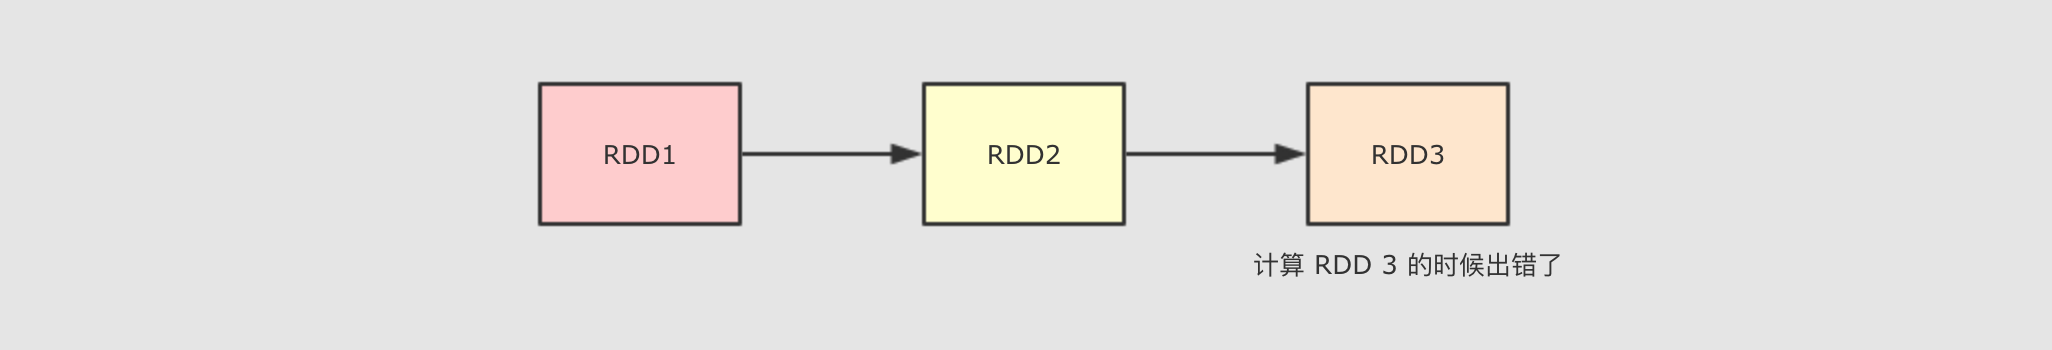
当在计算 RDD3 的时候如果出错了, 会怎么进行容错?
会再次计算 RDD1 和 RDD2 的整个链条, 假设 RDD1 和 RDD2 是通过比较昂贵的操作得来的, 有没有什么办法减少这种开销?
上述两个问题的解决方案其实都是 缓存, 除此之外, 使用缓存的理由还有很多, 但是总结一句, 就是缓存能够帮助开发者在进行一些昂贵操作后, 将其结果保存下来, 以便下次使用无需再次执行, 缓存能够显著的提升性能.
所以, 缓存适合在一个 RDD 需要重复多次利用, 并且还不是特别大的情况下使用, 例如迭代计算等场景.
4.2. 缓存相关的 API
- 可以使用
cache方法进行缓存 -
val conf = new SparkConf().setMaster("local[6]").setAppName("debug_string")

val sc = new SparkContext(conf)

val interimRDD = sc.textFile("dataset/access_log_sample.txt")

  .map(item => (item.split(" ")(0), 1))

  .filter(item => StringUtils.isNotBlank(item._1))

  .reduceByKey((curr, agg) => curr + agg)

  .cache()

val resultLess = interimRDD.sortBy(item => item._2, ascending = true).first()

val resultMore = interimRDD.sortBy(item => item._2, ascending = false).first()

println(s"出现次数最少的 IP : $resultLess, 出现次数最多的 IP : $resultMore")

sc.stop()
缓存 方法签名如下
cache(): this.type = persist()cache 方法其实是
persist方法的一个别名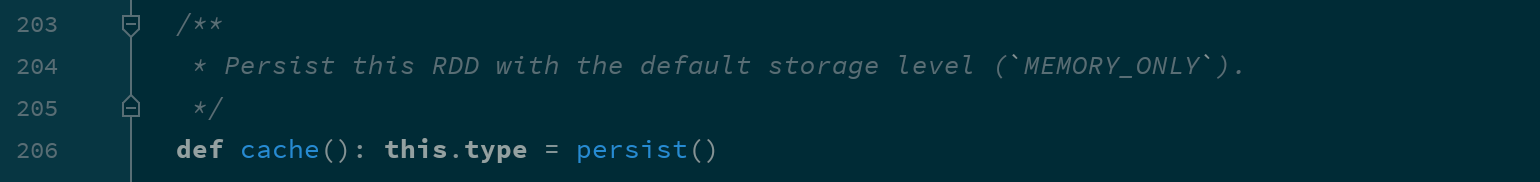
- 也可以使用 persist 方法进行缓存
-
val conf = new SparkConf().setMaster("local[6]").setAppName("debug_string")

val sc = new SparkContext(conf)

val interimRDD = sc.textFile("dataset/access_log_sample.txt")

  .map(item => (item.split(" ")(0), 1))

  .filter(item => StringUtils.isNotBlank(item._1))

  .reduceByKey((curr, agg) => curr + agg)

  .persist(StorageLevel.MEMORY_ONLY)

val resultLess = interimRDD.sortBy(item => item._2, ascending = true).first()

val resultMore = interimRDD.sortBy(item => item._2, ascending = false).first()

println(s"出现次数最少的 IP : $resultLess, 出现次数最多的 IP : $resultMore")

sc.stop()
缓存 方法签名如下
persist(): this.type

persist(newLevel: StorageLevel): this.typepersist方法其实有两种形式,persist()是persist(newLevel: StorageLevel)的一个别名,persist(newLevel: StorageLevel)能够指定缓存的级别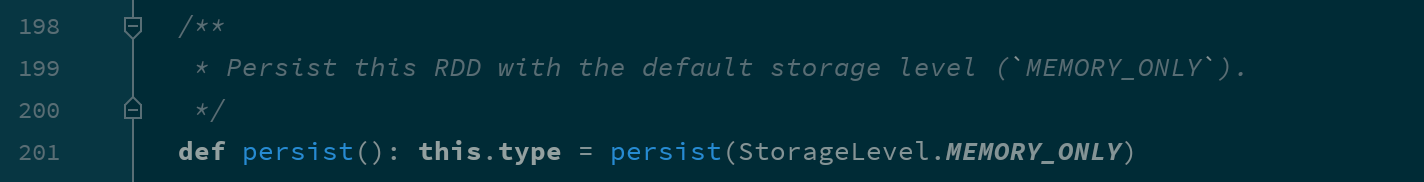
- 缓存其实是一种空间换时间的做法, 会占用额外的存储资源, 如何清理?
-
val conf = new SparkConf().setMaster("local[6]").setAppName("debug_string")

val sc = new SparkContext(conf)

val interimRDD = sc.textFile("dataset/access_log_sample.txt")

  .map(item => (item.split(" ")(0), 1))

  .filter(item => StringUtils.isNotBlank(item._1))

  .reduceByKey((curr, agg) => curr + agg)

  .persist()

interimRDD.unpersist()

val resultLess = interimRDD.sortBy(item => item._2, ascending = true).first()

val resultMore = interimRDD.sortBy(item => item._2, ascending = false).first()

println(s"出现次数最少的 IP : $resultLess, 出现次数最多的 IP : $resultMore")

sc.stop()
清理缓存 根据缓存级别的不同, 缓存存储的位置也不同, 但是使用
unpersist可以指定删除 RDD 对应的缓存信息, 并指定缓存级别为NONE
4.3. 缓存级别
其实如何缓存是一个技术活, 有很多细节需要思考, 如下
是否使用磁盘缓存?
是否使用内存缓存?
是否使用堆外内存?
缓存前是否先序列化?
是否需要有副本?
如果要回答这些信息的话, 可以先查看一下 RDD 的缓存级别对象
val conf = new SparkConf().setMaster("local[6]").setAppName("debug_string")

val sc = new SparkContext(conf)

val interimRDD = sc.textFile("dataset/access_log_sample.txt")

  .map(item => (item.split(" ")(0), 1))

  .filter(item => StringUtils.isNotBlank(item._1))

  .reduceByKey((curr, agg) => curr + agg)

  .persist()

println(interimRDD.getStorageLevel)

sc.stop()
打印出来的对象是 StorageLevel, 其中有如下几个构造参数
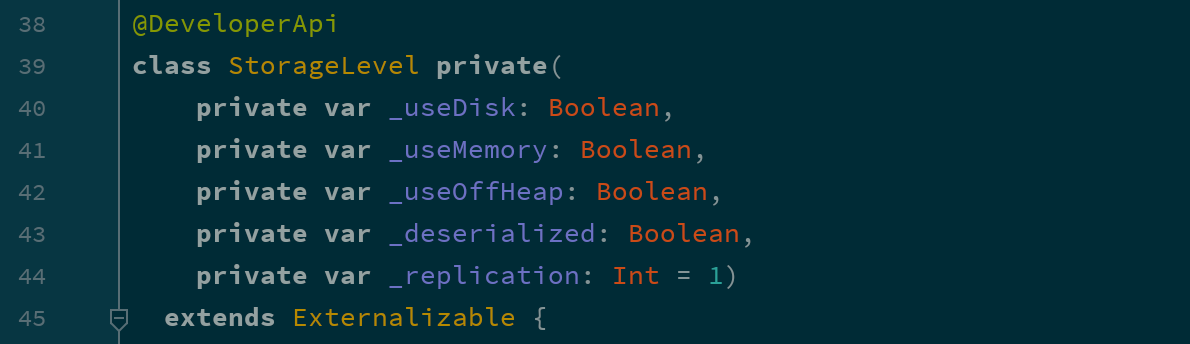
根据这几个参数的不同, StorageLevel 有如下几个枚举对象
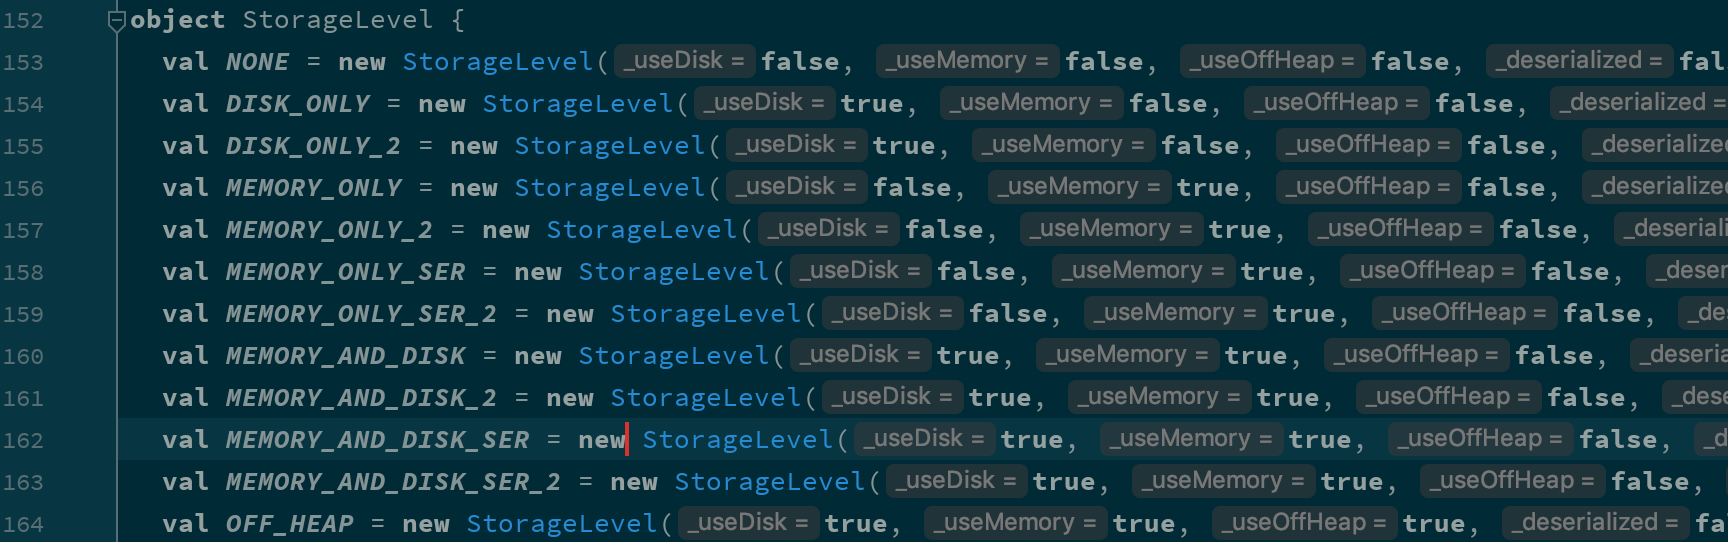
| 缓存级别 | userDisk 是否使用磁盘 |
useMemory 是否使用内存 |
useOffHeap 是否使用堆外内存 |
deserialized是否以反序列化形式存储 |
replication 副本数 |
|---|---|---|---|---|---|
|
|
false |
false |
false |
false |
1 |
|
|
true |
false |
false |
false |
1 |
|
|
true |
false |
false |
false |
2 |
|
|
false |
true |
false |
true |
1 |
|
|
false |
true |
false |
true |
2 |
|
|
false |
true |
false |
false |
1 |
|
|
false |
true |
false |
false |
2 |
|
|
true |
true |
false |
true |
1 |
|
|
true |
true |
false |
true |
2 |
|
|
true |
true |
false |
false |
1 |
|
|
true |
true |
false |
false |
2 |
|
|
true |
true |
true |
false |
1 |
Spark 的存储级别的选择,核心问题是在 memory 内存使用率和 CPU 效率之间进行权衡。建议按下面的过程进行存储级别的选择:
如果您的 RDD 适合于默认存储级别(MEMORY_ONLY),leave them that way。这是 CPU 效率最高的选项,允许 RDD 上的操作尽可能快地运行.
如果不是,试着使用 MEMORY_ONLY_SER 和 selecting a fast serialization library 以使对象更加节省空间,但仍然能够快速访问。(Java和Scala)
不要溢出到磁盘,除非计算您的数据集的函数是昂贵的,或者它们过滤大量的数据。否则,重新计算分区可能与从磁盘读取分区一样快.
如果需要快速故障恢复,请使用复制的存储级别(例如,如果使用 Spark 来服务 来自网络应用程序的请求)。All 存储级别通过重新计算丢失的数据来提供完整的容错能力,但复制的数据可让您继续在 RDD 上运行任务,而无需等待重新计算一个丢失的分区.
5. Checkpoint
Checkpoint 的作用
Checkpoint 的使用
5.1. Checkpoint 的作用
Checkpoint 的主要作用是斩断 RDD 的依赖链, 并且将数据存储在可靠的存储引擎中, 例如支持分布式存储和副本机制的 HDFS.
- Checkpoint 的方式
-
可靠的 将数据存储在可靠的存储引擎中, 例如 HDFS
本地的 将数据存储在本地
- 什么是斩断依赖链
-
斩断依赖链是一个非常重要的操作, 接下来以 HDFS 的 NameNode 的原理来举例说明
HDFS 的 NameNode 中主要职责就是维护两个文件, 一个叫做
edits, 另外一个叫做fsimage.edits中主要存放EditLog,FsImage保存了当前系统中所有目录和文件的信息. 这个FsImage其实就是一个Checkpoint.HDFS 的 NameNode 维护这两个文件的主要过程是, 首先, 会由
fsimage文件记录当前系统某个时间点的完整数据, 自此之后的数据并不是时刻写入fsimage, 而是将操作记录存储在edits文件中. 其次, 在一定的触发条件下,edits会将自身合并进入fsimage. 最后生成新的fsimage文件,edits重置, 从新记录这次fsimage以后的操作日志.如果不合并
edits进入fsimage会怎样? 会导致edits中记录的日志过长, 容易出错.所以当 Spark 的一个 Job 执行流程过长的时候, 也需要这样的一个斩断依赖链的过程, 使得接下来的计算轻装上阵.
- Checkpoint 和 Cache 的区别
-
Cache 可以把 RDD 计算出来然后放在内存中, 但是 RDD 的依赖链(相当于 NameNode 中的 Edits 日志)是不能丢掉的, 因为这种缓存是不可靠的, 如果出现了一些错误(例如 Executor 宕机), 这个 RDD 的容错就只能通过回溯依赖链, 重放计算出来.
但是 Checkpoint 把结果保存在 HDFS 这类存储中, 就是可靠的了, 所以可以斩断依赖, 如果出错了, 则通过复制 HDFS 中的文件来实现容错.
所以他们的区别主要在以下两点
Checkpoint 可以保存数据到 HDFS 这类可靠的存储上, Persist 和 Cache 只能保存在本地的磁盘和内存中
Checkpoint 可以斩断 RDD 的依赖链, 而 Persist 和 Cache 不行
因为 CheckpointRDD 没有向上的依赖链, 所以程序结束后依然存在, 不会被删除. 而 Cache 和 Persist 会在程序结束后立刻被清除.
5.2. 使用 Checkpoint
val conf = new SparkConf().setMaster("local[6]").setAppName("debug_string")

val sc = new SparkContext(conf)

sc.setCheckpointDir("checkpoint")

val interimRDD = sc.textFile("dataset/access_log_sample.txt")

  .map(item => (item.split(" ")(0), 1))

  .filter(item => StringUtils.isNotBlank(item._1))

  .reduceByKey((curr, agg) => curr + agg)

interimRDD.checkpoint()

interimRDD.collect().foreach(println(_))

sc.stop()
1)在使用 Checkpoint 之前需要先设置 Checkpoint 的存储路径, 而且如果任务在集群中运行的话,这个路径必须是 HDFS 上的路径
2)开启 Checkpoint
一个小细节:
val interimRDD = sc.textFile("dataset/access_log_sample.txt")
.map(item => (item.split(" ")(0), 1))
.filter(item => StringUtils.isNotBlank(item._1))
.reduceByKey((curr, agg) => curr + agg)
.cache()
interimRDD.checkpoint()
interimRDD.collect().foreach(println(_))
checkpoint 之前先 cache 一下, 准没错
应该在 checkpoint 之前先 cache 一下, 因为 checkpoint 会重新计算整个 RDD 的数据然后再存入 HDFS 等地方.
所以上述代码中如果 checkpoint 之前没有 cache, 则整个流程会被计算两次, 一次是 checkpoint, 另外一次是 collect。
Update(Stage4):spark_rdd算子:第2节 RDD_action算子_分区_缓存:缓存、Checkpoint的更多相关文章
- Update(Stage4):spark_rdd算子:第2节 RDD_action算子_分区_缓存:算子和分区
一.reduce和reduceByKey: 二.:RDD 的算子总结 RDD 的算子大部分都会生成一些专用的 RDD map, flatMap, filter 等算子会生成 MapPartitions ...
- Update(Stage4):Structured Streaming_介绍_案例
1. 回顾和展望 1.1. Spark 编程模型的进化过程 1.2. Spark 的 序列化 的进化过程 1.3. Spark Streaming 和 Structured Streaming 2. ...
- Update(Stage4):Spark原理_运行过程_高级特性
如何判断宽窄依赖: =================================== 6. Spark 底层逻辑 导读 从部署图了解 Spark 部署了什么, 有什么组件运行在集群中 通过对 W ...
- halcon基础算子介绍(窗口创建,算子运行时长,是否启用更新函数)
前言 halcon有有大约1500个算子,我总结一些简单大家用得到的算子,比如创建窗口的方式有3种,接下来结束这方式,及其异同点等! 1.窗口创建的三种方式 1.1使用dev_open_window算 ...
- Update(Stage4):spark_rdd算子:第1节 RDD_定义_转换算子:深入RDD
一. 二.案例:详见代码.针对案例提出的6个问题: 假设要针对整个网站的历史数据进行处理, 量有 1T, 如何处理? 放在集群中, 利用集群多台计算机来并行处理 如何放在集群中运行? 简单来讲, 并行 ...
- Update(Stage4):sparksql:第3节 Dataset (DataFrame) 的基础操作 & 第4节 SparkSQL_聚合操作_连接操作
8. Dataset (DataFrame) 的基础操作 8.1. 有类型操作 8.2. 无类型转换 8.5. Column 对象 9. 缺失值处理 10. 聚合 11. 连接 8. Dataset ...
- Update(Stage4):sparksql:第1节 SparkSQL_使用场景_优化器_Dataset & 第2节 SparkSQL读写_hive_mysql_案例
目标 SparkSQL 是什么 SparkSQL 如何使用 Table of Contents 1. SparkSQL 是什么 1.1. SparkSQL 的出现契机 1.2. SparkSQL 的适 ...
- Update(Stage4):sparksql:第5节 SparkSQL_出租车利用率分析案例
目录: 1. 业务2. 流程分析3. 数据读取5. 数据清洗6. 行政区信息 6.1. 需求介绍 6.2. 工具介绍 6.3. 具体实现7. 会话统计 导读 本项目是 SparkSQL 阶段的练习项目 ...
- Update(Stage4):Spark Streaming原理_运行过程_高级特性
Spark Streaming 导读 介绍 入门 原理 操作 Table of Contents 1. Spark Streaming 介绍 2. Spark Streaming 入门 2. 原理 3 ...
随机推荐
- 基于原生PHP的路由分配实现
对于由原生PHP写成的独立PHP框架,利用单一入口文件实现路径的访问.这时我们会遇到的首要问题是:文件的相互包含,其次就是路由分配.当我们不利用成熟的PHP框架进行web开发时,我们就会发现上述两个问 ...
- 让ul li 或者table 进行循环往上滚屏
转载:https://blog.csdn.net/u012138137/article/details/80729789 <div style="display:inline" ...
- Nuxt的默认模板和默认布局
Nuxt为我们提供了超简单的默认模版订制方法,只要在根目录下创建一个app.html就可以实现了 注:建立了默认模板后,记得要重启服务器,否则你的显示不会成功 默认布局主要针对于页面的统一布局使用.它 ...
- FromBase64String 输入的不是有效的 Base-64 字符串,因为它包含非 Base-64 字符、两个以上的填充字符,或者填充字符间包含非法字符
js前台: <input id="upload_img_input" v-on:change="onFileChange" type="file ...
- shim是什么?
Vue响应式原理中说道:Object.defineProperty是Es5中无法shim的特性,那么这里的shim是什么呢? shim可以将新的API引入到旧的环境中,而且仅靠就环境中已有的手段实现. ...
- 远程传输文件命令:scp
1.概述 scp(secure copy)是一个基于 SSH 协议在网络之间进行安全传输的命令,其格式为“scp [参数] 本地文件 远程帐户@远程 IP 地址:远程目录”. 与第 2 章讲解的 cp ...
- 一个c程序的执行是从什么开始的?
一个C语言的执行是从本程序的main函数开始,到main函数结束,但需要注意的是,也是有特殊情况的,若是代码中出现了exit函数,则直接结束程序,对于这一点还是需要了解的. 关于c语言需要了解的是,C ...
- 每天进步一点点------入门视频采集与处理(显示YUV数据)
做视频采集与处理,自然少不了要学会分析YUV数据.因为从采集的角度来说,一般的视频采集芯片输出的码流一般都是YUV数据流的形式,而从视频处理(例如H.264.MPEG视频编解码)的角度来说,也是在原始 ...
- Linux挂载(mount,umount及开机自动挂载
挂载概念简述: 根文件系统之外的其他文件要想能够被访问,都必须通过“关联”至根文件系统上的某个目录来实现,此关联操作即为“挂载”,此目录即为“挂载点”,解除此关联关系的过程称之为“卸载” 1.挂载:根 ...
- tomcat使用中的笔记
1.修改tomcat命令窗口的名字 平时在使用tomcat的时候,经常会在一台机器上启动多个tomcat,但是默认的情况下启动多个就不好区分对应启动了什么应用,这时我们就可以通过修改tomcat窗口名 ...