
第十四篇:Apriori 关联分析算法原理分析与代码实现
前言
想必大家都听过数据挖掘领域那个经典的故事 - "啤酒与尿布" 的故事。
那么,具体是怎么从海量销售信息中挖掘出啤酒和尿布之间的关系呢?
这就是关联分析所要完成的任务了。
本文将讲解关联分析领域中最为经典的Apriori算法,并给出具体的代码实现。
关联分析领域的一些概念
1. 频繁项集: 数据集中经常出现在一起的物品的集合。例如 "啤酒和尿布"
2. 关联规则: 指两个物品集之间可能存在很强的关系。例如 "{啤酒} -> {尿布}" 就是一条关联规则。
3. 支持度: 数据集中,出现了某个物品集的数据项占总数据项的比重(某些地方也解释为次数)。
4. 可信度: 这个概念是针对某条关联规则而定的。它是指两个物品集的支持度和其中某个物品集的支持度之比,如 "支持度{啤酒,尿布} / 支持度{尿布}"。
因此,用这些属于来解释啤酒与尿布的故事,那就是:{啤酒,尿布}是一个频繁项集;"{啤酒} -> {尿布}" 就是一条关联规则;顾客买尿布的同时买啤酒的可能性为 "支持度{啤酒,尿布} / 支持度{尿布}"。
那么对海量的数据,假如要得到支持度大于0.8的所有频繁项集,该怎么做?
如果用蛮力法一个个统计,是根本不现实的,那样计算量实在太大。
本文将要介绍的Apriori关联分析算法意义就在于能够大幅度减少这种情况的计算量,并从频繁项集中高效检索出关联规则,从而大大减少关联规则学习所需要消耗的计算量。
Apriori算法基本原理
如果{0,1}是频繁项集,那么{0}和{1}也都是频繁项集。
这显然是正确的命题。
其逆否命题 - ”如果{0}和{1}不都是频繁项集,那么{0,1}不是频繁项集" 自然也是正确的。-> 这就是 Apriori 算法的核心思想之一。
这样,一旦发现某个集合不是频繁项集,那么它的所有超集也都不是频繁项集,就不用浪费功夫去对它们进行检索了。
检索出频繁项集之后,接下来检索出所有合乎要求的关联规则。
如果某条规则不满足最小可信度要求,那么该规则的所有子集也不会满足。 -> 这是 Apriori 算法的核心思想的另一部分。
PS:这里务必思考清楚规则是怎么划分的,什么叫某个规则的子集。
这样,和上一步同理,也能高效的从频繁项集中检索出关联规则了。
具体实现将分为频繁集检索和关联规则学习两个部分进行讲解。
频繁项集检索实现思路与实现代码
一种经典的实现方法是 "分级法":
算法框架是在两个大的步骤 - 筛选/过滤之间不断迭代,直到所有情况分析完毕。
每次筛选的结果都要指定元素个数的情况,因此所谓分级,也就是依次讨论指定元素个数情况的项集。
在筛选之后,就是过滤。
过滤有两层意义,一个是项集必须在数据集中存在。这是第一层过滤;还有一层过滤,是指支持度过滤。只有满足支持度要求的项集才能保存下来。
过滤之后,基于过滤集再进行筛选,每次筛选的元素个数都比上一次筛选的元素个数多一个。
然后继续过滤。如此反复,直到最后一次筛选过滤完成。
伪代码实现:
 当集合中项的个数大于0时:

     构建一个 k 个项组成的候选项集的列表

     检查数据以确认每个项集都是频繁的

     保留频繁项集并构建 k+ 项组成的候选项集列表
其中检查每个项集是否频繁部分的伪代码:
 对数据集中的每条交易记录:

     对每个候选集元素:

         检查是否为数据集元素,是才保留。

 对每个数据集

     如果支持度达到要求才保留

 返回过滤后的频繁项集 - 也即过滤集
Python实现及测试代码:
 def loadDataSet():

     '返回测试数据'

     return [[1, 3, 4], [2, 3, 5], [1, 2, 3, 5], [2, 5]]

 #===================================

 # 输入:

 #        dataSet: 数据集

 # 输出:

 #        map(frozenset, C1): 候选集

 #===================================

 def createC1(dataSet):

     '创建候选集'

     C1 = []

     for transaction in dataSet:

         for item in transaction:

             if not [item] in C1:

                 C1.append([item])

     C1.sort()

     # 返回的集合元素都是frozenset类型 -> 因为以后要用来做键。

     return map(frozenset, C1)

 #=============================================

 # 输入:

 #        D: 数据集 (set格式)

 #        Ck: 候选集

 #        minSupport: 最小支持度

 # 输出:

 #        retList: 过滤集

 #        supportData: 支持集(挖掘关联规则时使用)

 #=============================================

 def scanD(D, Ck, minSupport):

     '由候选集得到过滤集'

     # 统计候选元素出现的次数

     ssCnt = {}

     for tid in D:

         for can in Ck:

             if can.issubset(tid):

                 if not ssCnt.has_key(can): ssCnt[can]=1

                 else: ssCnt[can] += 1

     # 构建过滤集和支持集

     numItems = float(len(D))

     retList = []

     supportData = {}

     for key in ssCnt:

         support = ssCnt[key]/numItems

         if support >= minSupport:

             retList.insert(0,key)

         supportData[key] = support

     return retList, supportData

 #===================================

 # 输入:

 #        Lk: 过滤集

 #        k: 当前项集元素个数

 # 输出:

 #        retList: 候选集

 #===================================

 def aprioriGen(Lk, k):

     '由过滤集得到候选集'

     # 重组过滤集,得到新的候选集。

     retList = []

     lenLk = len(Lk)

     for i in range(lenLk):

         for j in range(i+1, lenLk):

             # 留意下重组技巧

             L1 = list(Lk[i])[:k-2]; L2 = list(Lk[j])[:k-2]

             L1.sort();

             L2.sort()

             if L1==L2:

                 retList.append(Lk[i] | Lk[j])

     return retList

 #=============================================

 # 输入:

 #        dataSet: 数据集

 #        minSupport: 最小支持度

 # 输出:

 #        L: 频繁集

 #        supportData: 支持集(挖掘关联规则时使用)

 #=============================================

 def apriori(dataSet, minSupport = 0.5):

     '求频繁项集及其对应支持度'

     C1 = createC1(dataSet)

     D = map(set, dataSet)

     L1, supportData = scanD(D, C1, minSupport)

     L = [L1]

     k = 2

     while (len(L[k-2]) > 0):

         Ck = aprioriGen(L[k-2], k)

         Lk, supK = scanD(D, Ck, minSupport)

         supportData.update(supK)

         L.append(Lk)

         k += 1

     return L, supportData

 def main():

     'Apriori频繁集检索'

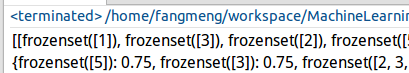
     L, s = apriori (loadDataSet())

     print L

     print s
测试结果:
关联规则学习实现思路与实现代码
上一部分的工作是从数据集中检索出频繁集;而这一部分是根据频繁集学习关联规则。
上一部分的工作是通过筛选集中的元素个数进行分级;而这一部分是针对规则右部的元素个数进行分级。
另外还要注意,只用检索单个频繁集之内的关联规则就可以了。
实现代码:
 #===================================

 # 输入:

 #        L: 频繁集

 #        supportData: 支持集

 #        minConf: 最小可信度

 # 输出:

 #        bigRuleList: 规则集

 #===================================

 def generateRules(L, supportData, minConf=0.7):

     '从某个频繁集中学习关联规则'

     bigRuleList = []

     for i in range(1, len(L)):

         for freqSet in L[i]:

             H1 = [frozenset([item]) for item in freqSet]

             if (i > 1):

                 rulesFromConseq(freqSet, H1, supportData, bigRuleList, minConf)

             else:

                 calcConf(freqSet, H1, supportData, bigRuleList, minConf)

     return bigRuleList

 #===================================

 # 输入:

 #        L: 频繁集

 #        supportData: 支持集

 #        minConf: 最小可信度

 # 输出:

 #        bigRuleList: 规则集

 #===================================

 def calcConf(freqSet, H, supportData, brl, minConf=0.7):

     '可信度过滤'

     prunedH = []

     for conseq in H:

         conf = supportData[freqSet]/supportData[freqSet-conseq]

         if conf >= minConf:

             brl.append((freqSet-conseq, conseq, conf))

             prunedH.append(conseq)

     return prunedH

 def rulesFromConseq(freqSet, H, supportData, brl, minConf=0.7):

     '从某个频繁项集中学习关联规则'

     # 本次学习的规则右部中的元素个数

     m = len(H[0])

     if (len(freqSet) > (m + 1)):

         # 重组规则右部

         Hmp1 = aprioriGen(H, m+1)

         # 规则学习

         Hmp1 = calcConf(freqSet, Hmp1, supportData, brl, minConf)

         if (len(Hmp1) > 1):

             # 递归学习函数

             rulesFromConseq(freqSet, Hmp1, supportData, brl, minConf)

 def main():

     '关联规则学习'

     L, s = apriori (loadDataSet())

     rules = generateRules(L, s)

     print rules
测试结果:

测试数据为: [[1, 3, 4], [2, 3, 5], [1, 2, 3, 5], [2, 5]]。
结果的意思也就是说:1->3,5->2,2->5 的概率为 1。
显然这是和预计相吻合的。
小结
1. Apriori关联算法在网络购物网站中用的非常多,可以基于此算法搭建商品推荐系统。
2. 但Apriori算法也有一个缺点,那就是频繁集的检索速度还是不够快,因为每级都要重新检索一遍候选集(虽然候选集越来越小)。
3. 针对 2 中的问题,下篇文章将介绍一个更为强大的发现频繁集的算法 - FP-growth。(PS:但它不能用来发现关联规则)
第十四篇:Apriori 关联分析算法原理分析与代码实现的更多相关文章
- Apriori 关联分析算法原理分析与代码实现
前言 想必大家都听过数据挖掘领域那个经典的故事 - "啤酒与尿布" 的故事. 那么,具体是怎么从海量销售信息中挖掘出啤酒和尿布之间的关系呢? 这就是关联分析所要完成的任务了. 本文 ...
- 大数据之路【第十四篇】:数据挖掘--推荐算法(Mahout工具)
数据挖掘---推荐算法(Mahout工具) 一.简介 Apache顶级项目(2010.4) Hadoop上的开源机器学习库 可伸缩扩展的 Java库 推荐引擎(协同过滤).聚类和分类 二.机器学习介绍 ...
- 第十三篇:K-Means 聚类算法原理分析与代码实现
前言 在前面的文章中,涉及到的机器学习算法均为监督学习算法. 所谓监督学习,就是有训练过程的学习.再确切点,就是有 "分类标签集" 的学习. 现在开始,将进入到非监督学习领域.从经 ...
- Egret入门学习日记 --- 第十四篇(书中 5.4~5.6节 内容)
第十四篇(书中 5.4~5.6节 内容) 书中内容: 总结 5.4节 内容重点: 1.如何编写自定义组件? 跟着做: 重点1:如何编写自定义组件? 文中提到了重要的两点. 好,我们来试试看. 第一步, ...
- Spring Cloud第十四篇 | Api网关Zuul
本文是Spring Cloud专栏的第十四篇文章,了解前十三篇文章内容有助于更好的理解本文: Spring Cloud第一篇 | Spring Cloud前言及其常用组件介绍概览 Spring C ...
- 解剖SQLSERVER 第十四篇 Vardecimals 存储格式揭秘(译)
解剖SQLSERVER 第十四篇 Vardecimals 存储格式揭秘(译) http://improve.dk/how-are-vardecimals-stored/ 在这篇文章,我将深入研究 ...
- 第十四篇 Integration Services:项目转换
本篇文章是Integration Services系列的第十四篇,详细内容请参考原文. 简介在前一篇,我们查看了SSIS变量,变量配置和表达式管理动态值.在这一篇,我们使用SQL Server数据商业 ...
- Python之路【第十四篇】:AngularJS --暂无内容-待更新
Python之路[第十四篇]:AngularJS --暂无内容-待更新
- 【译】第十四篇 Integration Services:项目转换
本篇文章是Integration Services系列的第十四篇,详细内容请参考原文. 简介在前一篇,我们查看了SSIS变量,变量配置和表达式管理动态值.在这一篇,我们使用SQL Server数据商业 ...
随机推荐
- 【转帖】阿里金融云:分布式服务注册中心(DSR)
https://www.cloud.alipay.com/docs/middleware/register/index.html 分布式服务注册中心(DSR) 分布式服务注册中心简介 服务注册中心 ( ...
- php连接sql2005
连接前配置系统: 1.检查文件 php5.2.5/ntwdblib.dll 默认下面有一个,不能连接再替换. 下载正确版本的 ntwdblib.dll (2000.80.194.0),地址: http ...
- 我的Android进阶之旅------>Android系统设置默认来电铃声、闹钟铃声、通知铃声
首先了解Android系统本身提供的默认铃声文件,这些文件都放在 /system/media/audio 文件夹下. /system/media/audio/ringtones 系统来电铃声 ...
- AutoFac文档11(转载)
目录 开始 Registering components 控制范围和生命周期 用模块结构化Autofac xml配置 与.net集成 深入理解Autofac 指导 关于 词汇表 元数据 Autofac ...
- servlet响应解析
response对象可以设置一些响应信息 1)设置状态码 response.setStatus(int) 2)设置响应头信息.定时刷新或者间隔 n 秒后跳转 response.setHeader(&q ...
- API 版本控制的几种方式
个人建议:用content type,即放在Header里面!比如加一个Version:1.4.3 这篇文章写得很好,介绍了三种实现web api版本化的三种方式.我从评论里又收集到两种方式,所以一共 ...
- Jquery easyUI datagrid载入复杂JSON数据方法
1.JSON数据为: { "total":28, "rows": [ { "itemNo": "1&q ...
- 小米手机解锁bootload教程及常见问题
小米手机解锁bl需要在官网提交申请,然后电脑解锁,具体步骤如下: 1.首先需要注册一个小米账号,并登陆. 2.到官网解锁网页提交申请:http://www.miui.com/unlock/index. ...
- cxf动态调用webservice设置超时,测试线程安全
Java代码 import java.util.Random; import java.util.concurrent.ArrayBlockingQueue; import java.util.con ...
- zookeeper是如何选取主leader的?
以一个简单的例子来说明整个选举的过程.假设有五台服务器组成的zookeeper集群,它们的id从1-5,同时它们都是最新启动的,也就是没有历史数据,在存放数据量这一点上,都是一样的.假设这些服务器依序 ...