
第十三篇:K-Means 聚类算法原理分析与代码实现
前言
在前面的文章中,涉及到的机器学习算法均为监督学习算法。
所谓监督学习,就是有训练过程的学习。再确切点,就是有 "分类标签集" 的学习。
现在开始,将进入到非监督学习领域。从经典的聚类问题展开讨论。所谓聚类,就是事先并不知道具体分类方案的分类 (允许知道分类个数)。
本文将介绍一个最为经典的聚类算法 - K-Means 聚类算法以及它的两种实现。
现实中的聚类分析问题 - 总统大选
假设 M 国又开始全民选举总统了,目前 Mr.OBM 的投票率为48%(投票数占所有选民人数的百分比),而 Mr.MKN 的为47%,而剩下的一部分出于【种种原因】没有投票。
做为其中某个阵营的人,自然是希望能够尽可能的争取到这些剩余的票 -因为这完全可能影响最终选举结果。
然而,你不可能争取到这些人的所有投票,因为你满足某个群体的人,也许就伤害到了另一群人的利益。
一个很不错的想法是将这些人分为 K 个群体,然后主要对其中人数最多的几个群体做工作。
-- 这,就需要使用到聚类的策略了。
聚类策略是搜集剩余选民的用户信息(各种满意/不满意的信息),将这些信息输入进聚类算法,然后对聚类结果中人数最多的簇的选民做思想工作。
可能你会发现某个簇的选民都是一个社区的,一个宗教信仰的,或者具有某些共性。这样就方便各种各样的拉票活动了。
K-Means 聚类算法
K,指的是它可以发现 K 个簇;Means,指的是簇中心采用簇所含的值的均值来计算。
下面先给出伪代码:
 创建 k 个点作为起始质心 (随机选择):

     当任意一个点的簇分配结果发生改变的时候:

         对数据集中的每个数据点:

             对每个质心:

                 计算质心与数据点之间的距离

             将数据点分配到距其最近的簇

         对每一个簇:

             求出均值并将其更新为质心
然后是一个具体实现Python程序:
 #!/usr/bin/env python

 # -*- coding:UTF-8 -*-

 '''

 Created on 20**-**-**

 @author: fangmeng

 '''

 from numpy import *

 #==================================

 # 输入:

 #        fileName: 数据文件名(含路径)

 # 输出:

 #        dataMat: 数据集

 #==================================

 def loadDataSet(fileName):

     '载入数据文件'

     dataMat = []

     fr = open(fileName)

     for line in fr.readlines():

         curLine = line.strip().split('\t')

         fltLine = map(float,curLine)

         dataMat.append(fltLine)

     return dataMat

 #==================================================

 # 输入:

 #        vecA: 样本a

 #        vecB: 样本b

 # 输出:

 #        sqrt(sum(power(vecA - vecB, 2))): 样本距离

 #==================================================

 def distEclud(vecA, vecB):

     '计算样本距离'

     return sqrt(sum(power(vecA - vecB, 2)))

 #===========================================

 # 输入:

 #        dataSet: 数据集

 #        k: 簇个数

 # 输出:

 #        centroids: 簇划分集合(每个元素为簇质心)

 #===========================================

 def randCent(dataSet, k):

     '随机初始化质心'

     n = shape(dataSet)[1]

     centroids = mat(zeros((k,n)))#create centroid mat

     for j in range(n):#create random cluster centers, within bounds of each dimension

         minJ = min(dataSet[:,j])

         rangeJ = float(max(dataSet[:,j]) - minJ)

         centroids[:,j] = mat(minJ + rangeJ * random.rand(k,1))

     return centroids

 #===========================================

 # 输入:

 #        dataSet: 数据集

 #        k: 簇个数

 #        distMeas: 距离生成器

 #        createCent: 质心生成器

 # 输出:

 #        centroids: 簇划分集合(每个元素为簇质心)

 #        clusterAssment: 聚类结果

 #===========================================

 def kMeans(dataSet, k, distMeas=distEclud, createCent=randCent):

     'K-Means基本实现'

     m = shape(dataSet)[0]

     # 簇分配结果矩阵。一列为簇分类结果,一列为误差。

     clusterAssment = mat(zeros((m,2)))

     # 创建原始质心集

     centroids = createCent(dataSet, k)

     # 簇更改标记

     clusterChanged = True

     while clusterChanged:

         clusterChanged = False

         # 每个样本点加入其最近的簇。

         for i in range(m):

             minDist = inf; minIndex = -1

             for j in range(k):

                 distJI = distMeas(centroids[j,:],dataSet[i,:])

                 if distJI < minDist:

                     minDist = distJI; minIndex = j

             if clusterAssment[i,0] != minIndex: clusterChanged = True

             clusterAssment[i,:] = minIndex,minDist**2

         # 更新簇

         for cent in range(k):#recalculate centroids

             ptsInClust = dataSet[nonzero(clusterAssment[:,0].A==cent)[0]]

             centroids[cent,:] = mean(ptsInClust, axis=0)

     return centroids, clusterAssment

 def main():

     'k-Means聚类操作展示'

     datMat = mat(loadDataSet('/home/fangmeng/testSet.txt'))

     myCentroids, clustAssing = kMeans(datMat, 4)

     #print myCentroids

     print clustAssing

 if __name__ == "__main__":

    main()
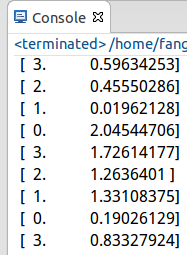
测试结果:
K-Means性能优化
主要有两种方式:
1. 分解最大SSE (误差平方和)的簇。
PS:直接在簇内执行一次 k=2 的 K-Means 聚类即可。
2. 合并距离最小的簇 或者 合并SSE增幅最小的两个簇。
基于这两种最基本优化策略,有一种更为科学的聚类算法 - 二分K-Means算法,下面进行详细介绍。
二分K-Means算法
该算法大致思路为:首先将所有的点作为一个簇,然后将该簇一分为二。之后选择其中一个簇继续划分。
选择方法自然是选择SSE增加更小的那个方式。
如此不断 "裂变",直到得到用户指定数目的簇。
伪代码:
 将所有点视为一个簇:

     当簇数目小于k时:

         对于每一个簇:

             计算SSE

             在给定的簇上面进行 k= 的K-Means聚类

             计算将簇一分为二后的SSE

         选择使得误差最小的那个簇进行划分操作
具体实现函数:
 #======================================

 # 输入:

 #        dataSet: 数据集

 #        k: 簇个数

 #        distMeas: 距离生成器

 # 输出:

 #        mat(centList): 簇划分集合(每个元素为簇质心)

 #        clusterAssment: 聚类结果

 #======================================

 def biKmeans(dataSet, k, distMeas=distEclud):

     '二分K-Means聚类算法'

     m = shape(dataSet)[0]

     # 聚类结果数据结构

     clusterAssment = mat(zeros((m,2)))

     # 原始质心

     centroid0 = mean(dataSet, axis=0).tolist()[0]

     centList =[centroid0]

     # 统计原始SSE

     for j in range(m):

         clusterAssment[j,1] = distMeas(mat(centroid0), dataSet[j,:])**2

     # 循环执行直到得到k个簇

     while (len(centList) < k):

         # 最小SSE

         lowestSSE = inf

         # 找到最适合分裂的簇进行分裂

         for i in range(len(centList)):

             ptsInCurrCluster = dataSet[nonzero(clusterAssment[:,0].A==i)[0],:]

             centroidMat, splitClustAss = kMeans(ptsInCurrCluster, 2, distMeas)

             sseSplit = sum(splitClustAss[:,1])

             sseNotSplit = sum(clusterAssment[nonzero(clusterAssment[:,0].A!=i)[0],1])

             if (sseSplit + sseNotSplit) < lowestSSE:

                 bestCentToSplit = i

                 bestNewCents = centroidMat

                 bestClustAss = splitClustAss.copy()

                 lowestSSE = sseSplit + sseNotSplit

         # 本次划分信息

         bestClustAss[nonzero(bestClustAss[:,0].A == 1)[0],0] = len(centList)

         bestClustAss[nonzero(bestClustAss[:,0].A == 0)[0],0] = bestCentToSplit

         # 更新簇集

         centList[bestCentToSplit] = bestNewCents[0,:].tolist()[0]

         centList.append(bestNewCents[1,:].tolist()[0])

         # 更新聚类结果集

         clusterAssment[nonzero(clusterAssment[:,0].A == bestCentToSplit)[0],:]= bestClustAss

     return mat(centList), clusterAssment
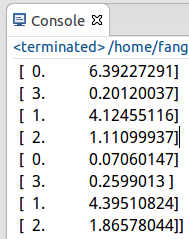
测试结果:
小结
1. KMeans的用途很广泛,再举个例子吧:比如你计划要去中国100个城市旅游,那么如何规划路线呢?
---> 可以采用聚类的方法,将这些城市聚到几个簇里面,然后一个 ”簇"一个 "簇" 的进行游玩。质心就相当于机场,误差平方和就相当于游玩城市到质心的距离 :)
2. KMeans算法是很常用的聚类算法,然而,这里也要提一提它的缺点:初始质心及K值的指定对结果影响较大。这个话题也衍生出很多研究论文,有兴趣的读者可以进一步研究。
第十三篇:K-Means 聚类算法原理分析与代码实现的更多相关文章
- K-Means 聚类算法原理分析与代码实现
前言 在前面的文章中,涉及到的机器学习算法均为监督学习算法. 所谓监督学习,就是有训练过程的学习.再确切点,就是有 "分类标签集" 的学习. 现在开始,将进入到非监督学习领域.从经 ...
- 【机器学习】:Kmeans均值聚类算法原理(附带Python代码实现)
这个算法中文名为k均值聚类算法,首先我们在二维的特殊条件下讨论其实现的过程,方便大家理解. 第一步.随机生成质心 由于这是一个无监督学习的算法,因此我们首先在一个二维的坐标轴下随机给定一堆点,并随即给 ...
- 第一篇:K-近邻分类算法原理分析与代码实现
前言 本文介绍机器学习分类算法中的K-近邻算法并给出伪代码与Python代码实现. 算法原理 首先获取训练集中与目标对象距离最近的k个对象,然后再获取这k个对象的分类标签,求出其中出现频数最大的标签. ...
- 第七篇:Logistic回归分类算法原理分析与代码实现
前言 本文将介绍机器学习分类算法中的Logistic回归分类算法并给出伪代码,Python代码实现. (说明:从本文开始,将接触到最优化算法相关的学习.旨在将这些最优化的算法用于训练出一个非线性的函数 ...
- Logistic回归分类算法原理分析与代码实现
前言 本文将介绍机器学习分类算法中的Logistic回归分类算法并给出伪代码,Python代码实现. (说明:从本文开始,将接触到最优化算法相关的学习.旨在将这些最优化的算法用于训练出一个非线性的函数 ...
- 第十四篇:Apriori 关联分析算法原理分析与代码实现
前言 想必大家都听过数据挖掘领域那个经典的故事 - "啤酒与尿布" 的故事. 那么,具体是怎么从海量销售信息中挖掘出啤酒和尿布之间的关系呢? 这就是关联分析所要完成的任务了. 本文 ...
- Apriori 关联分析算法原理分析与代码实现
前言 想必大家都听过数据挖掘领域那个经典的故事 - "啤酒与尿布" 的故事. 那么,具体是怎么从海量销售信息中挖掘出啤酒和尿布之间的关系呢? 这就是关联分析所要完成的任务了. 本文 ...
- Kmeans聚类算法原理与实现
Kmeans聚类算法 1 Kmeans聚类算法的基本原理 K-means算法是最为经典的基于划分的聚类方法,是十大经典数据挖掘算法之一.K-means算法的基本思想是:以空间中k个点为中心进行聚类,对 ...
- 【转】K-Means聚类算法原理及实现
k-means 聚类算法原理: 1.从包含多个数据点的数据集 D 中随机取 k 个点,作为 k 个簇的各自的中心. 2.分别计算剩下的点到 k 个簇中心的相异度,将这些元素分别划归到相异度最低的簇.两 ...
随机推荐
- Oracle忘记密码找回
生活中,容易忘记Oracle数据库system用户的密码,怎么办呢,小生带你一步步重新登上Oracle ,及时你密码忘记了. 1.打开cmd窗口,输入 sqlplus / as sysdba 2.运行 ...
- bcdedit的研究
首先说明下引导: 微软在Vista之前的系统,采用的是Ntldr来进行引导系统,使用的是boot.ini文件. 在目前的Vista和win7中,采用的是新的引导方式Windows Boot Manag ...
- Unity3D 使用XML进行简单的配置文件改动
1.首先是看看效果图: 開始执行项目例如以下图所看到的 watermark/2/text/aHR0cDovL2Jsb2cuY3Nkbi5uZXQvd2NsdW9qaWpp/font/5a6L5L2T/ ...
- Atitit.软件gui按钮and面板---os区-----linux windows搜索文件 文件夹
Atitit.软件gui按钮and面板---os区-----搜索文件 1. Find 1 2. 寻找目录 1 3. 2. Locate// everything 1 4. 3. Whereis (wi ...
- Nginx 1.5.2 + PHP 5.5.1 + MySQL 5.6.10 在 CentOS 下的编译安装
最近配置了几台Web服务器,将安装笔记贴出来吧.没时间像以前那样,将文章写的那样系统了,请见谅.详细配置,可以看以前的旧文章: http://blog.zyan.cc/nginx_php_v6 .安装 ...
- UITableView__cell 距tableview顶端有间距
UITableView__cell 距tableview顶端有间距 如何去掉这个间距呢?解决方法如下: //top 为cell距顶端的间距 (一般为负值) self.formTable.con ...
- malloc,我误解你了
malloc用于动态申请内存,这个学过C语言的都知道.忘记了在哪本书上看到,malloc申请的内存不一定是连续,于是一直记住了.这句话有错吗?没有!但是当时只是记住了这个知识点,而没有深入的思考.直到 ...
- Windows Phone实用教程:利用Blend为程序添加设计时数据
[前言] Blend自诞生那一天起就伴随这开发者如此的评价: 有VS还用Blend干啥,直接码代码就好了. Blend会生成一堆垃圾无用代码,很不爽. 对于这类我只会在心里评价,当你并不真正了解一样事 ...
- UCOS2系统内核讲述(二)_初始化调用函数
Ⅰ.写在前面 学习本文之前可以参看我前面的文章: UCOS2_STM32F1移植详细过程(汇总文章) UCOS2系统内核讲述(一)_总体描述 还是按照上一篇文章的思维(从外到内),本文(结合源代码)进 ...
- UASCO Wormholes 解析 and C 语言实现
题目大意: 农场有N个洞(2<=N<=12,N为偶数),且组成N/2个连接对.每一个洞的给出平面坐标(x,y). 假设A和B相连,则进入A会从B出来,进入B会从A出来.有仅仅会沿着x轴正方 ...