
【python爬虫实战】用python爬取爱奇艺电视剧十大榜单的全部数据!
一、爬取目标
本次爬取的目标是,爱奇艺电视剧类目下的10个榜单:电视剧风云榜-爱奇艺风云榜
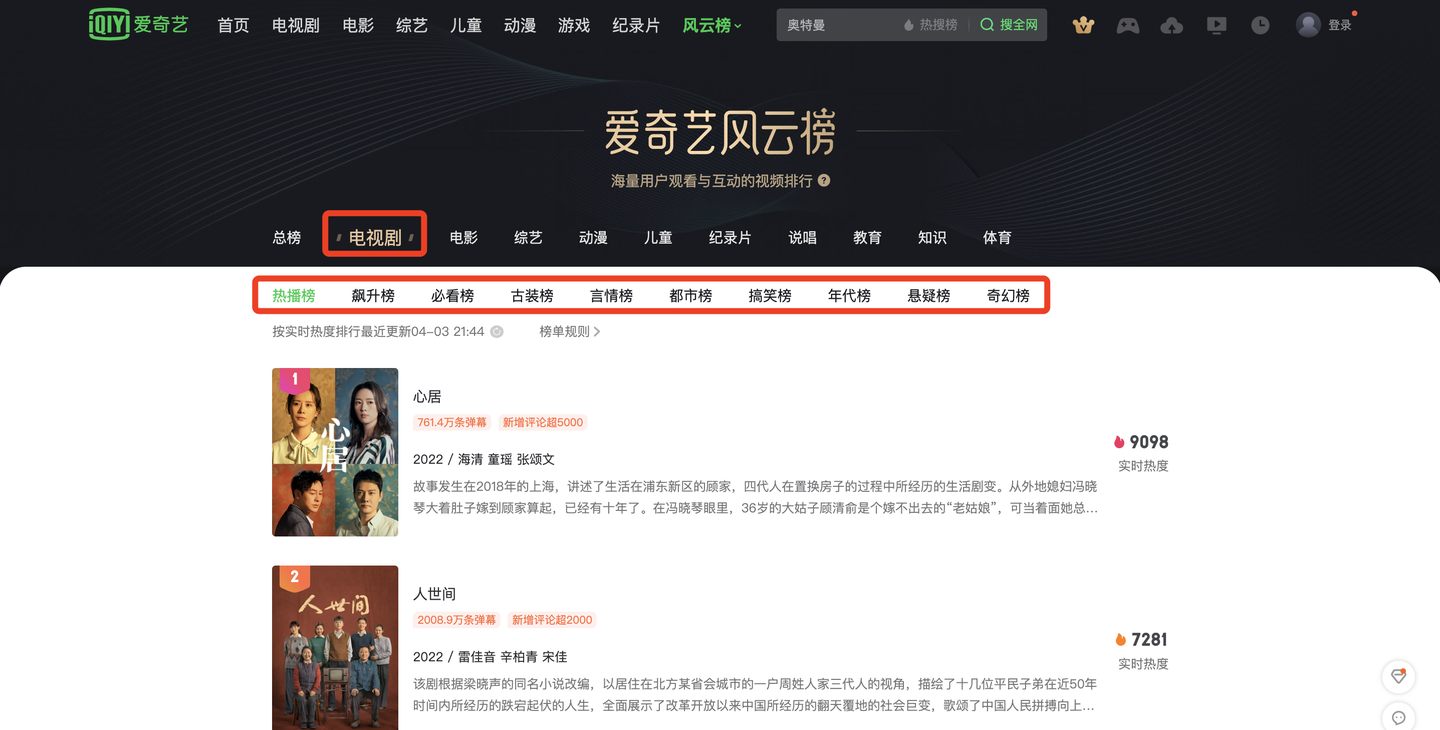
可以看到,这10个榜单包含了:
热播榜、飙升榜、必看榜、古装榜、言情榜、都市榜、搞笑榜、年代榜、悬疑榜、奇幻榜。
我们以热播榜为例,打开Chrome浏览器,按F12进入开发者模式,选择网络 -> XHR这个选项,重新刷新一下页面,并且逐次下拉页面到最底部,展现出全部100部电视剧:
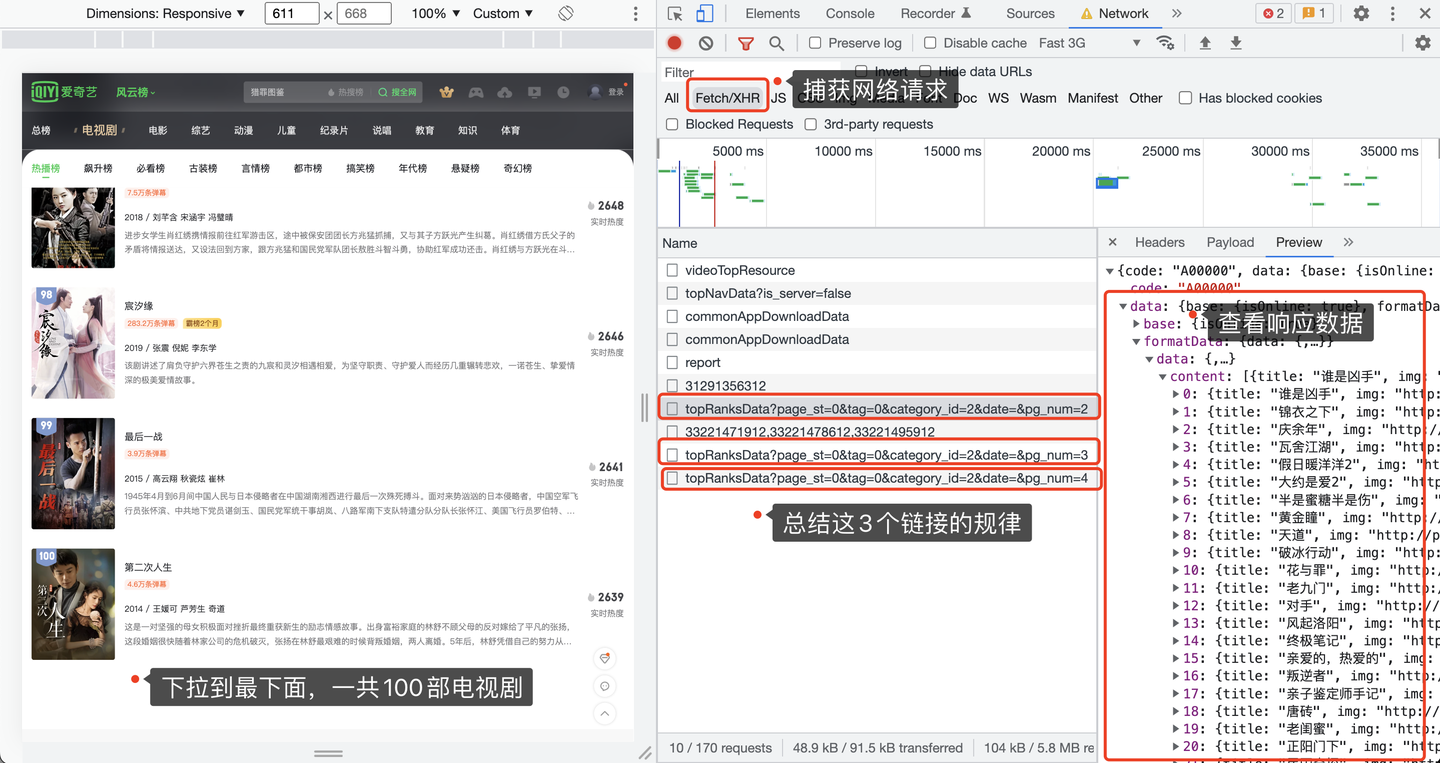
查看捕获到的请求链接地址,每翻一次页,出现一条链接地址,并且该地址的响应数据就是20条电视剧的数据。
所以,这个地址就是我们要请求的地址了。
二、讲解代码
首先,导入需要用到的爬虫库:
import requests  # 发送请求

import pandas as pd  # 存入excel文件

from time import sleep  # 随机等待,防止反爬

import random  # 设置随机
从请求地址的Request Header处,拷贝过来一个请求头,放到代码里:
headers = {

	'accept': 'application/json, text/plain, */*',

	'accept-encoding': 'gzip, deflate, br',

	'accept-language': 'zh-CN,zh;q=0.9,en-US;q=0.8,en;q=0.7',

	'origin': 'https://www.iqiyi.com',

	'referer': 'https://www.iqiyi.com/',

	'sec-ch-ua': '" Not A;Brand";v="99", "Chromium";v="100", "Google Chrome";v="100"',

	'sec-ch-ua-mobile': '?1',

	'sec-ch-ua-platform': '"Android"',

	'sec-fetch-dest': 'empty',

	'sec-fetch-mode': 'cors',

	'sec-fetch-site': 'same-site',

	'user-agent': 'Mozilla/5.0 (Linux; Android 6.0; Nexus 5 Build/MRA58N) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/100.0.4896.60 Mobile Safari/537.36'

}
爱奇艺的这个榜单页面,反爬不那么厉害,请求头中连cookie都不用加!
由于我想自动爬取这10个榜单,每个榜单对应一个tag标签,从哪里获取呢?经过分析,是从另外一个请求地址返回的:
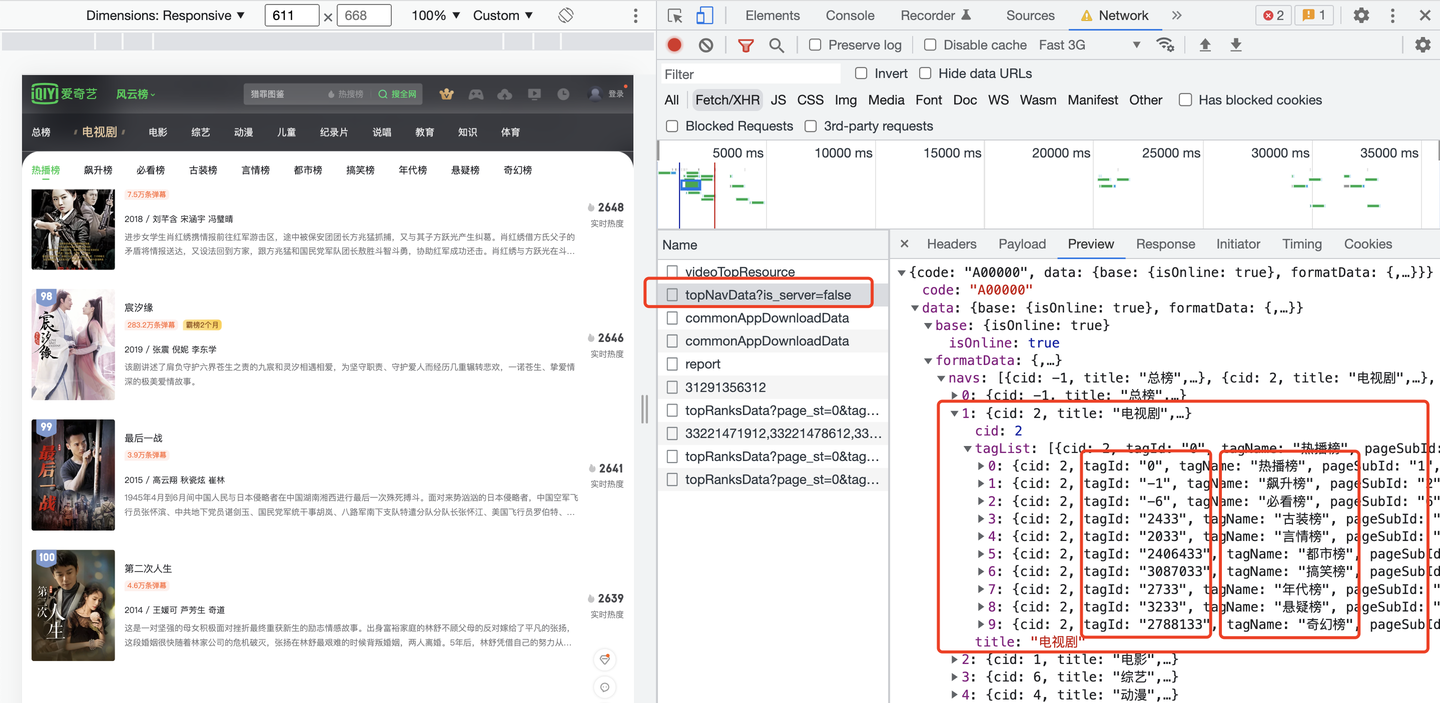
发现了吗?每个榜单名称是一个tagName,对应一个tagId。拿到tagId,带入到榜单数据的请求地址中:
for page in range(1, 5):

	url = 'https://pcw-api.iqiyi.com/strategy/pcw/data/topRanksData?page_st={}&tag={}&category_id=2&date=&pg_num={}'.format(v_tag_id, v_tag_id, page)

	r = requests.get(url, headers=headers)
这样,就完成了向页面发送请求的过程。
顺便说一下这个for循环,一共翻4页,每页25条数据,对应一共100部电视剧。
用json格式接收返回的数据:
json_data = r.json()
然后开始解析json数据:
content_list = json_data['data']['formatData']['data']['content']

for content in content_list:

	# 排名

	order_list.append(order)

	# 标题

	title_list.append(content['title'])

	print(order, ' ', content['title'])

	# 描述

	try:

		desc_list.append(content['desc'])

	except:

		desc_list.append('')

	# 标签

	tags_list.append(content['tags'])

	tag_info = content['tags'].split(' / ')

	# 上映年份

	year = tag_info[0]

	year_list.append(year)

	# 主演

	actor = tag_info[-1]

	actor_list.append(actor)

	# 弹幕

	try:

		danmu_list.append(content['danmu'].replace('条弹幕', ''))

	except:

		danmu_list.append('')

	# 霸榜

	try:

		babang_list.append(content['babang'])

	except:

		babang_list.append('')

	# 实时热度

	if v_tag_name == '飙升榜':

		index_list.append(content['index'] + '%')

	else:

		index_list.append(content['index'])

	order += 1
最后,依然采用我最顺手的方法,拼装成DataFrame的格式,保存到excel文件:
df = pd.DataFrame({

		'排名': order_list,

		'标题': title_list,

		'描述': desc_list,

		'标签': tags_list,

		'上映年份': year_list,

		'主演': actor_list,

		'弹幕': danmu_list,

		'霸榜': babang_list,

		'实时热度': index_list,

	})

if v_tag_name == '飙升榜':  # 如果是飙升榜,把excel标题中的'实时热度'改为'飙升幅度'

	df.rename(columns={'实时热度': '飙升幅度'}, inplace=True)

df.to_excel('爱奇艺电视剧_{}.xlsx'.format(v_tag_name), index=False)
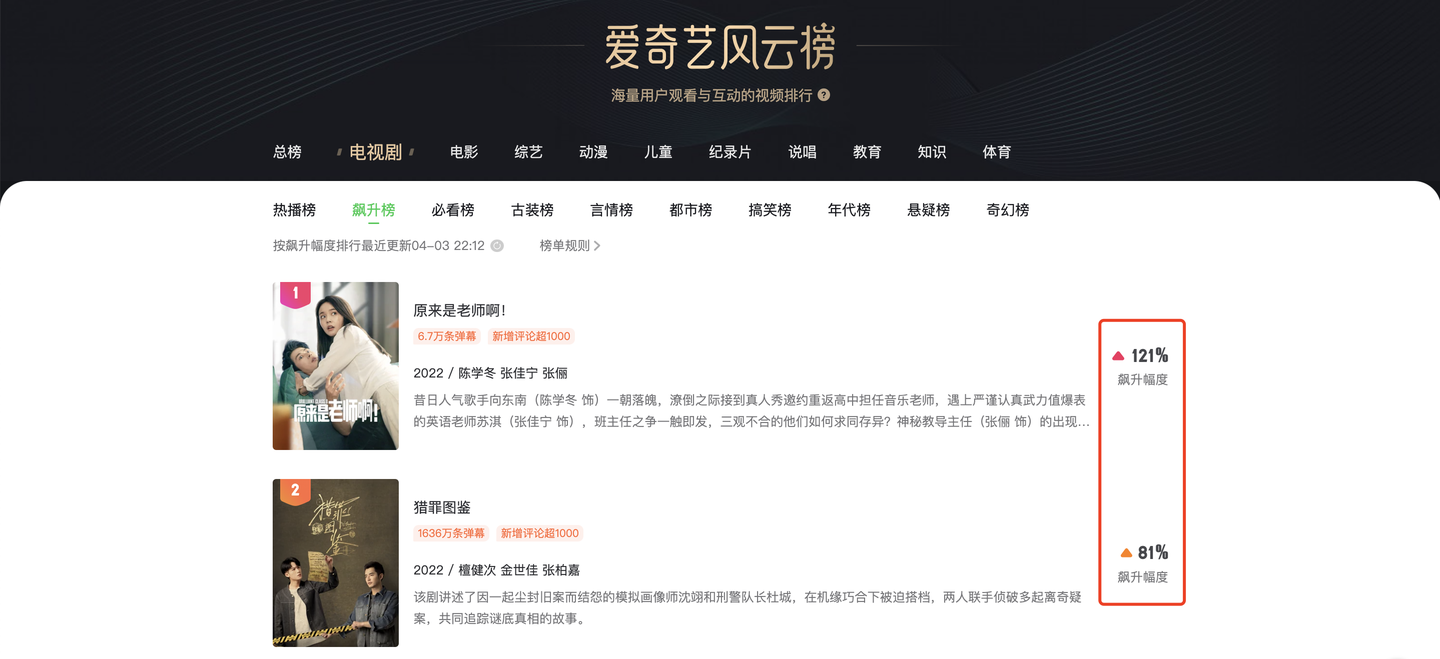
这里,需要注意一个小逻辑,飙升榜的'实时热度'需要rename为'飙升幅度',因为飙升榜跟其他榜单不一样!
三、查看结果
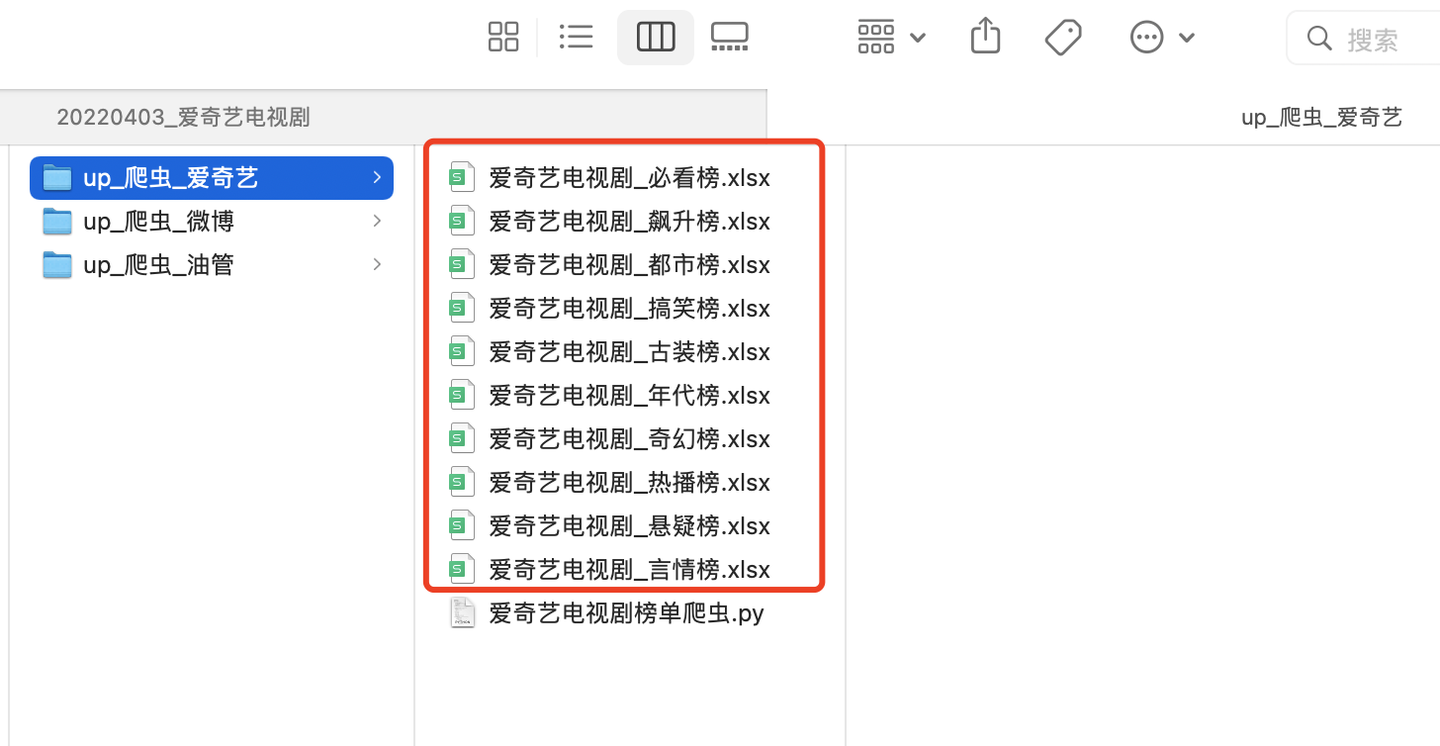
共爬取到10个榜单文件:
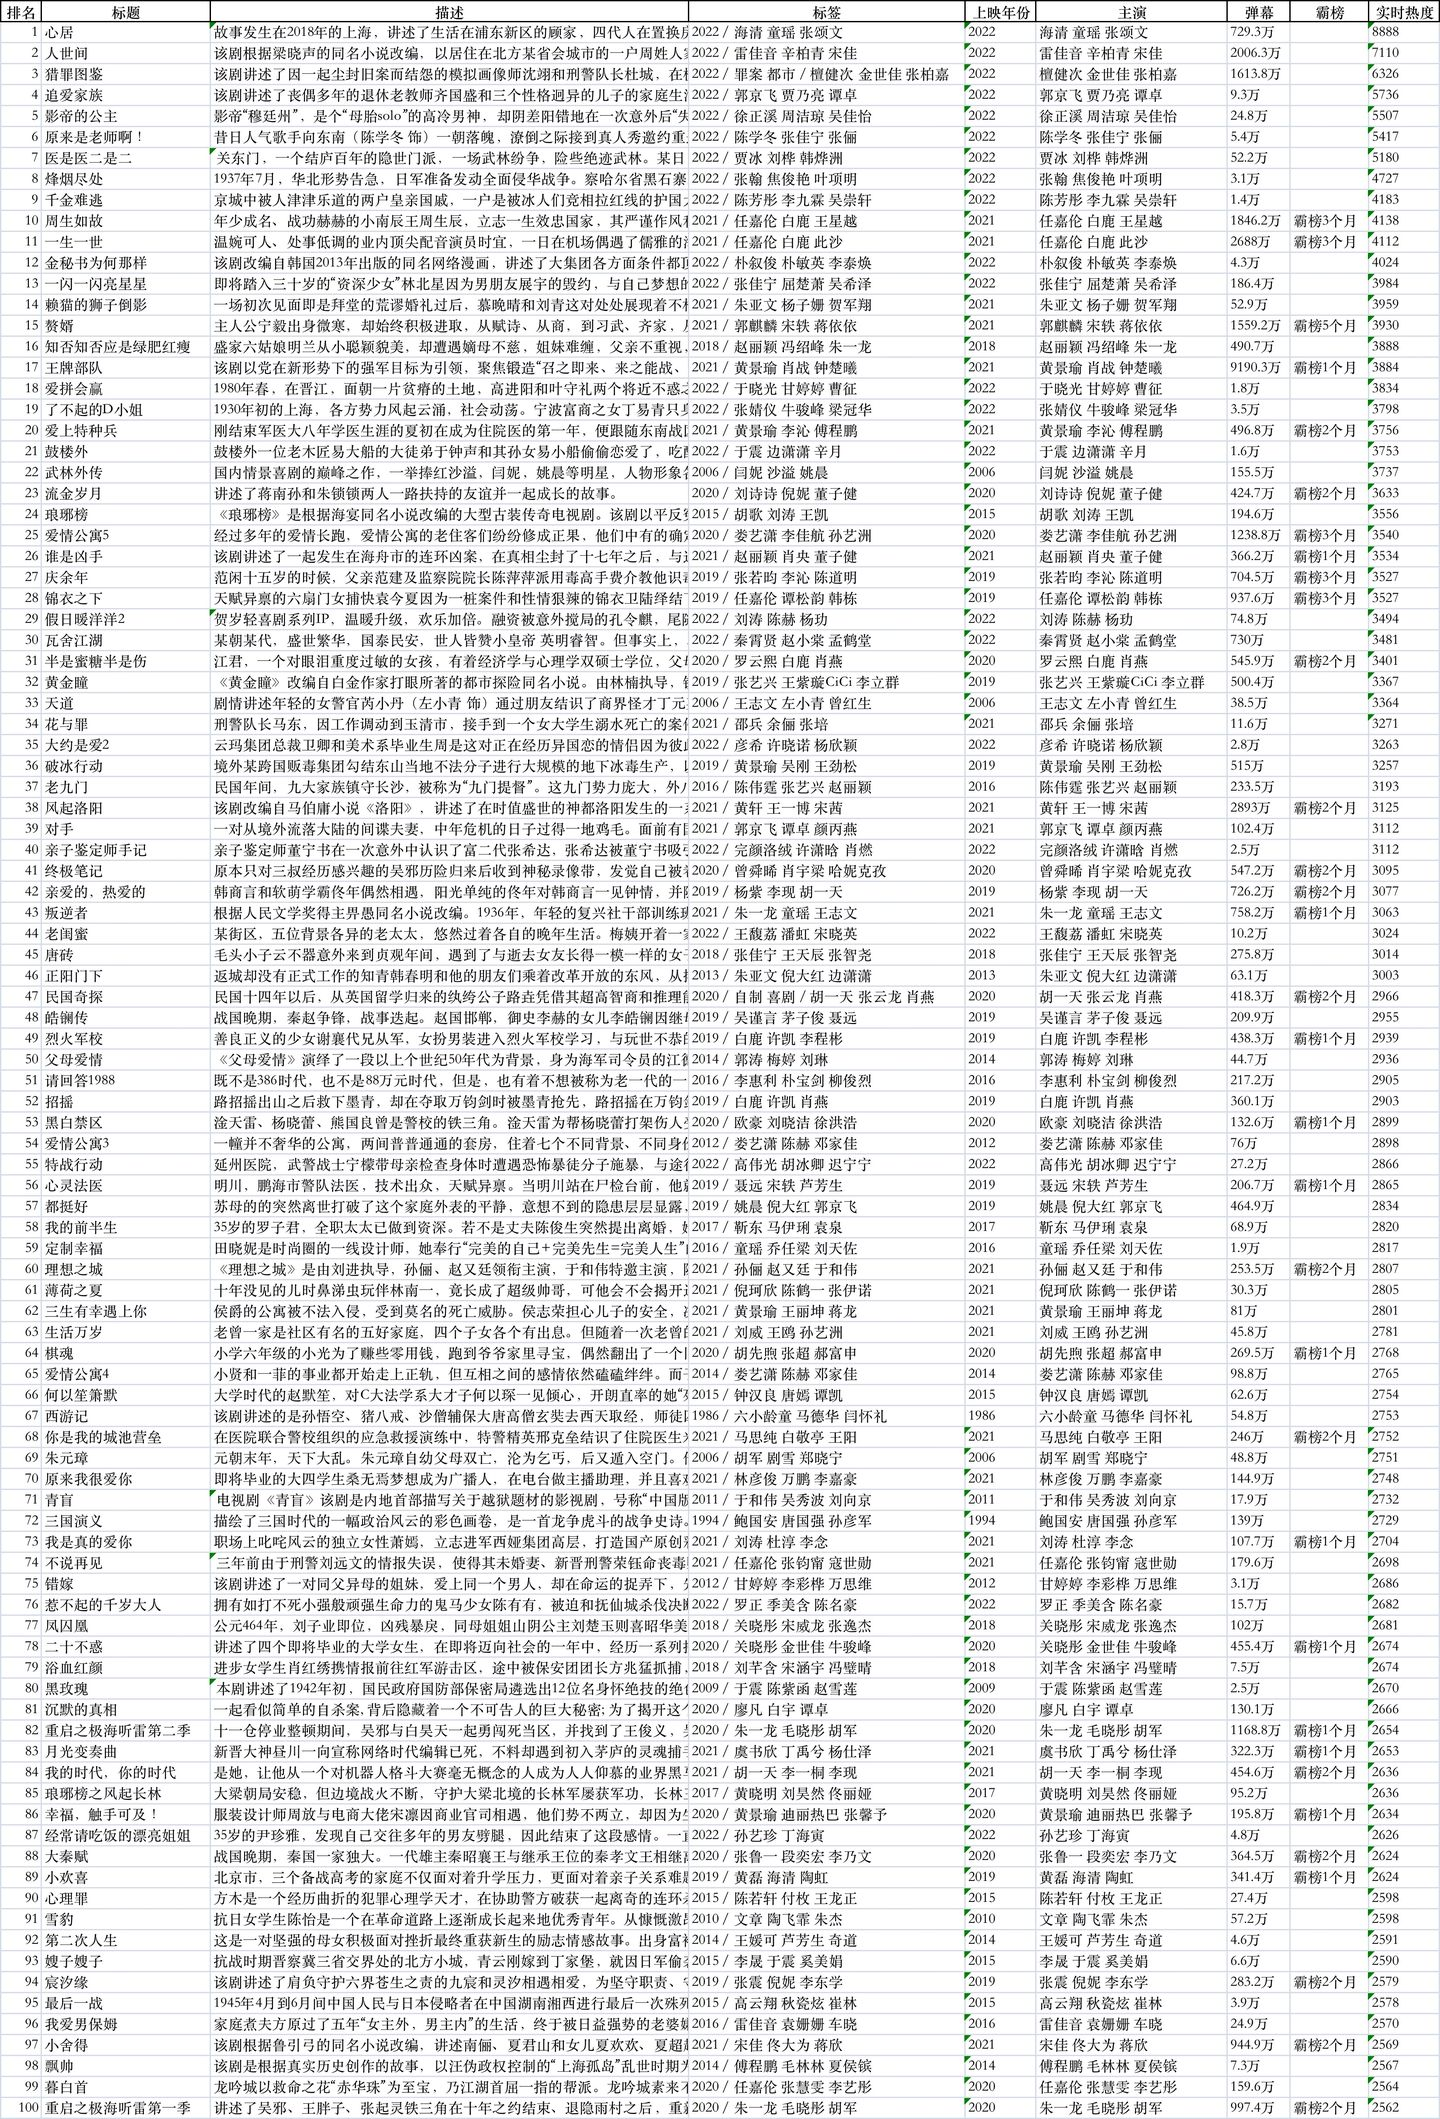
随便打开一个文件,比如,热播榜:
比如,都市榜:
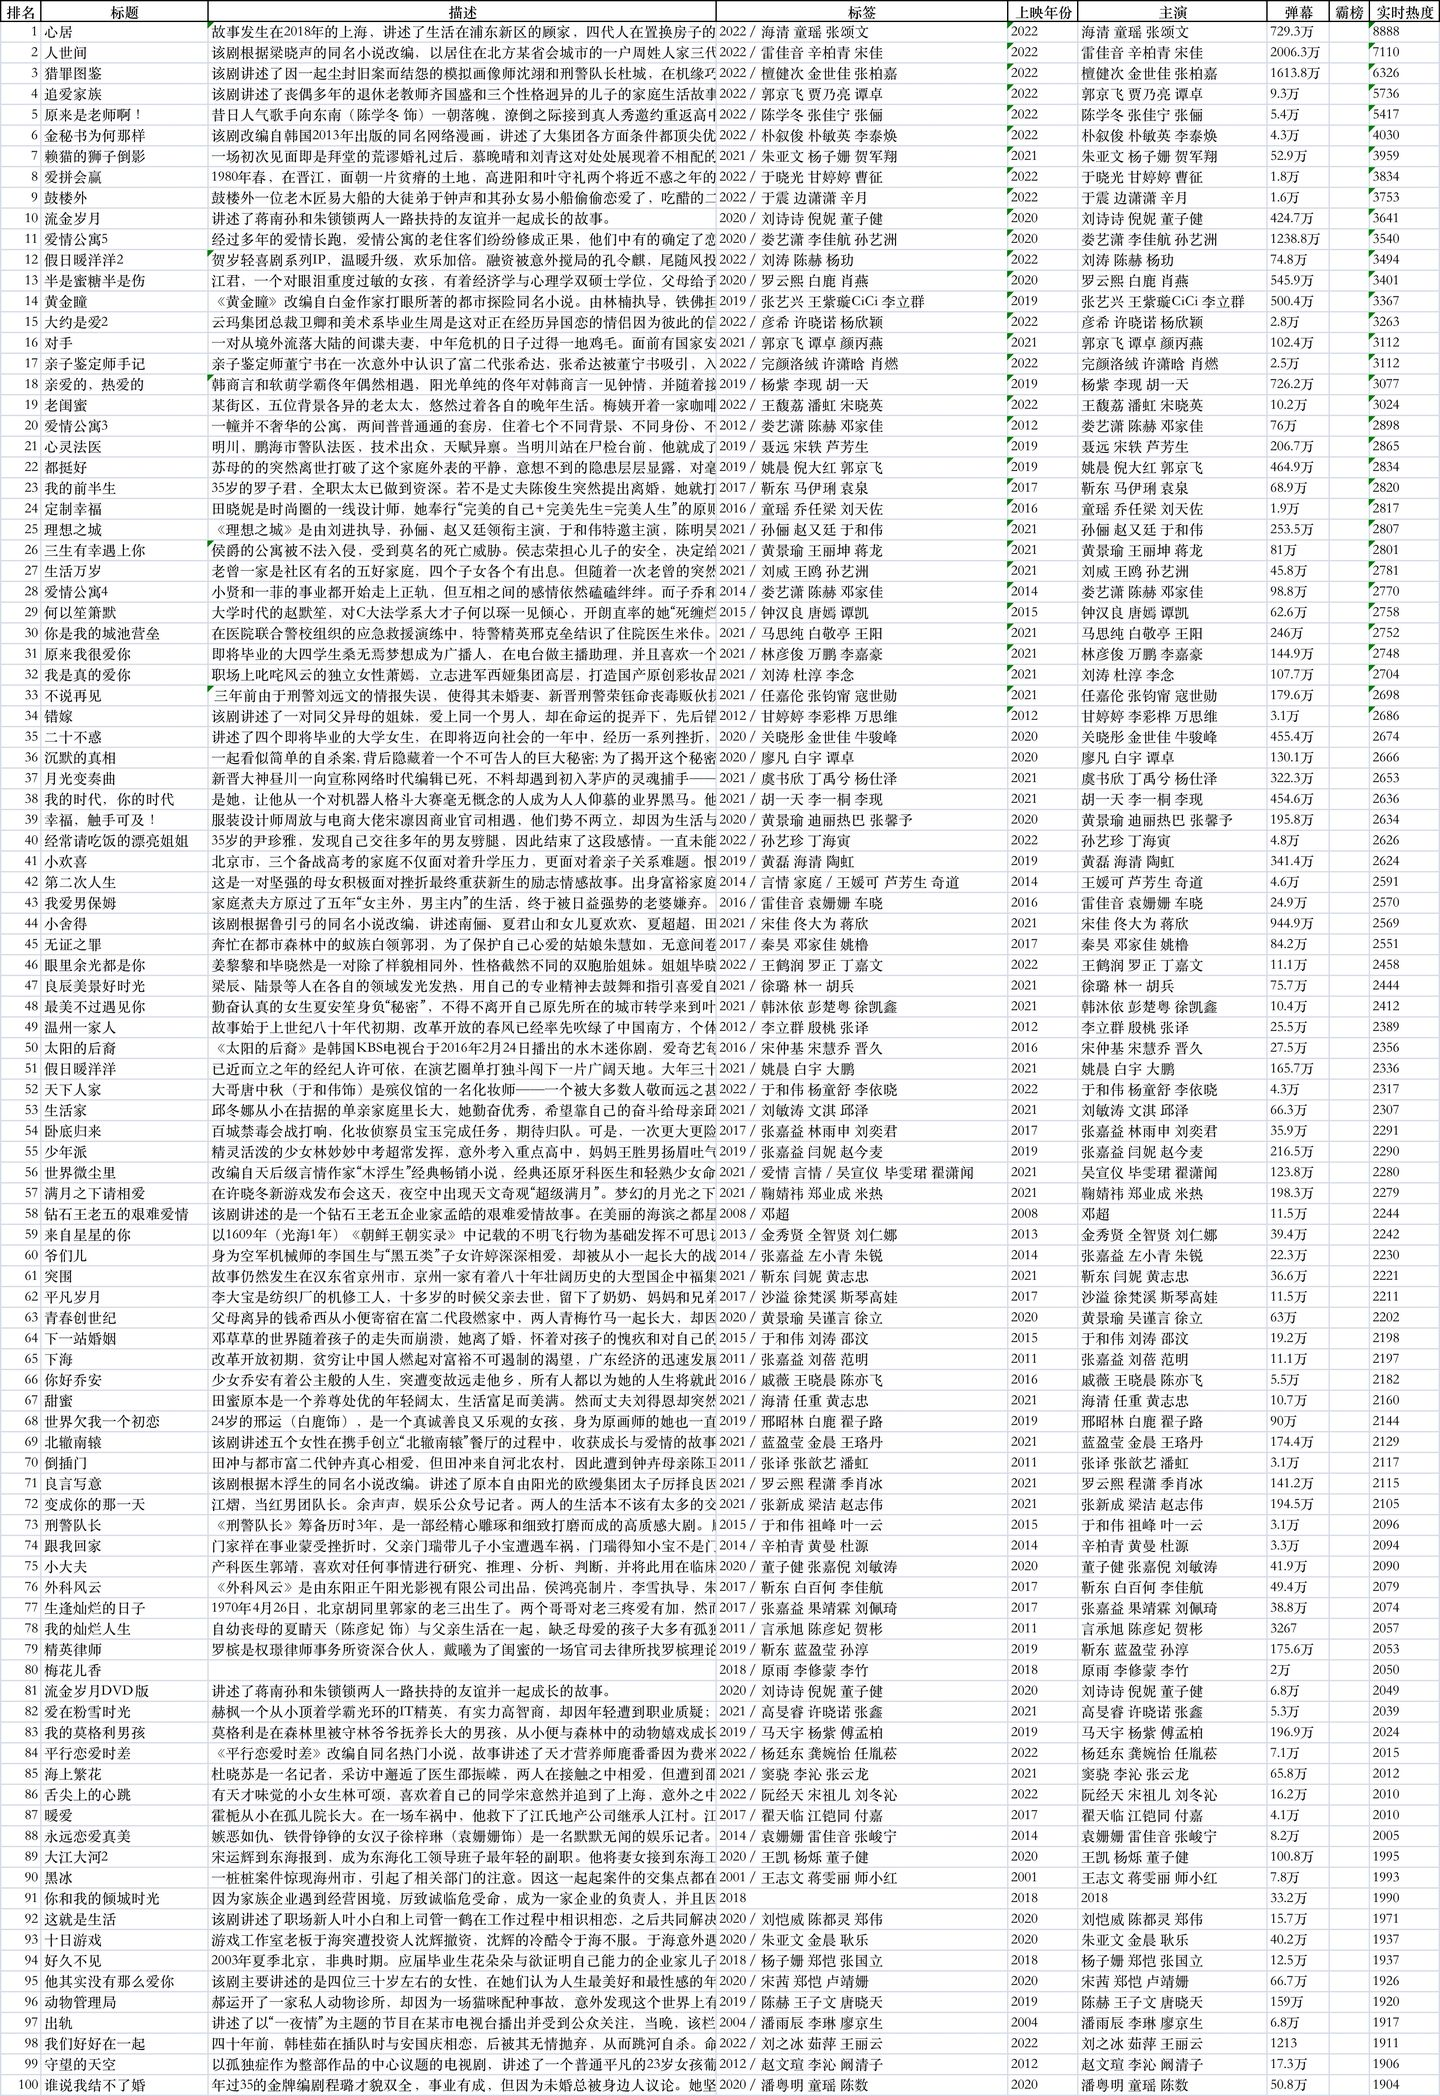
除了搞笑榜有40+条数据,其他榜单都是100条数据,对应100部电视剧。
四、视频演示
代码演示视频:https://www.bilibili.com/video/BV1fT4y1e7wd/
五、附完整源码
完整源码:【python爬虫实战】用python爬取《爱奇艺风云榜》电视剧十大榜单!2023.6发布
我是 @马哥python说 ,持续分享python源码干货中!
【python爬虫实战】用python爬取爱奇艺电视剧十大榜单的全部数据!的更多相关文章
- Python爬虫实战案例:爬取爱奇艺VIP视频
一.实战背景 爱奇艺的VIP视频只有会员能看,普通用户只能看前6分钟.比如加勒比海盗5的URL:http://www.iqiyi.com/v_19rr7qhfg0.html#vfrm=19-9-0-1 ...
- 爬取爱奇艺电视剧url
----因为需要顺序,所有就用串行了---- import requests from requests.exceptions import RequestException import re im ...
- Python爬虫实战六之抓取爱问知识人问题并保存至数据库
大家好,本次为大家带来的是抓取爱问知识人的问题并将问题和答案保存到数据库的方法,涉及的内容包括: Urllib的用法及异常处理 Beautiful Soup的简单应用 MySQLdb的基础用法 正则表 ...
- Python爬虫实战二之爬取百度贴吧帖子
大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 前言 亲爱的们,教程比较旧了,百度贴吧页面可能改版,可能代码不 ...
- Python爬虫实战一之爬取糗事百科段子
大家好,前面入门已经说了那么多基础知识了,下面我们做几个实战项目来挑战一下吧.那么这次为大家带来,Python爬取糗事百科的小段子的例子. 首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把 ...
- 转 Python爬虫实战二之爬取百度贴吧帖子
静觅 » Python爬虫实战二之爬取百度贴吧帖子 大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 本篇目标 ...
- 转 Python爬虫实战一之爬取糗事百科段子
静觅 » Python爬虫实战一之爬取糗事百科段子 首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把,这次我们尝试一下用爬虫把他们抓取下来. 友情提示 糗事百科在前一段时间进行了改版,导致 ...
- 使用selenium 多线程爬取爱奇艺电影信息
使用selenium 多线程爬取爱奇艺电影信息 转载请注明出处. 爬取目标:每个电影的评分.名称.时长.主演.和类型 爬取思路: 源文件:(有注释) from selenium import webd ...
- Python 爬虫实例(5)—— 爬取爱奇艺视频电视剧的链接(2017-06-30 10:37)
1. 我们找到 爱奇艺电视剧的链接地址 http://list.iqiyi.com/www/2/-------------11-1-1-iqiyi--.html 我们点击翻页发现爱奇艺的链接是这样的 ...
- 如何利用python爬虫爬取爱奇艺VIP电影?
环境:windows python3.7 思路: 1.先选取你要爬取的电影 2.用vip解析工具解析,获取地址 3.写好脚本,下载片断 4.将片断利用电脑合成 需要的python模块: ##第一 ...
随机推荐
- 微前端框架single-spa子应用加载解析
作者:京东物流 宁冲 1 前言 什么是微前端? 微前端是指存在于浏览器中的微服务. 本文主要通过对微前端框架single-spa的基座应用加载子应用的single-spa-vue函数库进行分析,通过代 ...
- [小迪安全]笔记 day12、13 MySQL注入
1. 简单案例 1.1 简易代码分析SQL注入原理 http://localhost:8085/sqli-labs/Less-2/index.php?id=2 id=2 正常查询 http://loc ...
- 月光宝盒(vivo流量录制回放平台)正式对外开源
作者:vivo 互联网服务器团队- Liu Yanjiang 月光宝盒是一个基于流量录制回放的自动化测试平台,通过录制回放取代编写脚本进行自动化回归,提升测试效率和覆盖率.因为其解决方案具有很强的通用 ...
- [MySQL]innodb_flush_log_at_trx_commit与sync_binlog
1 innodb_flush_log_at_trx_commit 辨析 innodb_flush_log_at_trx_commit = 0 : 每秒将日志缓冲区写入log file,并同时flush ...
- Java GC基础知识
对象存活判断 引用计数 在对象中添加一个引用计数器,每当有一个地方引用它时,计数器值就加一:当引用失效时,计数器值就减一:任何时刻计数器为零的对象就是不可 能再被使用的 引用计数法的缺陷: publi ...
- COIG:开源四类中文指令语料库
CHINESE OPEN INSTRUCTION GENERALIST: A PRELIMINARY RELEASE 论文:https://arxiv.org/pdf/2304.07987v1.pdf ...
- vue项目webpack打包
之前一篇随笔写到vue多环境打包环境配置:https://www.cnblogs.com/shun1015/p/13411636.html 1.区分vue脚手架版本,版本不同,项目结构不同,多环境变量 ...
- 深度学习-08(PaddlePaddle文本分类)
深度学习-08(PaddlePaddle文本分类) 文章目录 深度学习-08(PaddlePaddle文本分类) NLP概述 NLP基本概念 什么是NLP NLP的主要任务 传统NLP方法 传统NLP ...
- js验证统一社会信用代码
js验证统一社会信用代码 //验证信用代码 function CheckSocialCreditCode(Code) { var patrn = /^[0-9A-Z]+$/; //18位校验及大写校验 ...
- [Flink] Flink Job运行状态正常,但日志中偶报“FlinkException: The file LOG does not exist on the TaskExecutor.”
0 序言 Flink : 1.12 job start running time : 2022-12-27 17:40:47 problem throw time : 2023-05-11 16:41 ...