
【Spark2.0源码学习】-8.SparkContext与Application介绍
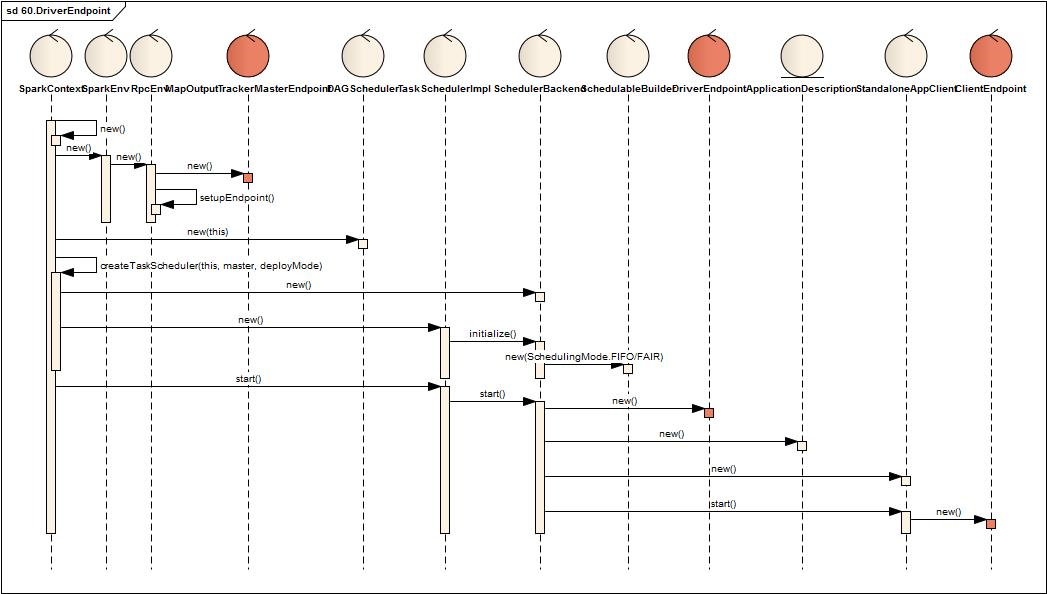

- 内部创建一个SparkEnv,SparkEnv内部创建一个RpcEnv
- RpcEnv内部创建并注册一个MapOutputTrackerMasterEndpoint(该Endpoint暂不介绍)
- 接着创建DAGScheduler,TaskSchedulerImpl,SchedulerBackend
- TaskSchedulerImpl创建时创建SchedulableBuilder,SchedulableBuilder根据类型分为FIFOSchedulableBuilder,FairSchedulableBuilder两类
- 最后启动TaskSchedulerImpl,TaskSchedulerImpl启动SchedulerBackend
- SchedulerBackend启动时创建ApplicationDescription,DriverEndpoint, StandloneAppClient
- StandloneAppClient内部包括一个ClientEndpoint
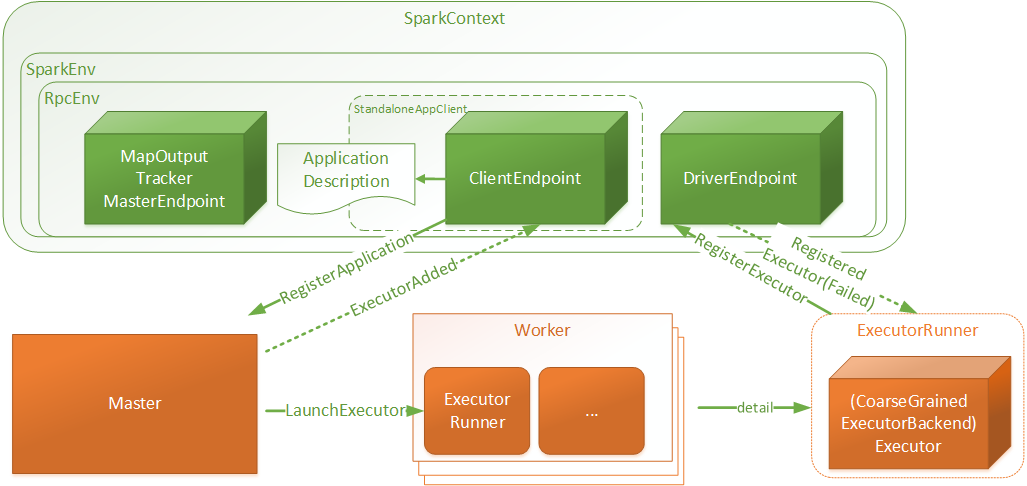

- SparkContext:是用户Spark执行任务的上下文,用户程序内部使用Spark提供的Api直接或间接创建一个SparkContext
- SparkEnv:用户执行的环境信息,包括通信相关的端点
- RpcEnv:SparkContext中远程通信环境
- ApplicationDescription:应用程序描述信息,主要包含appName, maxCores, memoryPerExecutorMB, coresPerExecutor, Command(
CoarseGrainedExecutorBackend), appUiUrl等 - ClientEndpoint:客户端端点,启动后向Master发起注册RegisterApplication请求
- Master:接受RegisterApplication请求后,进行Worker资源分配,并向分配的资源发起LaunchExecutor指令
- Worker:接受LaunchExecutor指令后,运行ExecutorRunner
- ExecutorRunner:运行applicationDescription的Command命令,最终Executor,同时向DriverEndpoint注册Executor信息


- 如果waitingApp配置了app.desc.coresPerExecutor:
- 轮询所有有效可分配的worker,每次分配一个executor,executor的核数为minCoresPerExecutor(app.desc.coresPerExecutor),直到不存在有效可分配资源或者app依赖的资源已全部被分配
- 如果waitingApp没有配置app.desc.coresPerExecutor:
- 轮询所有有效可分配的worker,每个worker分配一个executor,executor的核数为从minCoresPerExecutor(为固定值1)开始递增,直到不存在有效可分配资源或者app依赖的资源已全部被分配
- 其中有效可分配worker定义为满足一次资源分配的worker:
- cores满足:usableWorkers(pos).coresFree - assignedCores(pos) >= minCoresPerExecutor,
- memory满足(如果是新的Executor):usableWorkers(pos).memoryFree - assignedExecutors(pos) * memoryPerExecutor >= memoryPerExecutor
- 注意:Master针对于applicationInfo进行资源分配时,只有存在有效可用的资源就直接分配,而分配剩余的app.coresLeft则等下一次再进行分配


- 在Worker的tempDir下面创建application以及executor的目录,并chmod700操作权限
- 创建并启动ExecutorRunner进行Executor的创建
- 向master发送Executor的状态情况
- 新线程【ExecutorRunner for [executorId]】读取ApplicationDescription将其中Command转化为本地的Command命令
- 调用Command并将日志输出至executor目录下的stdout,stderr日志文件中,Command对应的java类为CoarseGrainedExecutorBackend
- 创建一个SparkEnv,创建ExecutorEndpoint(CoarseGrainedExecutorBackend),以及WorkerWatcher
- ExecutorEndpoint创建并启动后,向DriverEndpoint发送RegisterExecutor请求并等待返回
- DriverEndpoint处理RegisterExecutor请求,返回ExecutorEndpointRegister的结果
- 如果注册成功,ExecutorEndpoint内部再创建Executor的处理对象
【Spark2.0源码学习】-8.SparkContext与Application介绍的更多相关文章
- 【Spark2.0源码学习】-3.Endpoint模型介绍
Spark作为分布式计算框架,多个节点的设计与相互通信模式是其重要的组成部分. 一.组件概览 对源码分析,对于设计思路理解如下: RpcEndpoint: ...
- 【Spark2.0源码学习】-1.概述
Spark作为当前主流的分布式计算框架,其高效性.通用性.易用性使其得到广泛的关注,本系列博客不会介绍其原理.安装与使用相关知识,将会从源码角度进行深度分析,理解其背后的设计精髓,以便后续 ...
- spark2.0源码学习
[Spark2.0源码学习]-1.概述 [Spark2.0源码学习]-2.一切从脚本说起 [Spark2.0源码学习]-3.Endpoint模型介绍 [Spark2.0源码学习]-4.Master启动 ...
- 【Spark2.0源码学习】-2.一切从脚本说起
从脚本说起 在看源码之前,我们一般会看相关脚本了解其初始化信息以及Bootstrap类,Spark也不例外,而Spark我们启动三端使用的脚本如下: %SPARK_HOME%/sbin/st ...
- 【Spark2.0源码学习】-6.Client启动
Client作为Endpoint的具体实例,下面我们介绍一下Client启动以及OnStart指令后的额外工作 一.脚本概览 下面是一个举例: /opt/jdk1..0_79/bin/jav ...
- 【Spark2.0源码学习】-4.Master启动
Master作为Endpoint的具体实例,下面我们介绍一下Master启动以及OnStart指令后的相关工作 一.脚本概览 下面是一个举例: /opt/jdk1..0_79/ ...
- 【Spark2.0源码学习】-5.Worker启动
Worker作为Endpoint的具体实例,下面我们介绍一下Worker启动以及OnStart指令后的额外工作 一.脚本概览 下面是一个举例: /opt/jdk1..0_79/ ...
- 【Spark2.0源码学习】-9.Job提交与Task的拆分
在前面的章节Client的加载中,Spark的DriverRunner已开始执行用户任务类(比如:org.apache.spark.examples.SparkPi),下面我们开始针对于用 ...
- 【Spark2.0源码学习】-10.Task执行与回馈
通过上一节内容,DriverEndpoint最终生成多个可执行的TaskDescription对象,并向各个ExecutorEndpoint发送LaunchTask指令,本节内容将关注Exe ...
随机推荐
- multiprocessing还是threading?
今夜看了一篇分析python中多进程与多线程优劣的文章,文章通过几组性能测试强调了多进程的性能优势,同时也深入分析了为何python中多线程性能较差的原因,GIL就是解释器全局锁,该机制限制每个pyt ...
- write(6)、write(10)和write(16)以及read(6)、read(10)和read(16)的区别与应用
大家知道,我们读写硬盘的时候发送的命令为SCSI READ或SCSI WRITE.即SCSI读和SCSI写命令.但是READ和WRITE有很多种,这些命令的应用场合是什么呢? 最重要的一点就是,这是跟 ...
- sequelize的get/post方法例子
定义两个model,一个给get的,一个给post的 var Sequelize = require('sequelize'); const DeviceNos = sequelize.define( ...
- 关于mariad&mysql部分
不赘述安装部分 查看安装的mysql版本 连接数据库基本操作: 查看数据库有没有运行: 退出操作:两者的区别就在于有无分号 或者: 查看已经安装的数据库: 新增用户并且赋予权限操作 MariaDB [ ...
- Linux系统重置root用户密码
Linux系统重置root用户密码 作者:Eric 微信:loveoracle11g 查看系统版本是不是RHEL7 [root@zhouwanchun ~]# cat /etc/redhat-rele ...
- springMVC的高级数据绑定,以及json交互,全局异常配置,
一.窄化请求映射 1.在class上添加@RequestMapping(url)指定通用请求前缀, 限制此类下的所有方法请求url必须以请求前缀开头,通过此方法对url进行分类管理. 如下: @Con ...
- python下selenium自动化测试自我实践
周末实验自动化提交数据时,本来没打算写记录的,不过遇到一些问题,觉得可以提提.基本操作就不用写了,搜索过程中都发现了两个博客都出了selenium+python的书,说明操作一搜一大把. 1. 等待页 ...
- source tree常用功能
参考地址: https://blog.csdn.net/weixin_39568744/article/details/81413198
- HTML5-网页添加视频-菜鸟笔记
一.标签 <video> 在html5中,有这么个标签 <video> 标签. <video> 允许你简单的嵌入一段视频. 二.浏览器的兼容性问题 WebM 容器通 ...
- Beta冲刺——第三天
beta冲刺:第三天 各个成员今日完成的任务 成员 冯晓.马思远 彭辉.王爽 吴琼.郝延婷 今日完成任务 ·管理员管理功能模块下角色管理功能的完善测试 ·角色和权限部分代码规范 ·博客撰写 ·后台系统 ...