
LDA进阶(Dynamic Topic Models)
转自:http://blog.csdn.net/hxxiaopei/article/details/8034308
http://blog.csdn.net/huagong_adu/article/details/7937616
LDA浅析
http://www.slideshare.net/aurora1625/topic-model-lda-and-all-that
Topic model, LDA and all that
LDA漫游指南
http://yuedu.baidu.com/ebook/d0b441a8ccbff121dd36839a?pn=5&pa=44
LDA相关文章
http://blog.csdn.net/pirage/article/details/9467547
http://blog.csdn.net/yangliuy/article/details/8457329
yangliuy实现的代码
第一篇:PLSA及EM算法
第三篇:LDA变形模型-Twitter LDA,TimeUserLDA,ATM,Labeled-LDA,MaxEnt-LDA等
第四篇:基于变形LDA的paper分类总结(bibliography)
第五篇:LDA Gibbs Sampling 的JAVA实现
DTM(Dynamic Topic Models)进行主题演化实验
---------------------------------------------------------------------------------------------------------
在自己机器上(ubuntu12.04),运行Blei(http://www.cs.princeton.edu/~blei/topicmodeling.html)的代码过程中,能正常编译,
但是运行却遇到 段错误的问题。
在网上找了很多blog和资料都没有解决
最后决定自己调试错误,用了用gdb调试工具,
最后在实验室罗师兄的帮助下,解决了这个困扰了很久的问题。
main 文件39行:

代码问题终于得以解决。。。。。。
--------------------------------------------------------------------------------------------------------------------------------------
以下参考自:http://www.cnblogs.com/todoit/p/4057619.html
程序中dtm/sample.sh文件说明
运行例子试验
(1)输入文件(如dtm/example文件夹所示)test-mult.dat和test-seq.dat
a:foo-mult.dat,(相当于例子中test-mult.dat)用来表示文档和词的关系
每个文档一行,每一行形式是: unique_word_count index1:count1 index2:count2 ... indexn:counnt
该文章的总词数(不重复) 词1编号(用数字表示编号):词1频次 词2编号:词2频次 词n编号:词n频次
例如:11 288:1 1248:1 5:1 1063:2 269:1 654:1 656:2 532:1 373:1 1247:1 543:1
表示这篇一共有11个不重复的词,第228个词出现1次,1248个词出现1次,这些词是所有文档中统一编号的。
需要注意的一点是:该文件中文档是按时间顺序排列的,时间最早的在最上面,时间最晚的在最下面。
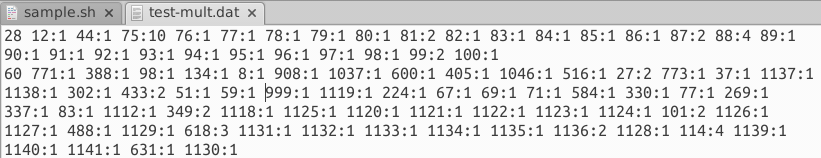
文件格式如下:
Number_Timestamps(时间窗总数)
number_docs_time_1(第一个时间窗的文档数,就是从第一个到第几个文档划分到第一个时间窗,我们如果按年来划分,就把每年的文档数写到这里就行)
...
number_docs_time_i
...
number_docs_time_NumberTimestamps
作者提供的例子,第一行表示分为10个时间窗,第二行表示第一个时间窗有25个文档。(看样子估计也是按年划分的):
10
25
50
75
100
100
100
100
125
150
175
当上面两个文件搞定后。作者说还有两个文件虽然不是必须的,但是也是很有用的。
C: 词典文件
文档集合中涉及的所有的词,按照上面的词的序号排列。
d:文档信息文件
每行表示一个文档的基本信息,按照文档a中的顺序排列。
上述文件都可以用text2ldac生成,在https://github.com/JoKnopp/text2ldac下载,用python打开。
使用方法,在命令行中,找到text2ldac.py目录,运行 python text2ldac.py -o ./out -e txt ./in
out文件夹为输出文件位置,in文件夹为输入文件位置。 txt为仅处理txt文件
(2)运行程序
作者在readme文件中说,通过运行./main --help命令可以查看所有选项和解释
输入下面的命令(后面的注释是自己加的,。如果影响运行请去掉)
./main \ /*main函数*/
--ntopics=20 \ /*每个时间窗生成20个主题*/
--mode=fit \ /*这个应该有dim和fit两个选项*/
--rng_seed=0 \
--initialize_lda=true \
--corpus_prefix=example/test \
--outname=example/model_run \
--top_chain_var=0.005 \
--alpha=0.01 \
--lda_sequence_min_iter=6 \
--lda_sequence_max_iter=20 \
--lda_max_em_iter=10
(2)输出结果。 上面文件完成之后,通过运行程序生成下面的文件,并且可以通过R查看结果,我们就可以用这个结果进行分析。
a topic-???-var-e-log-prob.dat:
主要是 e-betas(词在每个主题内每个时间段的分布),一行是一个词。
从文件中,我们看以看到每行只有一个数字。
由输入可知:
有4824个单词的词典。
有10个时间戳
生成20个主题
      a = "topic-002-var-e-log-prob.dat"

    b = matrix(a, ncol = 10 byrow=TRUE)

     10列,按行排(本例中表示4824行,10列的矩阵)
     The probability of term 100 in topic 2 at time 3:

    exp(b[100,3])
可以在dtm\example\model_run\lda-seq中看到例子,有48240行,有4824个词,每个时间窗内有4824个词。
作者同时给出了在R中查看这些矩阵的方法。比如查看某个词在某个主题的某一个时间段的概率。
b gam.dat
gammas数据。表示文档与主题的关联。
http://www.cnblogs.com/todoit/p/3753871.html
《Dynamic Topic Detection and Tracking: A Comparison of HDP, C-Word, and Cocitation Methods》笔记
XR0%~K4OXPNCD.png)
LDA进阶(Dynamic Topic Models)的更多相关文章
- 使用DTM ( Dynamic Topic Models )进行主题演化实验
最近想研究下Dynamic Topic Models(DTM),论文看了看,文科生的水平确实是看不懂,那就实验一下吧,正好Blei的主页上也提供了相应的C++工具, http://www.cs.pri ...
- 概率主题模型简介 Introduction to Probabilistic Topic Models
此文为David M. Blei所写的<Introduction to Probabilistic Topic Models>的译文,供大家参考. 摘要:概率主题模型是一系列旨在发现隐藏在 ...
- 转:概率主题模型简介 --- ---David M. Blei所写的《Introduction to Probabilistic Topic Models》的译文
概率主题模型简介 Introduction to Probabilistic Topic Models 转:http://www.cnblogs.com/siegfang/archive/2 ...
- 《Dynamic Topic Detection and Tracking: A Comparison of HDP, C-Word, and Cocitation Methods》笔记
原文地址:http://onlinelibrary.wiley.com/doi/10.1002/asi.23134/abstract 黄色背景是我认为比较重要的,红色字体是我自己的话. 动态主题监测与 ...
- lda 主题模型--TOPIC MODEL--Gibbslda++结果分析
在之前的博客中已经详细介绍了如何用Gibbs做LDA抽样.(http://www.cnblogs.com/nlp-yekai/p/3711384.html) 这里,我们讨论一下实验结果: 结果文件包括 ...
- 【转】基于LDA的Topic Model变形
转载自wentingtu 基于LDA的Topic Model变形最近几年来,随着LDA的产生和发展,涌现出了一批搞Topic Model的牛人.我主要关注了下面这位大牛和他的学生:David M. B ...
- 基于LDA的Topic Model变形
转载于: 转:基于LDA的Topic Model变形 最近有想用LDA理论的变形来解决问题,调研中.... 基于LDA的Topic Model变形 基于LDA的Topic Model变形最近几年来,随 ...
- [IR] Concept Search and LDA
重要的是通过实践更深入地了解贝叶斯思想,先浅浅地了解下LDA. From: http://blog.csdn.net/huagong_adu/article/details/7937616/ 传统方法 ...
- LDA汇总
1.Blei的LDA代码(C):http://www.cs.princeton.edu/~blei/lda-c/index.html2.D.Bei的主页:http://www.cs.princeton ...
随机推荐
- JavaScript中JSON字符串和JSON对象相互转化
JSON字符串转化为JSON对象的2种方式 一.使用函数eval var personsstr = '[{"Name":"zhangsan","Age ...
- 在Android中自动实现横竖屏切换的问题
http://developer.android.com/training/basics/supporting-devices/screens.html参照Google推荐的做法 在你项目的res 文 ...
- html5 canvas+js实现ps钢笔抠图
html5 canvas+js实现ps钢笔抠图 1. 项目要求需要用js实现photoshop中钢笔抠图功能,就用了近三四天的时间去解决它,最终还是基本上把他实现了. 做的过程中走了不少弯路,最终一同 ...
- IIS发布网站,浏览网站时候,出现 试图加载格式不正确的程序。
异常来自HRESULT:0x8007000B 缘由:在64位操作系统下IIS发布32位的项目,报“项目依赖的dll无法读取,试图加载格式不正确的程序”错误. 原因:程序集之间的通讯要么全是64位环境下 ...
- Memcached安装配置最大使用内存
Memcached安装配置最大使用内存 项目做了很多,虽然用memcached的项目也有很多.但是没有太关注安装memcached细节问题 最近做了一个项目,把很多东西都放到memcached缓存中, ...
- 关于lower_bound的使用
突然发现lower_bound是一个挺好用的东西, 在学习最长不下降子序列的nlogn的算法的时候看到的,C++党写起二分来一行- -P党一排233 感觉如果到时候需要用上二分的话,能用lower_b ...
- Microsoft Push Notification Service(MPNS)的最佳体验
如何获得 Microsoft Push Notification Service(MPNS)的最佳体验 有很多同学抱怨MPNS的各种问题,其中包括服务超时.返回各种错误代码不知如何处理等等..今天我用 ...
- inet_aton()
两次技术面试都被让c语言实现inet_aton()函数 看来这个函数真的很重要. 我先贴上我自己的实现代码 #include <stdio.h> #include <math.h&g ...
- SQLSERVER用无中生有的思想来替代游标
SQLSERVER用无中生有的思想来替代游标 SQLSERVER用无中生有的思想来替代游标 昨天在MSDN论坛看到一个帖子,帖子中LZ需要根据某列的值把其他列的值插入到额外列 帖子地址:http:// ...
- JavaScript面向对象编程(一)原型与继承
原型(prototype) JavaScript是通过原型(prototype)进行对象之间的继承.当一个对象A继承自另外一个对象B后,A就拥有了B中定义的属性,而B就成为了A的原型.JavaScri ...