
语言模型评价指标Perplexity
在信息论中,perplexity(困惑度)用来度量一个概率分布或概率模型预测样本的好坏程度。它也可以用来比较两个概率分布或概率模型。(应该是比较两者在预测样本上的优劣)低困惑度的概率分布模型或概率模型能更好地预测样本。
困惑度越小,句子概率越大,语言模型越好。
wiki上列举了三种perplexity的计算:
1. 概率分布的perplexity
公式:
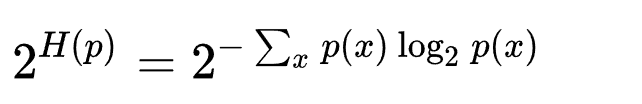
离散概率分布p的困惑度由下式给出 其中H(p) 是该分布的熵,x遍历事件空间。
随机变量X的复杂度由其所有可能的取值x定义。 一个特殊的例子是k面均匀骰子的概率分布,它的困惑度恰好是k。一个拥有k困惑度的随机变量有着和k面均匀骰子一样多的不确定性,并且可以说该随机变量有着k个困惑度的取值(k-ways perplexed)。(在有限样本空间离散随机变量的概率分布中,均匀分布有着最大的熵)
困惑度有时也被用来衡量一个预测问题的难易程度。但这个方法不总是精确的。例如:在概率分布B(1,P=0.9)中,即取得1的概率是0.9,取得0的概率是0.1。
2. 概率模型的perplexity
用一个概率模型q去估计真实概率分布p,那么可以通过测试集中的样本来定义这个概率模型的困惑度。
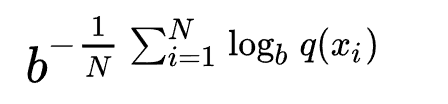

 表示我们对真实分布下样本点x出现概率的估计。比如用p(x)=n/N.
3. 单词的perplexity
语言模型评价指标Perplexity的更多相关文章
- LDA主题模型评估方法–Perplexity
在LDA主题模型之后,需要对模型的好坏进行评估,以此依据,判断改进的参数或者算法的建模能力. Blei先生在论文<Latent Dirichlet Allocation>实验中用的是Per ...
- 斯坦福NLP课程 | 第15讲 - NLP文本生成任务
作者:韩信子@ShowMeAI,路遥@ShowMeAI,奇异果@ShowMeAI 教程地址:http://www.showmeai.tech/tutorials/36 本文地址:http://www. ...
- XLM论文原理解析
1. 前言 近一年来,NLP领域发展势头强劲,从ELMO到LSTM再到去年最牛叉的Google Bert,在今年年初,Facebook又推出了XLM模型,在跨语言预训练领域表现抢眼.实验结果显示XLM ...
- 0-4评价一个语言模型Evaluating Language Models:Perplexity
有了一个语言模型,就要判断这个模型的好坏. 现在假设: 我们有一些测试数据,test data.测试数据中有m个句子;s1,s2,s3-,sm 我们可以查看在某个模型下面的概率: 我们也知道,如果计算 ...
- 【NLP_Stanford课堂】语言模型2
一.如何评价语言模型的好坏 标准:比起语法不通的.不太可能出现的句子,是否为“真实”或"比较可能出现的”句子分配更高的概率 过程:先在训练数据集上训练模型的参数,然后在测试数据集上测试模型的 ...
- 语言模型kenlm的训练及使用
一.背景 近期研究了一下语言模型,同事推荐了一个比较好用的工具包kenlm,记录下使用过程. 二.使用kenlm训练 n-gram 1.工具介绍:http://kheafield.com/code/k ...
- 用python计算lda语言模型的困惑度并作图
转载请注明:电子科技大学EClab——落叶花开http://www.cnblogs.com/nlp-yekai/p/3816532.html 困惑度一般在自然语言处理中用来衡量训练出的语言模型的好坏. ...
- Multimodal —— 看图说话(Image Caption)任务的论文笔记(一)评价指标和NIC模型
看图说话(Image Caption)任务是结合CV和NLP两个领域的一种比较综合的任务,Image Caption模型的输入是一幅图像,输出是对该幅图像进行描述的一段文字.这项任务要求模型可以识别图 ...
- 学习笔记TF035:实现基于LSTM语言模型
神经结构进步.GPU深度学习训练效率突破.RNN,时间序列数据有效,每个神经元通过内部组件保存输入信息. 卷积神经网络,图像分类,无法对视频每帧图像发生事情关联分析,无法利用前帧图像信息.RNN最大特 ...
随机推荐
- buuctf@ciscn_2019_n_1
from pwn import * #io=process('./ciscn_2019_n_1') io=remote('node3.buuoj.cn',28216) io.sendline(0x38 ...
- yii框架学习(MVC)
路由:两种方式,第一种是默认方式访问,假设配置了虚拟主机,那么localhost/web/index.php?r=admin/index 访问的是controllers目录下的admin控制器里 ...
- .net文件夹上传源码
核心原理: 该项目核心就是文件分块上传.前后端要高度配合,需要双方约定好一些数据,才能完成大文件分块,我们在项目中要重点解决的以下问题. * 如何分片: * 如何合成一个文件: * 中断了从哪个分片开 ...
- jQuery属性操作之值操作
值操作是对DOM属性value进行读取和设置操作. 比如html(). text(). val(). 1. html 1. 1 html()获取值 返回值:String 描述:获取集合中第一个匹配元素 ...
- window 下要运行php,需要编辑php环境变量
参考:https://blog.csdn.net/zhezhebie/article/details/72765262
- vuex 讲解
vuex 状态的管理状态,它采用集中式存储管理应用的所有组件的状态,尤其是在中大型项目,则是很好的开发利器 vuex 的流程图 vuex 的优势: 1. vuex 的存储状态,响应式的 2. 他是所有 ...
- VisualVM通过密码JMX远程连接JVM
如果本地安装了JDK,则在${java.home}/bin/下可找到jvisualvm.exe,双击打开即可使用.否则,去官网下载一个,解压即可使用.现有一个springboot程序springboo ...
- 往Angular应用程序中添加DevExtreme
To start this tutorial, you need an Angular 5+ application created using the Angular CLI. Refer to t ...
- 一些有意思的git
fs: https://github.com/psankar/simplefs https://github.com/gzc/isystem/blob/master/basic/Crash_Consi ...
- 使用oracle的存储过程的例子
十几年没有用oracle的存储过程了,有些东西已经忘了,没有想到今天又要用.在这里写个例子.它演示了存储过程的格式,游标的使用,循环.判断的使用,还有直接执行一个拼接的SQL的用法.以下是代码: cr ...