
爬虫----异步---高性能爬虫----aiohttp 和asycio 的使用
前情提要:
首先膜拜loco大佬
肯定有人像我一样.不会异步,发一下.
一:性能比对
多进程,多线程,(这里不建议使用,太消耗性能)
进程池和线程池 (可以适当的使用)
单线程+异步协程 (推荐使用)
二:案例演示
1->1: 普通的啥也不用的
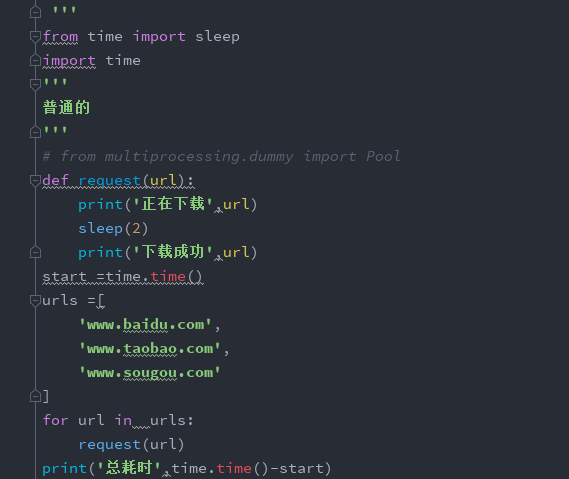
1->2:
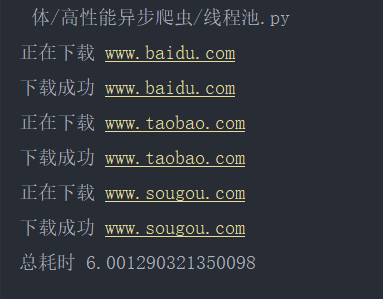
2->1:
使用线程池
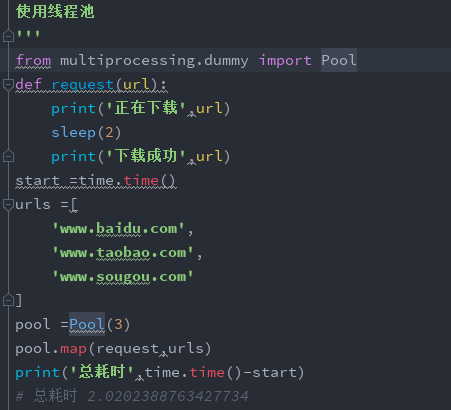
2->2:结果

三:异步协程
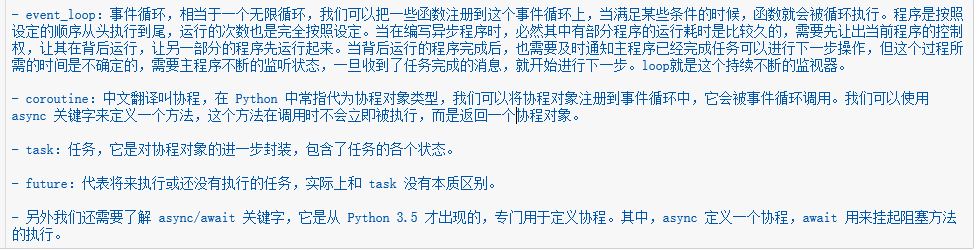
1: 协程的参数设定
2:协程的简单使用


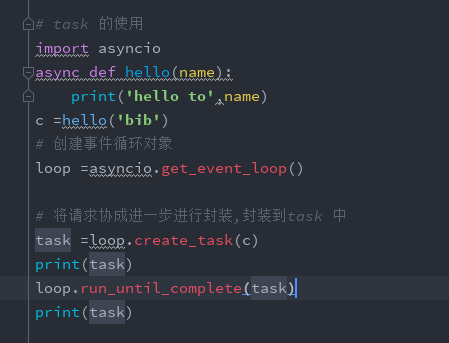
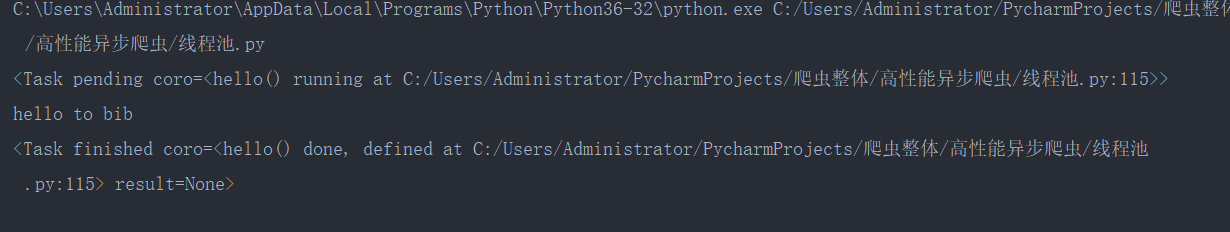
3:task的使用
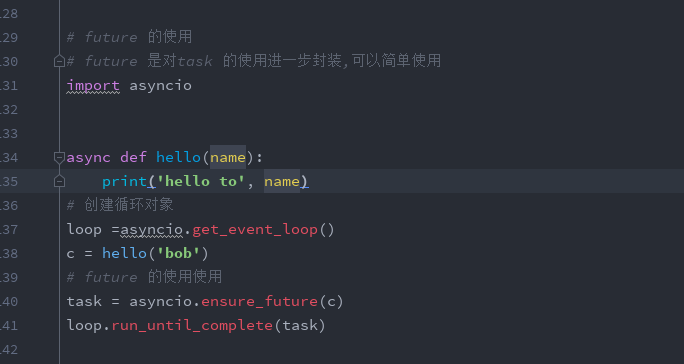
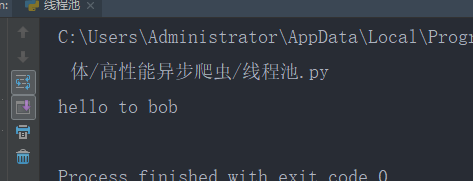
4:future 的使用
5:
回调函数的使用

四:支持异步请求网络的模块: aiohttp
import aiohttp

import asyncio

async def get_page(url):

    async with aiohttp.ClientSession() as session:      #with 前面都要加async

        async with await session.get(url=url) as response:  # 有io阻塞的都要加await
挂起

            page_text = await response.text() #read()  json()

            print(page_text)

start = time.time()

urls = [

    'http://127.0.0.1:5000/bobo',

    'http://127.0.0.1:5000/jay',

    'http://127.0.0.1:5000/tom',

    'http://127.0.0.1:5000/bobo',

    'http://127.0.0.1:5000/jay',

    'http://127.0.0.1:5000/tom',

    'http://127.0.0.1:5000/bobo',

    'http://127.0.0.1:5000/jay',

    'http://127.0.0.1:5000/tom'

]

tasks = []

loop = asyncio.get_event_loop()

for url in urls:

    c = get_page(url)

    task = asyncio.ensure_future(c)

    tasks.append(task)

loop.run_until_complete(asyncio.wait(tasks))

print('总耗时:',time.time()-start)
爬虫----异步---高性能爬虫----aiohttp 和asycio 的使用的更多相关文章
- 【Python爬虫】:使用高性能异步多进程爬虫获取豆瓣电影Top250
在本篇博文当中,将会教会大家如何使用高性能爬虫,快速爬取并解析页面当中的信息.一般情况下,如果我们请求网页的次数太多,每次都要发出一次请求,进行串行执行的话,那么请求将会占用我们大量的时间,这样得不偿 ...
- 八、asynicio模块以及爬虫应用asynicio模块(高性能爬虫)
asynicio模块以及爬虫应用asynicio模块(高性能爬虫) 一.背景知识 爬虫的本质就是一个socket客户端与服务端的通信过程,如果我们有多个url待爬取,只用一个线程且采用串行的方式执行, ...
- Python爬虫-01:爬虫的概念及分类
目录 # 1. 为什么要爬虫? 2. 什么是爬虫? 3. 爬虫如何抓取网页数据? # 4. Python爬虫的优势? 5. 学习路线 6. 爬虫的分类 6.1 通用爬虫: 6.2 聚焦爬虫: # 1. ...
- 放养的小爬虫--京东定向爬虫(AJAX获取价格数据)
放养的小爬虫--京东定向爬虫(AJAX获取价格数据) 笔者声明:只用于学习交流,不用于其他途径.源代码已上传github.githu地址:https://github.com/Erma-Wang/Sp ...
- crawler_爬虫_反爬虫策略
关于反爬虫和恶意攻击的一些策略和思路 有时网站经常受到恶意spider攻击,疯狂抓取网站内容,对网站性能有较大影响. 下面我说说一些反恶意spider和spam的策略和思路. 1. 通过日志分析来 ...
- Java 多线程爬虫及分布式爬虫架构探索
这是 Java 爬虫系列博文的第五篇,在上一篇 Java 爬虫服务器被屏蔽,不要慌,咱们换一台服务器 中,我们简单的聊反爬虫策略和反反爬虫方法,主要针对的是 IP 被封及其对应办法.前面几篇文章我们把 ...
- Java 多线程爬虫及分布式爬虫架构
这是 Java 爬虫系列博文的第五篇,在上一篇 Java 爬虫服务器被屏蔽,不要慌,咱们换一台服务器 中,我们简单的聊反爬虫策略和反反爬虫方法,主要针对的是 IP 被封及其对应办法.前面几篇文章我们把 ...
- 【Python网络爬虫一】爬虫原理和URL基本构成
1.爬虫定义 网络爬虫,即Web Spider,是一个很形象的名字.把互联网比喻成一个蜘蛛网,那么Spider就是在网上爬来爬去的蜘蛛.网络蜘蛛是通过网页的链接地址来寻找网页的.从网站某一个页面(通常 ...
- Python爬虫从入门到放弃(二十二)之 爬虫与反爬虫大战
爬虫与发爬虫的厮杀,一方为了拿到数据,一方为了防止爬虫拿到数据,谁是最后的赢家? 重新理解爬虫中的一些概念 爬虫:自动获取网站数据的程序反爬虫:使用技术手段防止爬虫程序爬取数据误伤:反爬虫技术将普通用 ...
随机推荐
- 纯css实现移动端横向滑动列表&&overflow:atuo;隐藏滚动条
<!DOCTYPE html> <html> <head> <title>横向滑动</title> <style type=" ...
- 游记-pkupc&cts2019
Day0 和boshi.Rayment组的队,昨天听学长说这次比赛可以加学分,他们信科的大部分人都会参加,估摸有两百多支队伍--然而奖品只有不到一百份 我要奖品呐! 上午十一点半到的北京,拉着行李提着 ...
- Nginx 路由重写
很多时候我们的真实路由是隐藏的,都经过重写后展现到前台,下面简单写两个我经常用到的几个: 一般在配置*.host(在http里面引入的server配置)的时候会用到每个不同网址的路由重写,每一个rew ...
- C# DateTime Subtract
DateTime start = DateTime.Now.AddDays(-20); DateTime end = DateTime.Now; TimeSpan ts = end.Subtract( ...
- poj 1837 天平问题(01背包变种)
题意:给你n个挂钩,m个砝码,要求砝码都用上,问有多少中方案数 题解:对于这道题目的状态,我们定义一个变量j为平衡度,当j=0的时候,表明天平平衡.定义dp[i][j]表达的含义为使用前n个砝码的时候 ...
- (一)JMS简介
一.简介 JMS即Java消息服务(Java Message Service)应用程序接口,是一个Java平台中关于面向消息中间件(MOM)的API,用于在两个应用程序之间,或分布式系统中发送消息,进 ...
- (二十)SpringBoot之集成mybatis:使用mybatis注解
一.使用mybatis注解的集成 1.1 引入maven依赖 <dependencies> <dependency> <groupId>org.springfram ...
- 从jvm源码看synchronized
从jvm源码看synchronized 索引 synchronized的使用 修饰实例方法 修饰静态方法 修饰代码块 总结 Synchronzied的底层原理 对象头和内置锁(ObjectMonito ...
- legacy
int bw = blockDim.x; int bh = blockDim.y; int tx = threadIdx.x%bw; int ty = threadIdx.y%bh; __shared ...
- css滑动门技术
滑动门的核心技术: 为了使各种特殊形状的背景能够自适应元素中文本内容的多少,以使自由拉伸滑动 利用css精灵(主要是背景位置)和盒子padding撑开宽度,以便适应不同字数的导航栏 一般经典布局 &l ...