
DAX 第七篇:分组聚合
DAX有三个用于生成分组聚合数据的函数,这三个函数有两个共同的特征:分组列和扩展列。
- 分组列是用于分组的列,只能来源于基础表中已存的列,分组列可以来源于同一个表,也可以来源于相关的列。
- 扩展列是由name和expression对构成的,name是字符串,expression是包含聚合函数的表达式。
在分组列和扩展列上,这三个函数有各自独特的处理方式。
一,SUMMARIZE
SUMMARIZE函数对相互关联的Table按照特定的一个字段(分组列)或多个字段,进行分组聚合。由于分组列是唯一的,通过SUMMARIZE函数,可以获得多列的唯一值构成的二维表:
SUMMARIZE(<table>, <groupBy_columnName>[, <groupBy_columnName>]…[, <name>, <expression>]…)
参数注释:
- table:必需参数,表示主表,可以是任何返回表的表达式。
- groupBy_columnName:可选参数,表示分组列,该列必须是table参数中的列,或者相关联表中的列。分组列必须使用列的完全限定名,格式是table[column],分组列可以有0个,1个或多个。
- name、expression:可选参数,表示自定义的汇总列/扩展列,该参数对总是成对出现的,name是expression计算结果的名称,expression用于计算列的聚合值。
该函数的返回值是一个汇总表,汇总表包含分组列和自定义的扩展列。
1,获得多列的唯一值
分组列是唯一的,可以不返回汇总列,而只返回分组列,这样得到的表是多列的唯一值。
SUMMARIZE(ResellerSales

      , DateTime[CalendarYear]

      , ProductCategory[ProductCategoryName]

      )
2,获得汇总数据
例如,对数据表 ResellerSales ,按照字段 DateTime[CalendarYear] 和 ProductCategory[ProductCategoryName]分组,计算 ResellerSales[SalesAmount]和 ResellerSales[DiscountAmount]的加和 。
SUMMARIZE(ResellerSales

      , DateTime[CalendarYear]

      , ProductCategory[ProductCategoryName]

      , "Sales Amount", SUM(ResellerSales[SalesAmount])

      , "Discount Amount", SUM(ResellerSales[DiscountAmount])

      )
该函数利用ResellerSales和DateTime、ProductCategory之间的关系,得到关联表数据(是一个中间临时表),按照DateTime[CalendarYear] 和 ProductCategory[ProductCategoryName] 对关联之后的数据进行分组,分别计算销售和折扣的加和。
注意,ResellerSales和DateTime,ResellerSales和ProductCategory 必须显式存在关系,否则,不能用于分组列中。
3,分组聚合的作用
第一是作为中间临时表,为后续的计算提供数据;第二是用于创建新表,在Modeling菜单中,通过“New Table”从DAX表达式中创建新的Table:
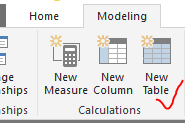
参考文档:SUMMARIZE – groupping in data models (DAX – Power Pivot, Power BI)
4,ROLLUP选项
ROLLUP函数用于对分组列进行上卷操作,该函数用于预定义多个分组集:
SUMMARIZE(<table>, <groupBy_columnName>[, <groupBy_columnName>]…[, ROLLUP(<groupBy_columnName>[,< groupBy_columnName>…])][, <name>, <expression>]…)
作用类似于TSQL的 rollup函数,例如,对于group by rollup(a,b) ,其表示的分组集是group by (), group by (a), group by (a,b)。
5,ROLLUPGROUP选项
ROLLUPGROUP函数用于计算小计组。如果把ROLLUPGROUP来代替ROLLUP函数,那么ROLLUPGROUP通过向groupBy_columnName列的结果添加汇总行来产生和ROLLUP相同的结果。 但是,在ROLLUP语法中添加ROLLUPGROUP()可用于防止汇总行中的部分小计。例如,ROLLUP(ROLLUPGROUP(A,B)),分组集是(A,B)和():
SUMMARIZE(ResellerSales_USD

      , ROLLUP(ROLLUPGROUP( DateTime[CalendarYear], ProductCategory[ProductCategoryName]))

      , "Sales Amount (USD)", SUM(ResellerSales_USD[SalesAmount_USD])

      , "Discount Amount (USD)", SUM(ResellerSales_USD[DiscountAmount])

)
6,ISSUBTOTAL选项
只能用于SUMMRIZE函数中,用于检查该列是否为小计组。
SUMMARIZE(<table>, <groupBy_columnName>[, <groupBy_columnName>]…[, ROLLUP(<groupBy_columnName>[,< groupBy_columnName>…])][, <name>, {<expression>|ISSUBTOTAL(<columnName>)}]…)
例如,使用该函数检查CalendarYear和 ProductCategoryName是否为小计组:
SUMMARIZE(ResellerSales_USD

      , ROLLUP( DateTime[CalendarYear], ProductCategory[ProductCategoryName])

      , "Sales Amount (USD)", SUM(ResellerSales_USD[SalesAmount_USD])

      , "Discount Amount (USD)", SUM(ResellerSales_USD[DiscountAmount])

      , "Is Sub Total for DateTimeCalendarYear", ISSUBTOTAL(DateTime[CalendarYear])

      , "Is Sub Total for ProductCategoryName", ISSUBTOTAL(ProductCategory[ProductCategoryName])

)
二,SUMMARIZECOLUMNS
该函数也用于分组聚合,和SUMMARIZE函数的差异在于分组列之间的关系是非必需的,分组列之间执行的交叉连接或自动存在。
SUMMARIZECOLUMNS( <groupBy_columnName> [, < groupBy_columnName >]…, [<filterTable>]…[, <name>, <expression>]…)
参数注释:
- groupBy_columnName:分组列,该列必须使用列的完全限定名,格式是base_table[column],该列必须是基础表中的现存列,分组列可以有0个,1个或多个。多个分组列之间的表不要求必须有关系,对于不同表,分组列之间是交叉连接(cross-join);对于相同表,分组列之间使用的是自动存在(auto-existed)。
- filterTable:可选参数,对分组列所在的基础表进行过滤, 过滤器表中存在的值用于在执行交叉连接/自动存在之前进行过滤。
- name、expression:可选参数,表示自定义的汇总列,该参数对总是成对出现的,name是expression计算结果的名称,expression用于计算列的聚合值。
返回值是汇总表,包含分组列和自定义列,返回的数据行中,至少包含一个非空值,如果在一个数据行中,所有expression的结果都是BLANK/NULL,那么该行不包含在汇总表中。
1,分组字段进行笛卡尔乘积
以下DAX按照SalesTerritory的字段Category 和 Customer的Education字段进行分组,并对Customer表进行过滤:
SUMMARIZECOLUMNS ( 'SalesTerritory'[Category], 'Customer' [Education], FILTER('Customer', 'Customer'[First Name] = “Alicia”) )
对过滤之后的数据进行汇总计算,返回的结果是Category和Eduction的笛卡尔乘积。
2,IGNORE选项
把包含NULL/BLANK的行过滤掉
SUMMARIZECOLUMNS(<groupBy_columnName>[, < groupBy_columnName >]…, [<filterTable>]…[, <name>, IGNORE(…)]…)
例如,如果Sum(Sales[Qty] )中包含一个NULL/BLANK,那么把该行从结果集中移除:
SUMMARIZECOLUMNS( Sales[CustomerId], "Total Qty", IGNORE( SUM( Sales[Qty] ) ), “BlankIfTotalQtyIsNot3”, IF( SUM( Sales[Qty] )=, ) )
3,其他选项
- NONVISUAL()
- ROLLUPADDISSUBTOTAL()
- ROLLUPGROUP()
三,GROUPBY
GROUPBY函数除了不能再扩展列中使用CALCULATE函数之外,和SUMMARIZE的用法相同:
GROUPBY (<table>, [<groupBy_columnName1>]..., [<name>, <expression>]… )
expression参数中不能使用CALCULATE函数,CURRENTGROUP 函数只能用于最顶层的表扫描(Table Scan)操作。
GROUPBY函数执行的操作是:
- #1:从指定的表(以及“to-one”方向的所有相关表)开始
- #2:按照所有的GroupBy列创建分组,每一个分组代表一组数据行
- #3:对于每一个分组,评估要增加的扩展列(Extension column)。与SUMMARIZE函数不同,不执行隐含的CALCULATE,并且不把该组放入到过滤器上下文中。
在该函数中,可以调用CURRENTGROUP 函数:
CURRENTGROUP()
该函数只能用于GROUPBY函数的expression参数中,表示当前分组。 CURRENTGROUP函数不带参数,仅支持作为以下聚合函数之一的第一个参数:AverageX,CountAX,CountX,GeoMeanX,MaxX,MinX,ProductX,StDevX.S,StDevX.P,SumX,VarX.S,VarX.P。举个例子,对Sales表,按照Country和Category进行分组,计算每个分组中Price * Qty的乘积之和。
GROUPBY (

Sales,

Geography[Country],

Product[Category],

“Total Sales”, SUMX( CURRENTGROUP(), Sales[Price] * Sales[Qty])

)
参考文档:
DAX 第七篇:分组聚合的更多相关文章
- MongoDB基础教程系列--第七篇 MongoDB 聚合管道
在讲解聚合管道(Aggregation Pipeline)之前,我们先介绍一下 MongoDB 的聚合功能,聚合操作主要用于对数据的批量处理,往往将记录按条件分组以后,然后再进行一系列操作,例如,求最 ...
- Atitit 数据存储的分组聚合 groupby的实现attilax总结
Atitit 数据存储的分组聚合 groupby的实现attilax总结 1. 聚合操作1 1.1. a.标量聚合 流聚合1 1.2. b.哈希聚合2 1.3. 所有的最优计划的选择都是基于现有统计 ...
- 第七篇 :微信公众平台开发实战Java版之如何获取微信用户基本信息
在关注者与公众号产生消息交互后,公众号可获得关注者的OpenID(加密后的微信号,每个用户对每个公众号的OpenID是唯一的.对于不同公众号,同一用户的openid不同). 公众号可通过本接口来根据O ...
- SSRS 系列 - 使用带参数的 MDX 查询实现一个分组聚合功能的报表
SSRS 系列 - 使用带参数的 MDX 查询实现一个分组聚合功能的报表 SSRS 系列 - 使用带参数的 MDX 查询实现一个分组聚合功能的报表 2013-10-09 23:09 by BI Wor ...
- 微软BI 之SSRS 系列 - 使用带参数的 MDX 查询实现一个分组聚合功能的报表
基于数据仓库上的 SSRS 报表展示,一般可以直接通过 SQL 查询,存储过程,视图或者表等多种方式将数据加载并呈现在报表中.但是如果是基于 Cube 多维数据集的数据查询,就不能再使用 SQL 的语 ...
- 微软BI 之SSRS 系列 - 报表中分组聚合中处理不规则层次结构的技巧(没有子元素的时候不展开, 删除+符号)
分组聚合的展开和收起效果在SSRS Report中非常常用,并且有时还要处理一些比较特别的情况.比如分组合并时有的层次结构是不规则的,有的组有两层,遇到这种情况应该如何处理? 注意到下面的这个需求 ...
- Django---Django的ORM的一对多操作(外键操作),ORM的多对多操作(关系管理对象),ORM的分组聚合,ORM的F字段查询和Q字段条件查询,Django的事务操作,额外(Django的终端打印SQL语句,脚本调试)
Django---Django的ORM的一对多操作(外键操作),ORM的多对多操作(关系管理对象),ORM的分组聚合,ORM的F字段查询和Q字段条件查询,Django的事务操作,额外(Django的终 ...
- 解剖SQLSERVER 第七篇 OrcaMDF 特性概述(译)
解剖SQLSERVER 第七篇 OrcaMDF 特性概述(译) http://improve.dk/orcamdf-feature-recap/ 时间过得真快,这已经过了大概四个月了自从我最初介绍我 ...
- 第七篇 Replication:合并复制-订阅
本篇文章是SQL Server Replication系列的第七篇,详细内容请参考原文. 订阅服务器就是复制发布项目的所有变更将传送到的服务器.每一个发布需要至少一个订阅,但是一个发布可以有多个订阅. ...
随机推荐
- 2019 Python100道 面试 题,你会几道?
0 遇到过得反爬虫策略以及解决方法? 1.通过headers反爬虫 2.基于用户行为的发爬虫:(同一IP短时间内访问的频率) 3.动态网页反爬虫(通过ajax请求数据,或者通过JavaScript生成 ...
- MySQL学习——操作存储过程
MySQL学习——操作存储过程 摘要:本文主要学习了使用DDL语句操作存储过程的方法. 了解存储过程 是什么 存储过程是一组为了完成特定功能的SQL语句集合. 使用存储过程的目的是将常用或复杂的工作预 ...
- JavaWeb之servlet(2)
servlet(2) ServletContext servlet的上下文 每个jvm的虚拟机中的每个web工程都只有一个ServletContext工程,即在一个web工程中,无论写了多少个Java ...
- AppBoxFuture(九): 组织结构与权限体系
权限体系是用于约束用户访问或操作资源的权利,这里的"资源"可以指数据,也可以指特定的功能(如审核订单).通常的权限体系设计是基于角色的访问控制方式,用户通过角色与权限进行关联. ...
- HTML5新标签与特性---多媒体
多媒体标签 embed:标签定义嵌入的内容 audio:播放音频 video:播放视频 多媒体 embed(会使用) embed可以用来插入各种多媒体,格式可以是 Midi.Wav.AIFF.AU.M ...
- Django和前端用ajax传输json等数据
需要传输的是下图中所有的input中客户端设置的数据 整个页面是用js生成,代码不长,但是用了许多拼接,看起来开比较乱,页面的核心就是下面的部分,有一些关键参数部分就不放了,可以跳过这个 下面开始重点 ...
- 【XML】XML基本结构以及XML-Schema约束
XML 简介 1998年2月,W3C正式批准了可扩展标记语言的标准定义,可扩展标记语言可以对文档和数据进行结构化处理,从而能够在部门.客户和供应商之间进行交换,实现动态内容生成,企业集成和应用开发.可 ...
- SQL Server 完整备份遇到的一个不常见的错误
1. 错误详情 有一次在手动执行数据库完整备份时遇到如下错误: 执行多次都是这个错误信息. 提示无法生成检查点,原因可能是由于系统资源(如磁盘或内存空间)不足或者有时是由于数据库损坏而造成的. 我们检 ...
- BayaiM__Linux安装MySQL的两种方法
BayaiM__Linux安装MySQL的两种方法 < 以下内容,纯属抄袭,如有雷同,爱咋咋地 > 阅读(21210) | 评论(4340) | 转发(5660) | 删除 编辑 ...
- [Go] 利用channel实现简单的工作池
先启动固定数量的goroutine,每个goroutine都在从channel中获取数据,如果这个channel为空,就阻塞等待在那里channel中传递一个Car类型,这个类型主要负责具体做的任务也 ...