
Dilated Neighborhood Attention Transformer概述
0.前言
发表时间:arxiv2022(2022.9.29)
1.针对的问题
之前的方法通过局部注意力机制来降低计算复杂度,但这削弱了自注意力的两个最理想特性:长程相互依赖建模和全局感受野。
2.主要贡献
•引入DiNA,一个简单、灵活和强大的稀疏全局注意力模式,它允许感受野指数增长,并捕获更长的上下文,而无需任何额外的计算负担。DiNA做到了这一点,同时保持了NA中引入的邻域的对称性。它还可以适应更大的分辨率,而无需扩展到更大的窗口尺寸。
•分析基于卷积,局部注意力和基于DiNA的模型中的理论感受野大小。
•引入DiNAT,一种新的分层视觉transformer,包括邻域注意力的膨胀和非膨胀变种。DiNAT利用了模型的渐进膨胀变化,更优化地扩展了感受野,有助于从细到粗的特征学习。
•使用DiNAT对图像分类、目标检测、实例和语义分割进行了广泛的实验,发现它在下游任务中比基于注意力和卷积的基线有明显的改善。此外,我们研究了各向同性和混合注意力变量,使用ImageNet-22K预训练的缩放实验,以及不同膨胀值的影响。
•通过增加膨胀支持和bfloat16使用能力,扩展NATTEN, 即NA对PyTorch的CUDA扩展,允许该方向的研究扩展到其他任务和应用。
3.方法
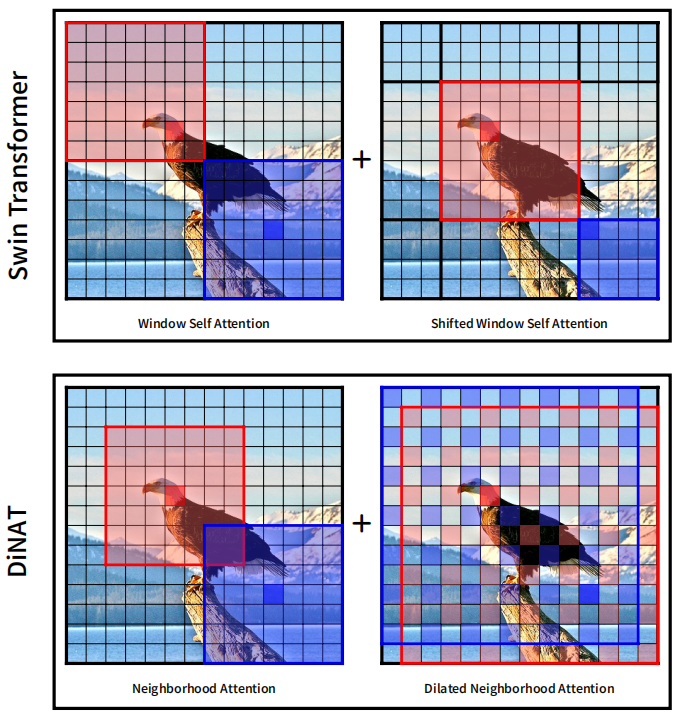
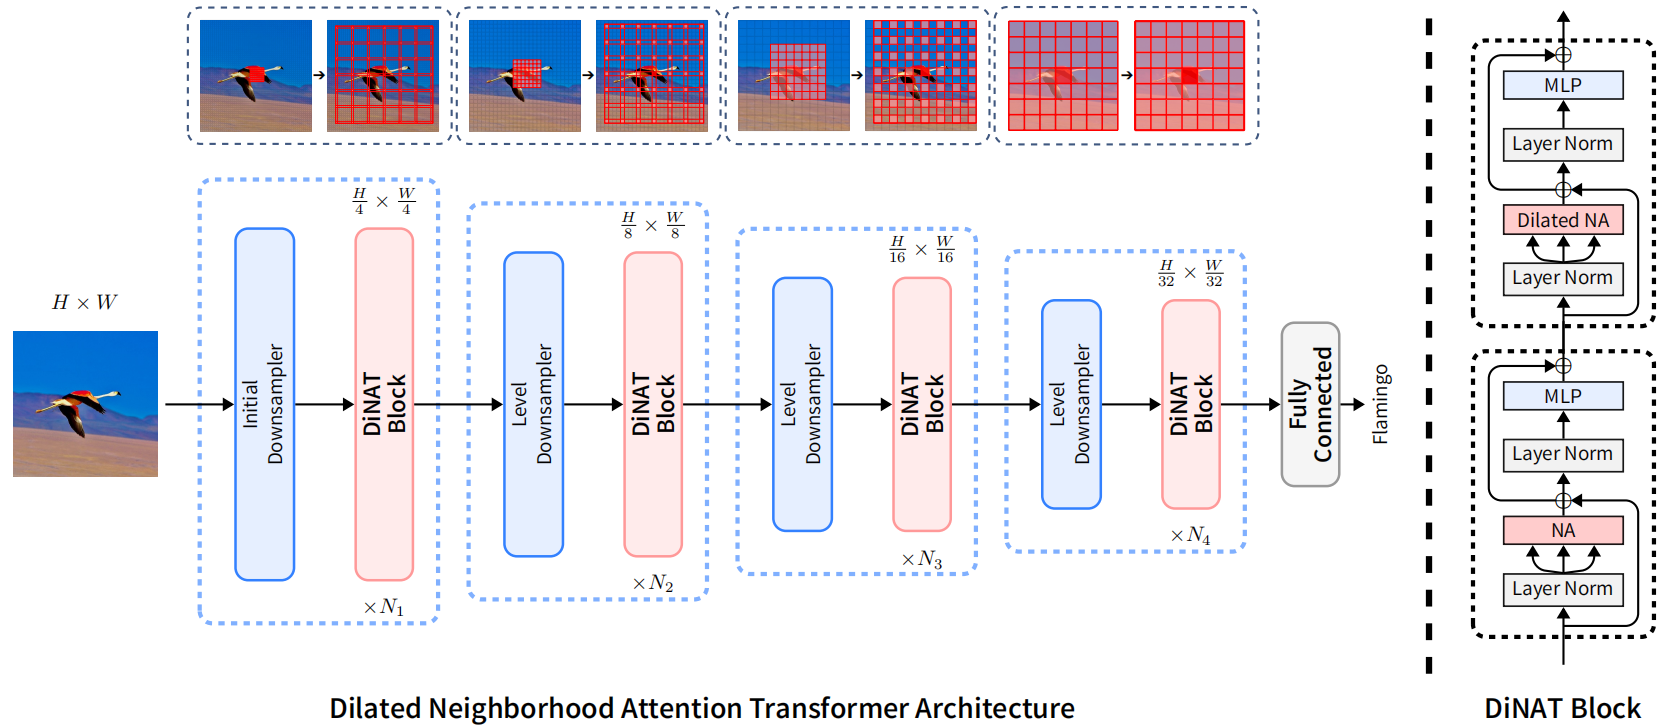
其实就是把膨胀卷积(空洞卷积)与作者之前的工作邻域注意力(NA)相结合,得到DiNA(Dilated Neighborhood attention),这是一种灵活而强大的稀疏全局注意力机制。它存在3个优点:1.捕获了更多的全局上下文。2.允许感受野指数增长。3.没有额外计算成本。Swin与DiNAT对比如下:
公式定义与自注意力类似,就是计算局限于邻域,DiNA的计算与NA类似,在NA中,如果ρj(i)表示token i的第j个最近邻,则在DiNA中,给定一个膨胀值δ,简单地将ρδj(i)定义为token i的第j个最近邻,满足:j mod δ = i mod δ。然后就可以将邻域大小为k的第i个token的δ膨胀率邻域注意力Ai(k,δ)定义为:
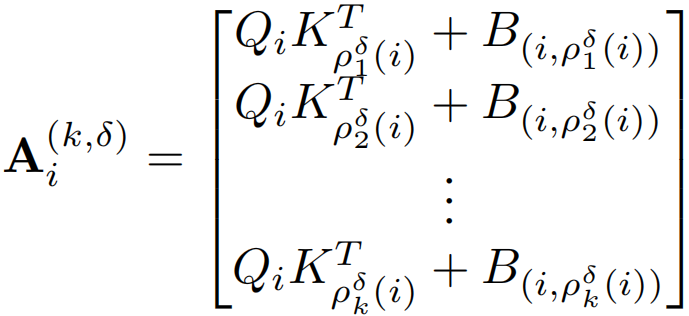
与上面类似得到
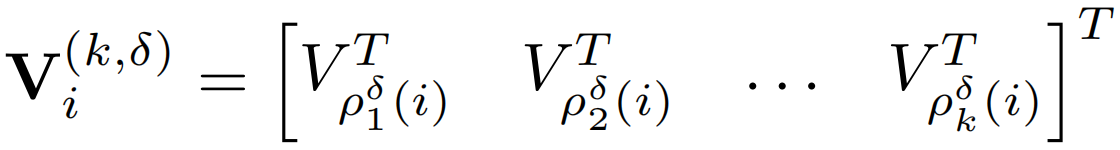
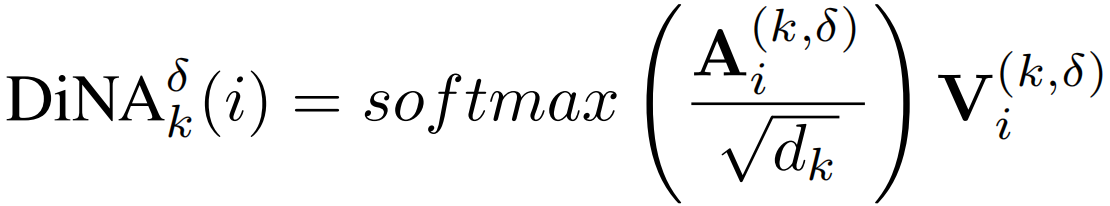
模型结构如下,与NAT模型相同:
4.补充
1.其实在NA之前就已经有类似卷积的注意力相关工作SASA了,但是效果却并不好,运行速度很慢,之前的观点普遍认为像这种注意力操作被认为效率极低且难以并行化,这也是Window Self Attention背后的动机之一,NA开始也存在同样的限制,即缺乏有效的实现,因为当时的深度学习或CUDA库都没有直接实现这样的操作,也是在NATTEN(邻域注意力CUDA扩展)出现之后在表现出效果。
2.论文中提到Swin由于其特殊的移位窗口设计,相比NAT和ConvNeXt拥有略大的接受域,但它打破了一个重要的属性:对称性。由于Swin的特征映射被划分为不重叠的窗口,同一窗口内的像素只关注彼此,而不考虑它们的位置(无论是在中心还是角落),这导致一些像素在周围看到不对称的上下文。
Dilated Neighborhood Attention Transformer概述的更多相关文章
- Attention & Transformer
Attention & Transformer seq2seq; attention; self-attention; transformer; 1 注意力机制在NLP上的发展 Seq2Seq ...
- 2. Attention Is All You Need(Transformer)算法原理解析
1. 语言模型 2. Attention Is All You Need(Transformer)算法原理解析 3. ELMo算法原理解析 4. OpenAI GPT算法原理解析 5. BERT算法原 ...
- 深度学习之Attention Model(注意力模型)
1.Attention Model 概述 深度学习里的Attention model其实模拟的是人脑的注意力模型,举个例子来说,当我们观赏一幅画时,虽然我们可以看到整幅画的全貌,但是在我们深入仔细地观 ...
- [深度概念]·Attention Model(注意力模型)学习笔记
此文源自一个博客,笔者用黑体做了注释与解读,方便自己和大家深入理解Attention model,写的不对地方欢迎批评指正.. 1.Attention Model 概述 深度学习里的Attention ...
- 深入浅出Transformer
Transformer Transformer是NLP的颠覆者,它创造性地用非序列模型来处理序列化的数据,而且还获得了大成功.更重要的是,NLP真的可以"深度"学习了,各种基于tr ...
- [NLP] REFORMER: THE EFFICIENT TRANSFORMER
1.现状 (1) 模型层数加深 (2) 模型参数量变大 (3) 难以训练 (4) 难以fine-tune 2. 单层参数量和占用内存分析 层 参数设置 参数量与占用内存 1 layer 0.5Bill ...
- 文本建模、文本分类相关开源项目推荐(Pytorch实现)
Awesome-Repositories-for-Text-Modeling repo paper miracleyoo/DPCNN-TextCNN-Pytorch-Inception Deep Py ...
- 关于NLP和深度学习,准备好好看看这个github,还有这篇介绍
这个github感觉很不错,把一些比较新的实现都尝试了: https://github.com/brightmart/text_classification fastText TextCNN Text ...
- BERT解析及文本分类应用
目录 前言 BERT模型概览 Seq2Seq Attention Transformer encoder部分 Decoder部分 BERT Embedding 预训练 文本分类试验 参考文献 前言 在 ...
- ACNet: 特别的想法,腾讯提出结合注意力卷积的二叉神经树进行细粒度分类 | CVPR 2020
论文提出了结合注意力卷积的二叉神经树进行弱监督的细粒度分类,在树结构的边上结合了注意力卷积操作,在每个节点使用路由函数来定义从根节点到叶子节点的计算路径,结合所有叶子节点的预测值进行最终的预测,论文的 ...
随机推荐
- 如何优雅地写LCD接口的使用
通过面向对象方法进行实现,可以多学习 参考链接: http://www.wujique.com/2021/05/16/lcd%e9%a9%b1%e5%8a%a8%e5%ba%94%e8%af%a5%e ...
- VUE学习-组件
组件 组件是可复用的 Vue 实例,且带有一个名字. <div id="components-demo"> <button-counter></but ...
- 右键无法新建word文件怎么办?
电脑用久了,总会出现奇奇怪怪的问题. 我最近遇到一个问题:鼠标右键无法新建word文件.如何解决此问题呢? 刚开始,我忍了.解决方法为:把word图标固定到任务栏,就好了呗,需要用的时候, ...
- js提取字符串开头公共部分
需求: 编写一个函数来查找字符串数组中的最长公共前缀. 如果不存在公共前缀,返回空字符串 "". 思路:记录数组中第一个字符串的每个字符,依次判断数组中的每个字符串是否都有这个字符 ...
- vue的:class设置多个值
vue的:class设置多个值 :class="[{ 'labTilTemplate': item.editType == 11 }, { 'txtBold': item.bold == 1 ...
- Unity Vuforia 动态替换识别图
1.在Unity里 Vuforia 用来做识别信息的是 StreamingAssets 下 Vuforia文件夹内的 Dat和XML 文件. 2.想要替换识别图需要在Vuforia官网里替换识别图 ( ...
- vue3使用echarts插件并实现点击下载图表功能
接到一个新的需求,就是用vue3制作一幅世界地图,并实现点击下载按钮将图表转变为图片下载到本地. 使用插件: html2canvasnpm安装: npm install html2canvas组件引入 ...
- COMP3357 Cryptography
课程内容笔记,自用,不涉及任何 assignment,exam 答案 Notes for self use, not included any assignments or exams Course ...
- 小白之Python-基础中的基础03
序列,目前看来很基础,东西比较多,难度开始加大...加油吧,骚年 Python之序列 1.数据结构:序列.容器(序列:索引.映射:键).集合2.列表.元组.字符串.Unicode字符串.buffer对 ...
- vue3 门户网站搭建8-字体
浏览器默认的可选字体比较少,如果没有合适的则需要额外下载并引入. 一般使用 开源字体即可,商用需要花钱~ 将下载好的 ttf 格式字体放入项目下文件夹: 样式文件中增加配置:(main.css) 即可 ...