
scrapy(一):基础用法
Scrapy 框架
Scrapy 简介
- Scray 是用python写的为了爬取网站数据,提取结构性数据的应用框架
Scrapy框架原理图
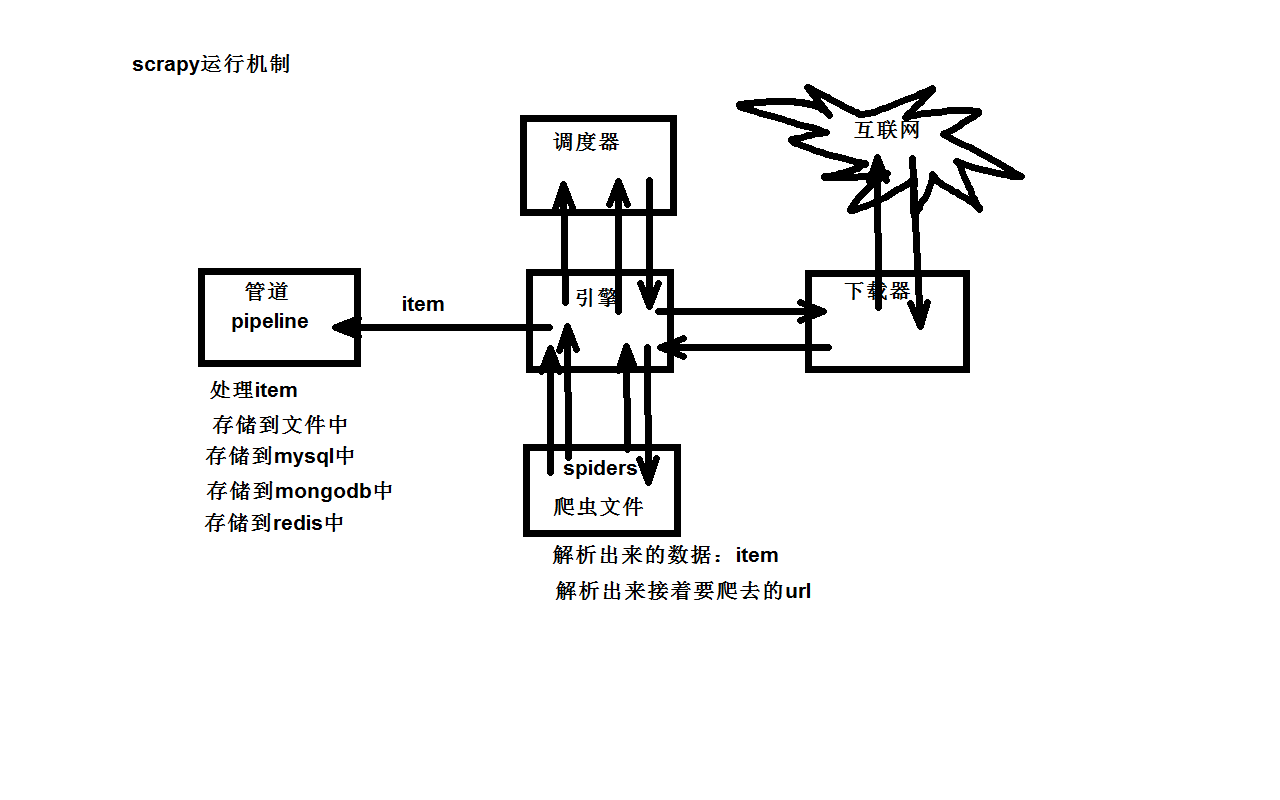
白话讲解Scrapy 运作流程
代码写好,程序开始运行...
- 引擎
:Hi!Spider`, 你要处理哪一个网站? Spider:老大要我处理xxxx.com。引擎:你把第一个需要处理的URL给我吧。Spider:给你,第一个URL是xxxxxxx.com。引擎:Hi!调度器,我这有request请求你帮我排序入队一下。调度器:好的,正在处理你等一下。引擎:Hi!调度器,把你处理好的request请求给我。调度器:给你,这是我处理好的request引擎:Hi!下载器,你按照老大的下载中间件的设置帮我下载一下这个request请求下载器:好的!给你,这是下载好的东西。(如果失败:sorry,这个request下载失败了。然后引擎告诉调度器,这个request下载失败了,你记录一下,我们待会儿再下载)引擎:Hi!Spider,这是下载好的东西,并且已经按照老大的下载中间件处理过了,你自己处理一下(注意!这儿responses默认是交给def parse()这个函数处理的)Spider:(处理完毕数据之后对于需要跟进的URL),Hi!引擎,我这里有两个结果,这个是我需要跟进的URL,还有这个是我获取到的Item数据。引擎:Hi !管道我这儿有个item你帮我处理一下!调度器!这是需要跟进URL你帮我处理下。然后从第四步开始循环,直到获取完老大需要全部信息。管道``调度器:好的,现在就做!
制作Scrapy爬虫步骤
1.新建项目
scrapy startproject mySpider
- 此时会出现一个目录结构(以下对各文件进行解释)
scrapy.cfg :项目的配置文件

mySpider/ :项目的Python模块,将会从这里引用代码

mySpider/items.py :项目的目标文件

mySpider/pipelines.py :项目的管道文件

mySpider/settings.py :项目的设置文件

mySpider/spiders/ :存储爬虫代码目录```
2.制作爬虫
scrapy genspider ItCast www.itcast.cn
- 此时会创建一个 爬虫文件夹,打开ItCast.py 爬虫文件会看到以下代码:
class ItcastSpider(scrapy.Spider):

    name = "itcast"   #爬虫的名字

    allowed_domains = ["itcast.cn"]   # 是搜索的域名范围,也就是爬虫的约束区域,规定爬虫只爬取这个域名下的网页,不存在的URL会被忽略。

    start_urls = (

        'http://www.itcast.cn/',

    )  # 爬取的URL元祖/列表。爬虫从这里开始抓取数据,所以,第一次下载的数据将会从这些urls开始。其他子URL将会从这些起始URL中继承性生成

    def parse(self, response):  # 解析的方法,每个初始URL完成下载后将被调用,调用的时候传入从每一个URL传回的Response对象来作为唯一参数

        pass
3. 明确目标(mySpider/items.py)
- 想要爬取那些信息,在Item里定义结构化数据字段,保存爬取到的数据
4.保存数据(pipelines.py)
- 在管道文件中设置保存数据的方法,可以保存到本地或者数据库
5.运行爬虫程序
一个简单例子
(1) items.py
- 想要爬取的信息
import scrapy

class ItcastItem(scrapy.Item):

    name = scrapy.Field()

    title = scrapy.Field()

    info = scrapy.Field()
(2) itcastspider.py
- 写爬虫程序
#!/usr/bin/env python

# -*- coding:utf-8 -*-

import scrapy

from mySpider.items import ItcastItem

# 创建一个爬虫类

class ItcastSpider(scrapy.Spider):

    # 爬虫名

    name = "itcast"

    # 允许爬虫作用的范围

    allowd_domains = ["http://www.itcast.cn/"]

    # 爬虫其实的url

    start_urls = [

        "http://www.itcast.cn/channel/teacher.shtml#aandroid",

    ]

    def parse(self, response):

        #with open("teacher.html", "w") as f:

        #    f.write(response.body)

        # 通过scrapy自带的xpath匹配出所有老师的根节点列表集合

        teacher_list = response.xpath('//div[@class="li_txt"]')

        # 遍历根节点集合

        for each in teacher_list:

            # Item对象用来保存数据的

            item = ItcastItem()

            # name, extract() 将匹配出来的结果转换为Unicode字符串

            # 不加extract() 结果为xpath匹配对象

            name = each.xpath('./h3/text()').extract()

            # title

            title = each.xpath('./h4/text()').extract()

            # info

            info = each.xpath('./p/text()').extract()

            item['name'] = name[0]

            item['title'] = title[0]

            item['info'] = info[0]

            yield item
(3) setting.py 修改
ROBOTSTXT_OBEY = True

DOWNLOAD_DELAY = 4   #防止爬取过快丢失数据

DEFAULT_REQUEST_HEADERS = {

    "User-Agent" : "Mozilla/5.0 (compatible; MSIE 9.0; Windows NT 6.1; Trident/5.0;",

    'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8'

}

ITEM_PIPELINES = {

    'tencent.pipelines.TencentPipeline': 300,

}
(4) pipelines.py
- 数据保存到本地
# -*- coding: utf-8 -*-

import json

class ItcastPipeline(object):

    # __init__方法是可选的,做为类的初始化方法

    def __init__(self):

        # 创建了一个文件

        self.filename = open("teacher.json", "w")

    # process_item方法是必须写的,用来处理item数据

    def process_item(self, item, spider):

        jsontext = json.dumps(dict(item), ensure_ascii = False) + "\n"

        self.filename.write(jsontext.encode("utf-8"))

        return item

    # close_spider方法是可选的,结束时调用这个方法

    def close_spider(self, spider):

        self.filename.close()
(5)运行爬虫程序
scrapy crawl itcast
scrapy(一):基础用法的更多相关文章
- scrapy之基础概念与用法
scrapy之基础概念与用法 框架 所谓的框架就是一个项目的半成品.也可以说成是一个已经被集成了各种功能(高性能异步下载.队列.分布式.解析.持久化等)的具有很强通用性的项目模板. 安装 Linux: ...
- 小白学 Python 爬虫(35):爬虫框架 Scrapy 入门基础(三) Selector 选择器
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 小白学 Python 爬虫(38):爬虫框架 Scrapy 入门基础(六) Item Pipeline
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- PropertyGrid控件由浅入深(二):基础用法
目录 PropertyGrid控件由浅入深(一):文章大纲 PropertyGrid控件由浅入深(二):基础用法 控件的外观构成 控件的外观构成如下图所示: PropertyGrid控件包含以下几个要 ...
- logstash安装与基础用法
若是搭建elk,建议先安装好elasticsearch 来自官网,版本为2.3 wget -c https://download.elastic.co/logstash/logstash/packag ...
- elasticsearch安装与基础用法
来自官网,版本为2.3 注意elasticsearch依赖jdk,2.3依赖jdk7 下载rpm包并安装 wget -c https://download.elastic.co/elasticsear ...
- BigDecimal最基础用法
BigDecimal最基础用法 用字符串生成的BigDecimal是不会丢精度的. 简单除法. public class DemoBigDecimal { public static void mai ...
- Vue组件基础用法
前面的话 组件(Component)是Vue.js最强大的功能之一.组件可以扩展HTML元素,封装可重用的代码.根据项目需求,抽象出一些组件,每个组件里包含了展现.功能和样式.每个页面,根据自己所需, ...
- Smarty基础用法
一.Smarty基础用法: 1.基础用法如下 include './smarty/Smarty.class.php';//引入smarty类 $smarty = new Smarty();//实例化s ...
- 前端自动化测试神器-Katalon的基础用法
前言 最近由于在工作中需要通过Web端的功能进行一次大批量的操作,数据量大概在5000左右,如果手动处理, 完成一条数据的操作用时在20秒左右的话,大概需要4-5个人/天的工作量(假设一天8小时的工作 ...
随机推荐
- python模拟网站登陆-滑动验证码
普通滑动验证 以http://admin.emaotai.cn/login.aspx为例这类验证码只需要我们将滑块拖动指定位置,处理起来比较简单.拖动之前需要先将滚动条滚动到指定元素位置. impor ...
- 十六进制颜色码及其表示-(6 digit color code)
我们知道对于RGB颜色系统,颜色是由三个256位的十进制数值表示的: (R:0-255,G:0-255,B:0-255) 那么一个三元组可以确定一种颜色. 然而,在很多配置文件中颜色并不是直接用十进制 ...
- cb01a_c++_数据结构_顺序容器_STL_deque类
/*cb01a_c++_数据结构_顺序容器_STL_deque类deque是一个动态数组,比vector更加灵活.两者都属于动态数组deque与vector非常类似deque可以在数组开头和末尾插入和 ...
- redis过期键的策略
一.过期时间设置: 127.0.0.1:6379> expire key seconds //设置键的过期时间为多少秒 127.0.0.1:6379> setex key seconds ...
- Flutter学习笔记(38)--自定义控件之组合控件
如需转载,请注明出处:Flutter学习笔记(38)--自定义控件之组合控件 在开始之前想先写点其他的,emm...就是今天在学习到自定义控件的时候,由于自定义控件这块一直是我的短板,无论是Andro ...
- 第四模块 :微服务调用链监控CAT架构和实践
采样率:每一个请求为都进行记录,或者100次请求为记录50次 各个开源框架都满足opentracing的标准,只要使用opentracing标准埋点的客户端,可以使用不同的客户端去展示,opentra ...
- java scoket Blocking 阻塞IO socket通信四
记住NIO在jdk1.7版本之前是同步非阻塞的,以前的inputsream是同步阻塞的,上面学习完成了Buffer现在我们来学习channel channel书双向的,以前阻塞的io的inputstr ...
- 设计模式系列之外观模式(Facade Pattern)——提供统一的入口
说明:设计模式系列文章是读刘伟所著<设计模式的艺术之道(软件开发人员内功修炼之道)>一书的阅读笔记.个人感觉这本书讲的不错,有兴趣推荐读一读.详细内容也可以看看此书作者的博客https:/ ...
- 用JS实现改变文本框的只读属性
<input id="aaa" readonly><input id="bbb" readonly> <script>doc ...
- Github中添加SSH key
1-创建密钥,在终端输入下面的命令 ssh-keygen -t rsa -b -C "你的邮箱" //双引号不能去 要求输入密码,建议回车使用空密码方便以后的每次连接,此时会生成一 ...