
Learning Invariant Deep Representation for NIR-VIS Face Recognition
查找异质图像匹配的过程中,发现几篇某组的论文,都是关于NIR-VIS的识别问题,提到了许多处理异质图像的处理方法,网络结构和idea都很不错,记录其中一篇。
其余两篇:
Wasserstein CNN: Learning Invariant Features for NIR-VIS Face Recognition
A Light CNN for Deep Face Representation with Noisy Labels
摘要
VIS-NIR(可见光与近红外)面部识别仍然是异质图像识别中的挑战。本文只用一个网络来映射NIR和VIS图像至一个紧凑的欧式空间。网络的低级层仅仅在大规模VIS数据中训练。每个卷积层由简单的maxout operator实现。网络的高级层被划分为两个正交的子空间,分别包括模态不变身份信息(modality-invariant identity information)和模态变化光谱信息(modality-variant spectrum information)。我们的联合公式在训练时引导交替最小化方法得到深度表示,测试时高效计算异质数据。实验证明了在CASIA NIR-VIS 2.0面部识别数据中实现94 percent的正确率,仅仅有64D大小的表示,比之前低了58 percent的错误率。
1. 介绍
NIR图像提供了廉价且简单的方式来提高在低光照情况下的面部识别能力。对于光照变换没有VIS那么敏感,所以被广泛应用于安检等。在真实应用中,NIR往往需要和VIS一起使用,导致了两者之间的匹配问题。这个问题可称为:NIR-VIS 异质面部识别问题。
NIR与VIS属于不同光谱,自然有很大的外表差异。所以深度网络在VIS数据训练后不含有NIR光谱信息,所以无法很好的解决NIR问题。怎样利用大规模VIS面部数据来探索NIR和VIS面部模态不变表示值得思考。得益于网络数据,我们可以容易获得大量VIS面部数据,然而成对的NIR数据难以获得。怎样在小规模NIR-VIS数据中学习也是一个中心问题。
之前的NIR-VIS匹配方法经常利用trick来减轻外观差异,通过移除一些可能含有光谱信息的主子空间。Chen在2012提出面部外观由身份信息(identity information)和变化信息(variation information eg.,lighting,poses,expressions)组成。受启发于此,本文提出一个网络来学习Invariant Deep Representation (IDR)同时包含NIR和VIS人脸信息,利用一个单一网络来将NIR和VIS图像同时映射到一个压缩后的欧式空间,使得NIR和VIS图像在嵌入空间embedding space中可以直接对应到面部相似性。
我们的网络首先在大规模VIS数据中训练,卷积层和全连接由简化形式的maxout operator实现。 这个网络使得我们学习的到的表示对于类内个体变化很鲁棒。然后,网络底层固定,微调NIR数据。高层划分为两个正交子空间:模态不变身份信息(modality-invariant identity information)和模态变化光谱信息(modality-variant spectrum information)。这个正交限制和maxout operator在高层可以缩减参数空间,因此避免了在小的NIR-VIS数据集上的过拟合。本文提出的IDR达到了SOTA,贡献如下:
- 一个高效深度网络结构学习模态不变表示,交替最小化高效优化。这个结构可以自然结合之前的不变特征提取和子空间学习到一个统一网络。
- 两个正交子空间嵌入网络中来建模身份和光谱信息。使得可以提取压缩后的表示,减小了小数据中的过拟合问题。
- 在数据集CASIA NIR-VIS 2.0面部数据上以64维的表示达到SOTA。
2. 相关工作
许多工作提出来减轻异质图像的外观差异。大多数方法可以分为三类:image synthesis, subspace learning、invariant feature extraction。
1)Image synthesis
主要从一个模态合成面部图像到另一个模态使得异质图像可在同一距离空间比较。
2)subspace learning
学习映射异质数据到一个共同的空间。当前sota方法是通过移除一些主子空间成分来解决。
3)Invariant feature extraction
即寻找模态不变特征使得对光照鲁棒。传统方法较多。
尽管很多方法,NIR-VIS识别表现仍然很low。远不如VIS数据结果好。很少有dl方法处理NIR-VIS,所以本文用DL方法来解决。
3. Invariant Deep Representation
本节介绍子空间分解和不变性特征提取,来学习模态不变深度表示。

注意到移除光谱信息有助于提高NIR-VIS识别表现。我们进一步三个映射矩阵(W,P,见上图)来建模身份不变信息和不变光谱信息。所以特征表示可以表示如下:
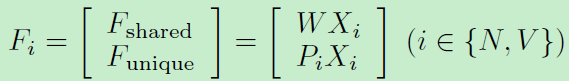
WX和PX分别代表共享特征和独立特征。考虑到子空间分解特性关于矩阵W和P:我们进一步提出一个正交限制使他们互相无关:
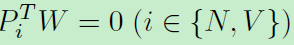
利用softmax函数来训练整个网络:

优化方法:
上式包含一些非凸变量,我们利用一种交替优化方法来最小化目标函数。首先根据朗格朗日乘子,重写上述函数:
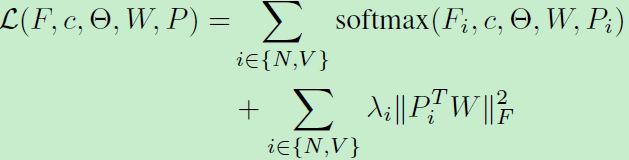
待优化参数有网络参数、W、P。利用交替优化更新,网络参数初始化利用Xavier,W和P初始化:
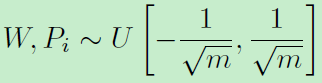
网络结构:lightened CNN B network(同作者另一作品:A Light CNN for Deep Face Representation with Noisy Labels)网络包括9个卷积层+4个最大池化层+全连接。Dropout设为0.7。初始学习率0.001,降到0.00001。基于该网络实现本文,特征层用来映射低级特征到两个正交子空间。
4. 其他要点
算法分析:分析本文提出的不变性深度表征: invariant deep representation (IDR)
我们实现了两种版本的IDR:DR表示IDR没有NIR特征和VIS特征。即仅仅训练卷积网络,没有子空间分解。这会导致大量参数在全连接和特征层,导致在小数据NIR-VIS上过拟合。特征层的maxout operator也有助于减少过拟合。因此,IDRm表示IDR没有maxout operator在特征层。
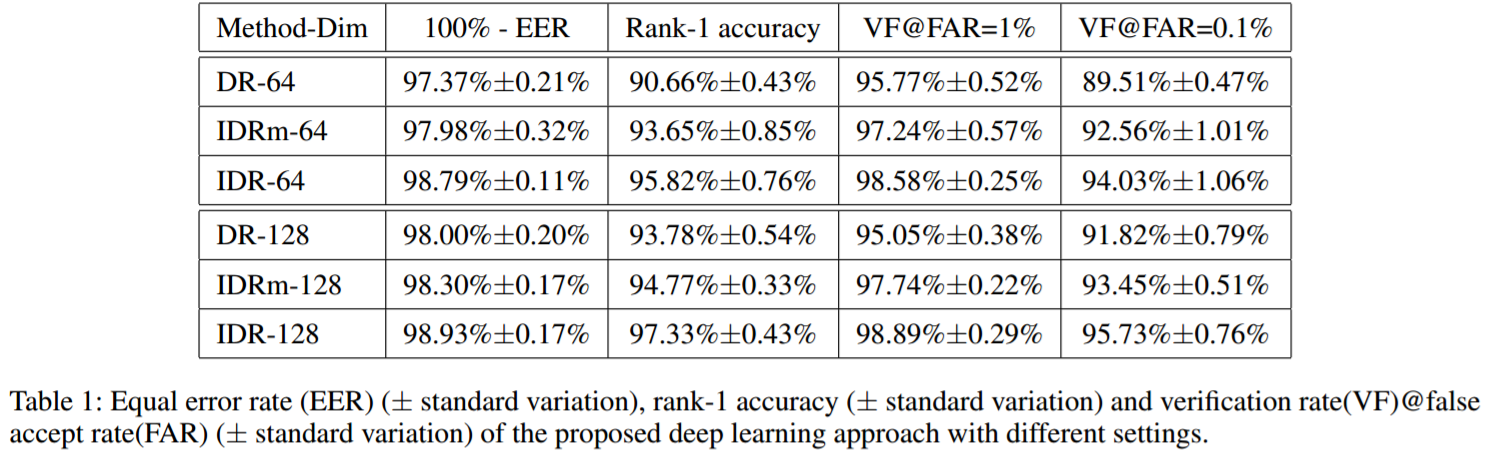
上图表明IDR是最好的结果。对比IDR和IDRm,注意到maxout operator在最后一个卷积层可进一步降低equal error rate,并提高表现。
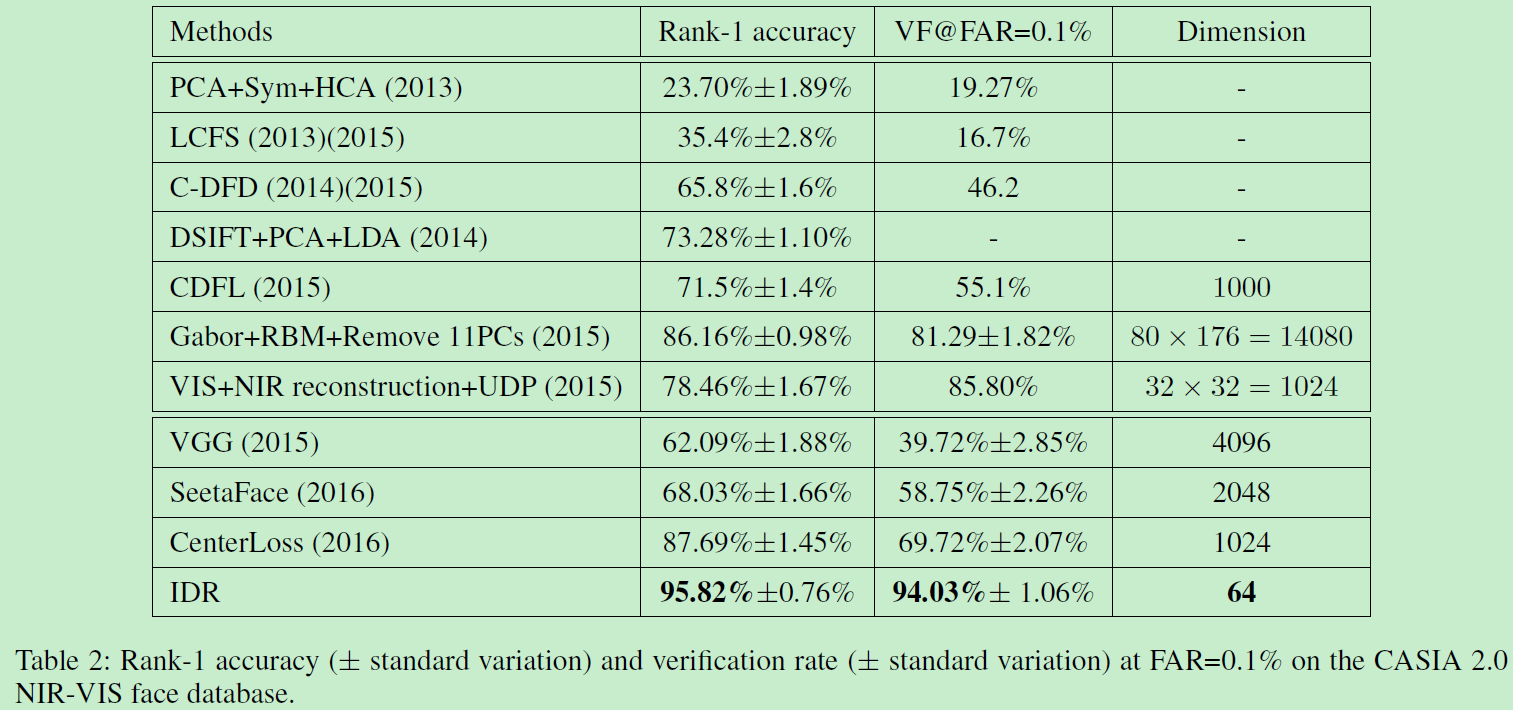
最后再附两张碾压性能图:

Learning Invariant Deep Representation for NIR-VIS Face Recognition的更多相关文章
- 论文笔记之:UNSUPERVISED REPRESENTATION LEARNING WITH DEEP CONVOLUTIONAL GENERATIVE ADVERSARIAL NETWORKS
UNSUPERVISED REPRESENTATION LEARNING WITH DEEP CONVOLUTIONAL GENERATIVE ADVERSARIAL NETWORKS ICLR 2 ...
- Wasserstein CNN: Learning Invariant Features for NIR-VIS Face Recognition
承接上上篇博客,在其基础上,加入了Wasserstein distance和correlation prior .其他相关工作.网络细节(maxout operator).训练方式和数据处理等基本和前 ...
- (转)Understanding, generalisation, and transfer learning in deep neural networks
Understanding, generalisation, and transfer learning in deep neural networks FEBRUARY 27, 2017 Thi ...
- A Gentle Introduction to Transfer Learning for Deep Learning | 迁移学习
by Jason Brownlee on December 20, 2017 in Better Deep Learning Transfer learning is a machine learni ...
- [译]深度神经网络的多任务学习概览(An Overview of Multi-task Learning in Deep Neural Networks)
译自:http://sebastianruder.com/multi-task/ 1. 前言 在机器学习中,我们通常关心优化某一特定指标,不管这个指标是一个标准值,还是企业KPI.为了达到这个目标,我 ...
- paper 124:【转载】无监督特征学习——Unsupervised feature learning and deep learning
来源:http://blog.csdn.net/abcjennifer/article/details/7804962 无监督学习近年来很热,先后应用于computer vision, audio c ...
- 论文笔记之:Learning Cross-Modal Deep Representations for Robust Pedestrian Detection
Learning Cross-Modal Deep Representations for Robust Pedestrian Detection 2017-04-11 19:40:22 Moti ...
- 转:无监督特征学习——Unsupervised feature learning and deep learning
http://blog.csdn.net/abcjennifer/article/details/7804962 无监督学习近年来很热,先后应用于computer vision, audio clas ...
- Incentivizing exploration in reinforcement learning with deep predictive models
Stadie, Bradly C., Sergey Levine, and Pieter Abbeel. "Incentivizing exploration in reinforcemen ...
随机推荐
- python类继承的重写和super
给已经存在的类添加新的行为,继承是非常好的实现方式.但是如果要改变行为呢?比如在Python继承扩展内置类,我们的contact类只允许一个名字和一个邮箱,但是如果要对某些人增加电话号码呢?这里可以通 ...
- mybatis多数据源报错
2018-12-06 16:58:35,709 [ main ] - [ INFO ] [ org.springframework.core.KotlinDetector : 57 ] - Kotli ...
- 2017-12-18python全栈9期第三天第四节之str的索引与切片
#!/user/bin/python# -*- coding:utf-8 -*-s = 'zdlswwzl's1 = s[0]print(s1)s2 = s[-1]print(s2)s3 = s[0: ...
- protobuf 编译安装
1.protobuf是google公司提出的数据存储格式,详细介绍可以参考:https://developers.google.com/protocol-buffers 2.下载最新的protobuf ...
- 虚拟机部署hadoop集群准备工作之多虚拟机设置网络信息
安装好了centos6.4(最简版)后 1,静态IP设置 查看虚拟机的网络设置信息来配置
- VScode 1.13 gocode提示dial tcp 216.239.37.1:443: connectex: A connection attempt failed because the connected..
在将VScode升级至 1.13后让升级gocode,在升级时报出如下错误 D:\go_work\src>go get -u -v github.com/mdempsky/gocode gith ...
- 开源框架.netCore DncZeus学习(四)项目升级
今天发现开源代码从1.0.0.1升级到了1.0.1.0,主要去掉了id主键,升级办法打开DncZeus,右键Git Bash Here,输入以下命令 合并失败,因为上一节尝试修改了几个代码,解决办法 ...
- docker之搭建私有镜像仓库和公有仓库
一.搭建私有仓库 1.docker pull registry #下载registry镜像并启动 2. docker run -d -v /opt/registry:/var/lib/registry ...
- Prolog 逻辑推导语言
Prolog https://en.wikipedia.org/wiki/Prolog Prolog is a general-purpose logic programming language a ...
- [译]使用Command模式和MediatR简化你的控制器
原文 你希望保持你的controller足够简单. 你的controller越来越臃肿,你听说command模式是一个给controller瘦身的解决方案. 但是你不知道command模式是否适合你的 ...