
scrapy中pipeline的一点综合知识
初次学习scrapy ,觉得spider代码才是最重要的,越往后学,发现pipeline中的代码也很有趣,
今天顺便把pipeline中三种储存方法写下来,算是对自己学习的一点鼓励吧,也可以为后来者的学习提供
绵薄之力,写的不怎么好,谅解
爬虫7部曲,虽然我不知道其他人是规划的
1.创建工程
scrapy startproject xiaohuawang
2.进入xiaohuawang目录 ,命名爬虫名和爬取的域名
cd xiaohuawang
scrapy genspider xhwang
此时在能看到如下结构
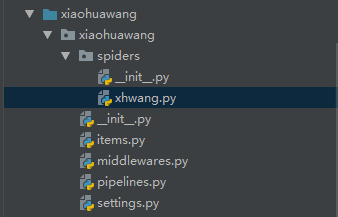
scrapy.cfg 项目的主配置信息,用来部署scrapy时使用,爬虫相关的配置信息在settings.py文件中。
items.py 设置数据存储模板,用于结构化数据,
pipelines 数据处理行为,如:一般结构化的数据持久化
settings.py 配置文件,如:递归的层数、并发数,延迟下载等。
spiders 爬虫目录,如:创建文件,编写爬虫规则
xhwang.py 爬虫主要代码
3、编写item (数据模板) 这里只编写两项
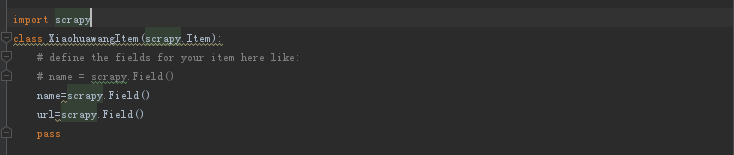
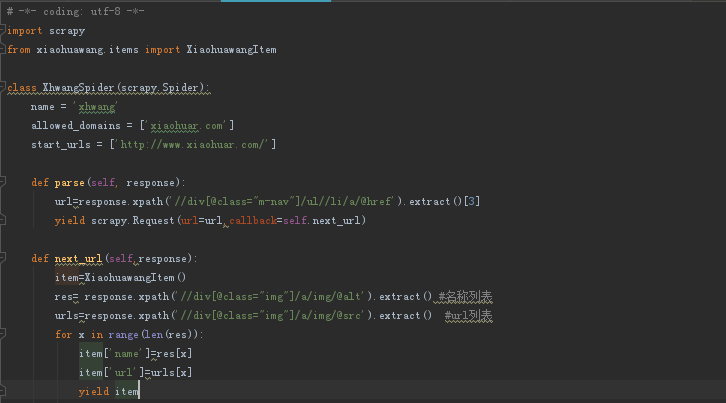
4、编写爬虫,爬虫主体代码还是挺容易理解的
5、编写pipeline(重点)此处编写了三种 (保存到mysql 、保存到json文件、以及将图片存储到本)
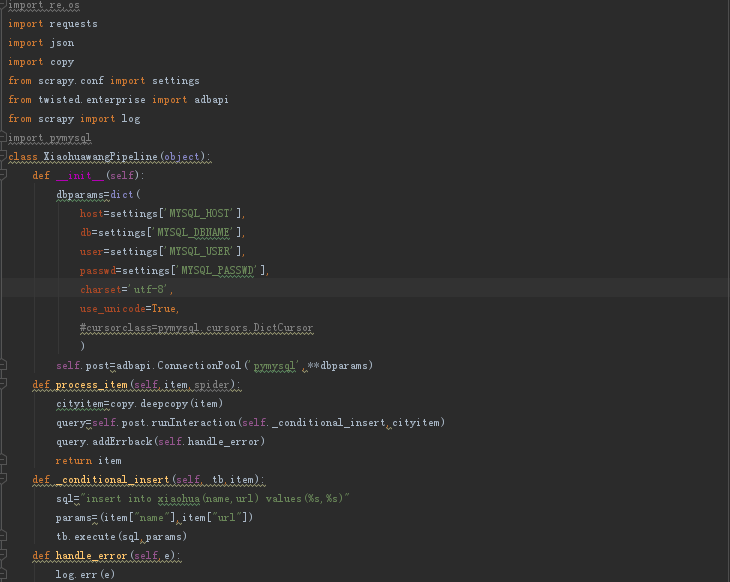
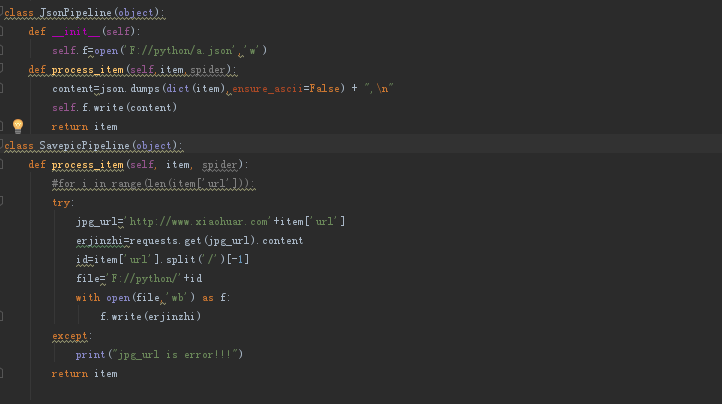
6、settings设置,为了使三种pipeline均生效需要设置如下 数字越小优先级越高

7、运行scrapy crawl xhwang
scrapy中pipeline的一点综合知识的更多相关文章
- 爬虫(十三):scrapy中pipeline的用法
当Item 在Spider中被收集之后,就会被传递到Item Pipeline中进行处理 每个item pipeline组件是实现了简单的方法的python类,负责接收到item并通过它执行一些行为, ...
- Scrapy中使用cookie免于验证登录和模拟登录
Scrapy中使用cookie免于验证登录和模拟登录 引言 python爬虫我认为最困难的问题一个是ip代理,另外一个就是模拟登录了,更操蛋的就是模拟登录了之后还有验证码,真的是不让人省心,不过既然有 ...
- python爬虫之scrapy的pipeline的使用
scrapy的pipeline是一个非常重要的模块,主要作用是将return的items写入到数据库.文件等持久化模块,下面我们就简单的了解一下pipelines的用法. 案例一: items池 cl ...
- scrapy中下载文件和图片
下载文件是一种很常见的需求,例如当你在使用爬虫爬取网站中的图片.视频.word.pdf.压缩包等的时候 scrapy中提供了FilesPipeline和ImagesPipeline,专门用来下载文件和 ...
- python的scrapy框架的使用 和xpath的使用 && scrapy中request和response的函数参数 && parse()函数运行机制
这篇博客主要是讲一下scrapy框架的使用,对于糗事百科爬取数据并未去专门处理 最后爬取的数据保存为json格式 一.先说一下pyharm怎么去看一些函数在源码中的代码实现 按着ctrl然后点击函数就 ...
- Java中实现异常处理的基础知识
Java中实现异常处理的基础知识 异常 (Exception):发生于程序执行期间,表明出现了一个非法的运行状况.许多JDK中的方法在检测到非法情况时,都会抛出一个异常对象. 例如:数组越界和被0除. ...
- C#中位、字节等知识
本文介绍C#中位.字节等知识. 1. 位(bit) 位(bit)有叫做比特,指二进制中的一位,是二进制的最小信息单位. bit也被称作小b,用b表示. 2. 字节(bytes) 8位表示一个字节. 由 ...
- OD提示 "为了执行系统不支持的动作, OllyICE 在这个被调试的程序中注入了一点代码, 但是经过5秒仍未收到响应..." 解决办法
别的OD就可以,我自己整合过的一个很顺手的OD就是不行,最后找到了解决办法: 转自:http://bbs.pediy.com/showthread.PHP?t=97629 -------------- ...
- Scrapy中使用Django的Model访问数据库
Scrapy中使用Django的Model进行数据库访问 当已存在Django项目的时候,直接引入Django的Model来使用比较简单 # 使用以下语句添加Django项目的目录到path impo ...
随机推荐
- 编码(1)学点编码知识又不会死:Unicode的流言终结者和编码大揭秘
学点编码知识又不会死:Unicode的流言终结者和编码大揭秘 http://www.freebuf.com/articles/web/25623.html 如果你是一个生活在2003年的程序员,却不了 ...
- SHELL脚本--tr命令用法和特性全解
bash&shell系列文章:http://www.cnblogs.com/f-ck-need-u/p/7048359.html 1.1 简介 tr主要用于将从标准输入读取的数据进行结果集映射 ...
- Redis主从复制、多实例、高可用(三)--技术流ken
Redis主从复制 在开始实现redis的高可用之前,首先来学习一下如何实现redis的主从复制,毕竟高可用也会依赖主从复制的技术. Redis的主从复制,可以实现一个主节点master可以有多个从节 ...
- C#工具类:使用SharpZipLib进行压缩、解压文件
SharpZipLib是一个开源的C#压缩解压库,应用非常广泛.就像用ADO.NET操作数据库要打开连接.执行命令.关闭连接等多个步骤一样,用SharpZipLib进行压缩和解压也需要多个步骤.Sha ...
- Python正则进阶
目录 1.Python正则表达式模块 1.1 正则表达式处理字符串主要有四大功能 1.2 Python中re模块使用正则表达式的两种方法 1.3 正则表达式对象的常用方法 1.4 匹配对象的属性与方法 ...
- vuex 、store、state (转载)
vuex 文档 https://vuex.vuejs.org/zh/guide/state.html
- [日常] DNS解析概述
DNS DomainNameSystem域名系统,根据域名查出IP地址 1.dig命令可以显示整个查询的过程 root@VM-38-204-ubuntu:~# dig www.sopans.com / ...
- java反射知识相关的文章
整理的反射相关的文章: (1).通俗理解反射(知乎):学习java应该如何理解反射? (2).关于反射比较深入的博文地址:深入解析Java反射(1) - 基础 贴出我反射调用代码:(craw,dept ...
- java通过Access_JDBC30读取access数据库时无法获取最新插入的记录
1.编写了一个循环程序,每几秒钟读取一次,数据库中最新一行数据 连接access数据库的方法和查询的信息.之后开一个定时去掉用. package javacommon.util; import jav ...
- 文件权限解释rwx
linux文件权限 r 读w 写x (execute)执行 rwxrw-r-- 解释:rwx文件所有者对该文件有读写执行的权限:rw- 组内用户对该文件有读写的权限:r-- 其他非本组用户对该文件具有 ...