
轻松上手nodeJs爬取想要页面的数据
开始之前请先确保自己安装了Node.js环境!!!!!!!!
1.在项目文件夹安装两个必须的依赖包
npm install superagent -S
SuperAgent(官网是这样解释的)
-----SuperAgent is light-weight progressive ajax API crafted for flexibility, readability, and a low learning curve after being frustrated with many of the existing request APIs. It also works with Node.js!
-----superagent 是一个轻量的,渐进式的ajax api,可读性好,学习曲线低,内部依赖nodejs原生的请求api,适用于nodejs环境下
npm install cheerio -S
2.Cheerio
-----cheerio是nodejs的抓取页面模块,为服务器特别定制的,快速、灵活、实施的jQuery核心实现。适合各种Web爬虫程序。相当于node.js中的jQuery
3.新建 crawler.js 文件
在里面输入
 1 //导入依赖包
 2 const http = require("http");
 3 const path = require("path");

 const url = require("url");

 const fs = require("fs");

 const superagent = require("superagent");

 const cheerio = require("cheerio");

 superagent

     .get("https://www.zhipin.com/job_detail/?city=100010000&source=10&query=%E5%89%8D%E7%AB%AF")

     .end((error, response) => {

         //获取页面文档数据

         var content = response.text;

         //cheerio也就是nodejs下的jQuery  将整个文档包装成一个集合,定义一个变量$接收

         var $ = cheerio.load(content);

         //定义一个空数组,用来接收数据

         var result = [];

         //分析文档结构  先获取每个li 再遍历里面的内容(此时每个li里面就存放着我们想要获取的数据)

         $(".job-list li .job-primary").each((index, value) => {

             //地址和类型为一行显示,需要用到字符串截取

             //地址

             let address = $(value).find(".info-primary").children().eq(1).html();

             //类型

             let type = $(value).find(".info-company p").html();

             //解码

             address = unescape(address.replace(/&#x/g, '%u').replace(/;/g, ''));

             type = unescape(type.replace(/&#x/g, '%u').replace(/;/g, ''))

                 //字符串截取

             let addressArr = address.split('<em class="vline"></em>');

             let typeArr = type.split('<em class="vline"></em>');

             //将获取的数据以对象的形式添加到数组中

             result.push({

                 title: $(value).find(".name .job-title").text(),

                 money: $(value).find(".name .red").text(),

                 address: addressArr,

                 company: $(value).find(".info-company a").text(),

                 type: typeArr,

                 position: $(value).find(".info-publis .name").text(),

                 txImg: $(value).find(".info-publis img").attr("src"),

                 time: $(value).find(".info-publis p").text()

             });

             // console.log(typeof $(value).find(".info-primary").children().eq(1).html());

         });

         //将数组转换成字符串

         result = JSON.stringify(result);

         //将数组输出到json文件里  刷新目录 即可看到当前文件夹多出一个boss.json文件(打开boss.json文件,ctrl+A全选之后 ctrl+K,再Ctrl+F即可将json文件自动排版)

         fs.writeFile("boss.json", result, "utf-8", (error) => {

             //监听错误,如正常输出,则打印null

             if (error == null) {

                 console.log("恭喜您,数据爬取成功!请打开json文件,先Ctrl+A,再Ctrl+K,最后Ctrl+F格式化后查看json文件(仅限Visual Studio Code编辑器)");

             }

         });

     });
4.更改数据(如果是静态页面上面的操作基本上就已经完成了 直接node .\cralwer.js,但是现实中很多都不是)
1.在游览器中输入想要爬取的地址
例如:https://www.zhipin.com/job_detail/?city=100010000&source=10&query=%E5%89%8D%E7%AB%AF
2.进入控制台选中body copy element
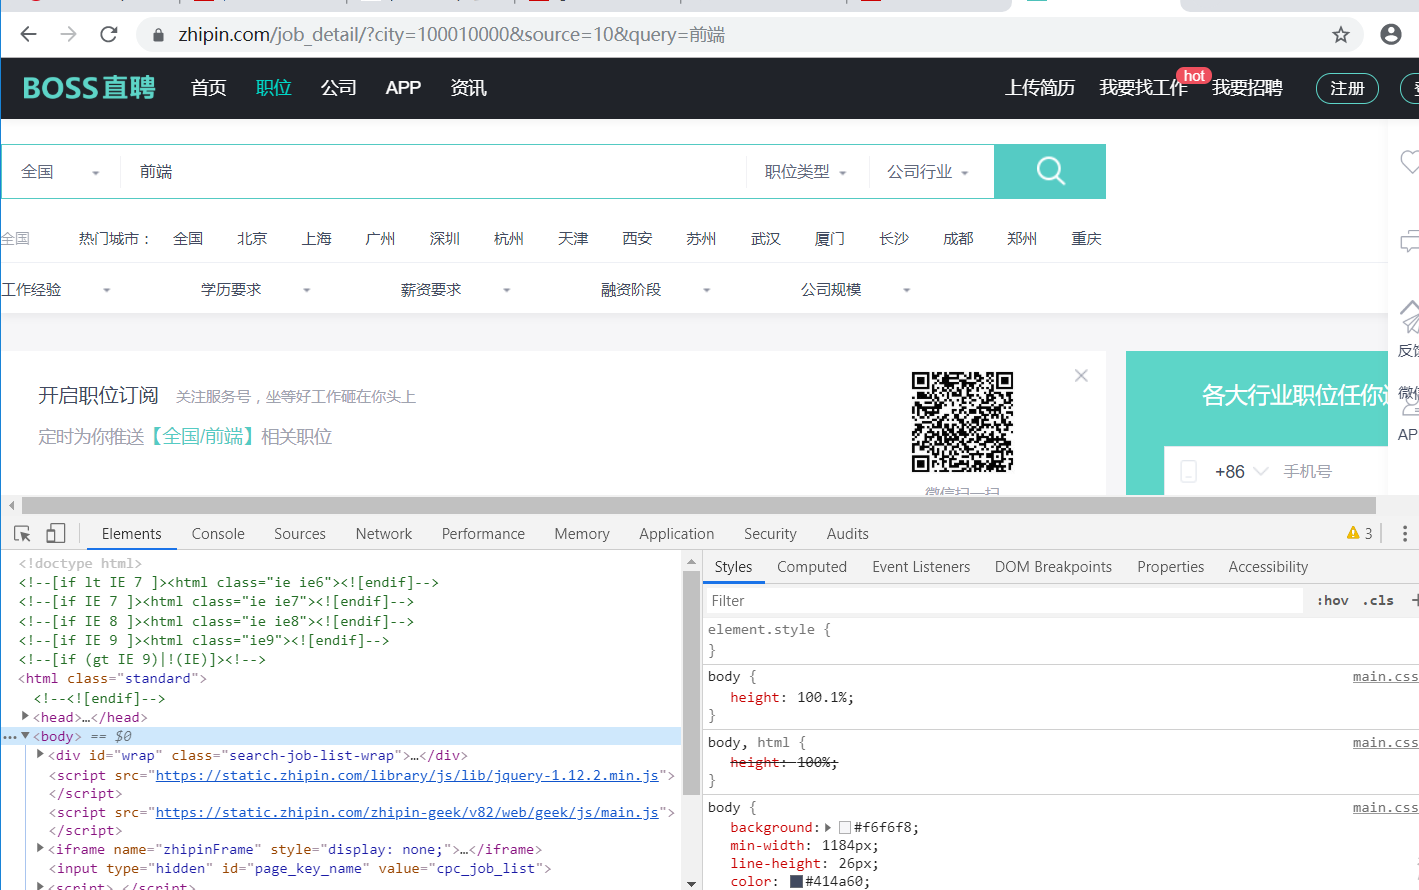
3.在编辑器中粘贴即可
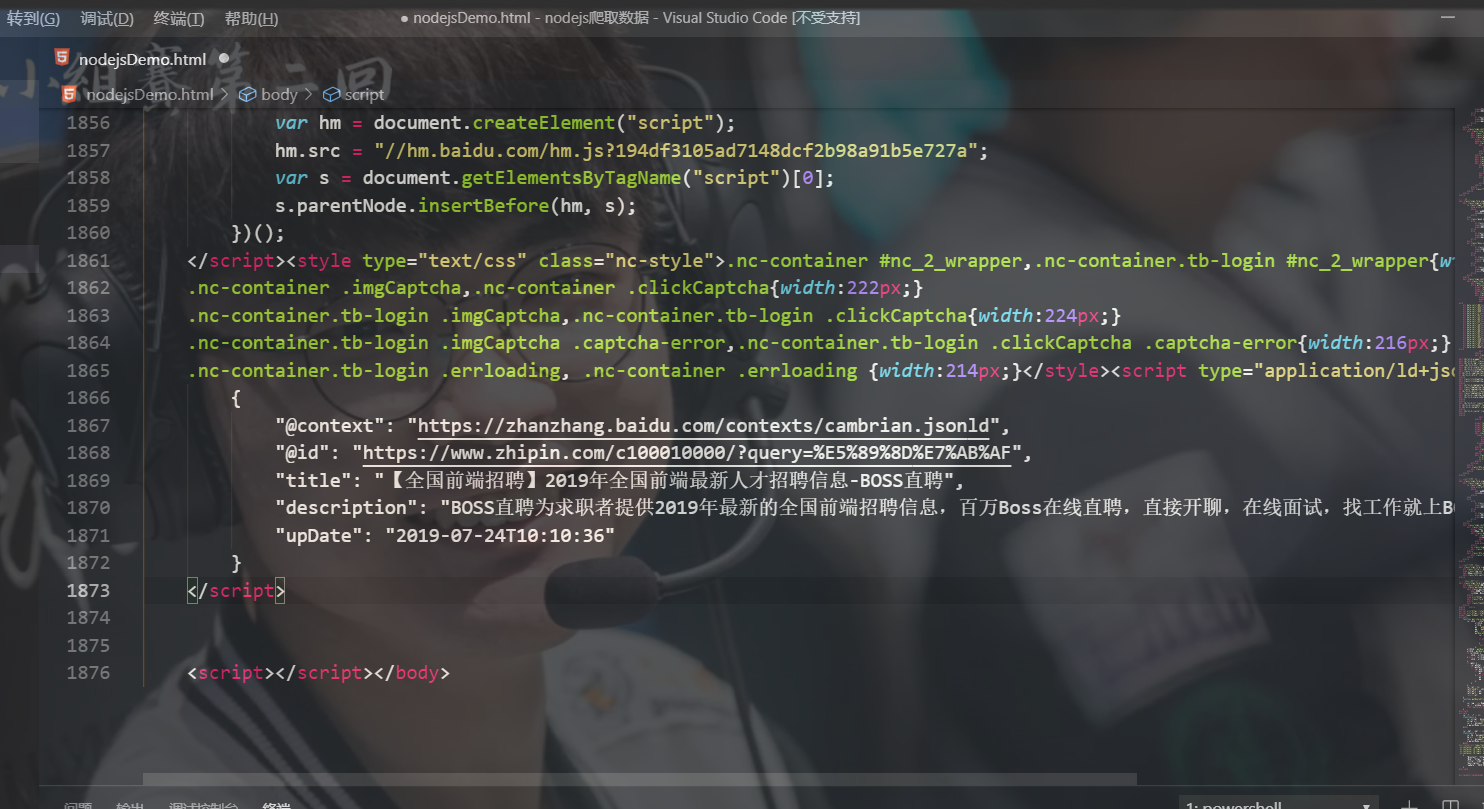
5.在服务器环境下运行这个网页

7.复制这个地址栏地址
然后粘贴在文件 cralwer.js .get()中
8. 在终端中运行
node .\cralwer.js
最后 本文借鉴于https: //blog.csdn.net/twodogya/article/details/80204322
轻松上手nodeJs爬取想要页面的数据的更多相关文章
- [爬虫]采用Go语言爬取天猫商品页面
最近工作中有一个需求,需要爬取天猫商品的信息,整个需求的过程如下: 修改后端广告交易平台的代码,从阿里上传的素材中解析url,该url格式如下: https://handycam.alicdn.com ...
- Python 2.7_爬取CSDN单页面利用正则提取博客文章及url_20170114
年前有点忙,没来的及更博,最近看爬虫正则的部分 巩固下 1.爬取的单页面:http://blog.csdn.net/column/details/why-bug.html 2.过程 解析url获得网站 ...
- 以豌豆荚为例,用 Scrapy 爬取分类多级页面
本文转载自以下网站:以豌豆荚为例,用 Scrapy 爬取分类多级页面 https://www.makcyun.top/web_scraping_withpython17.html 需要学习的地方: 1 ...
- 大神:python怎么爬取js的页面
大神:python怎么爬取js的页面 可以试试抓包看看它请求了哪些东西, 很多时候可以绕过网页直接请求后面的API 实在不行就上 selenium (selenium大法好) selenium和pha ...
- Python 2.7_爬取CSDN单页面博客文章及url(二)_xpath提取_20170118
上次用的是正则匹配文章title 和文章url,因为最近在看Scrapy框架爬虫 需要了解xpath语法 学习了下拿这个例子练手 1.爬取的单页面还是这个rooturl:http://blog.csd ...
- python 爬取天猫美的评论数据
笔者最近迷上了数据挖掘和机器学习,要做数据分析首先得有数据才行.对于我等平民来说,最廉价的获取数据的方法,应该是用爬虫在网络上爬取数据了.本文记录一下笔者爬取天猫某商品的全过程,淘宝上面的店铺也是类似 ...
- 通过scrapy,从模拟登录开始爬取知乎的问答数据
这篇文章将讲解如何爬取知乎上面的问答数据. 首先,我们需要知道,想要爬取知乎上面的数据,第一步肯定是登录,所以我们先介绍一下模拟登录: 先说一下我的思路: 1.首先我们需要控制登录的入口,重写star ...
- Java爬虫系列四:使用selenium-java爬取js异步请求的数据
在之前的系列文章中介绍了如何使用httpclient抓取页面html以及如何用jsoup分析html源文件内容得到我们想要的数据,但是有时候通过这两种方式不能正常抓取到我们想要的数据,比如看如下例子. ...
- Python3爬取王者官方网站英雄数据
爬取王者官方网站英雄数据 众所周知,王者荣耀已经成为众多人们喜爱的一款休闲娱乐手游,今天就利用python3 爬虫技术爬取官方网站上的几十个英雄的资料,包括官方给出的人物定位,英雄名称,技能名称,CD ...
随机推荐
- Nexus搭建Maven私服中央仓库
一.概述 1.概要 现在的项目基本都是用Maven来管理工程,这样一来在公司内容搭建一个私服就非常有必要了,这样一来可以管理公司内部用的JAR包,也可以管理第三方的各种JAR来,以免每次都要从外网的仓 ...
- elasticsearch删除
1.根据id删除 2.根据查询条件删除
- 1.xml简单介绍
1.xml(eXtensible Markup Language)的简介 (1)xml: 可扩展标记型语言 - 标记型语言:例如html也是标记型语言,也是使用标签来操作的 - 可扩展:html里面的 ...
- 51nod 1831: 小C的游戏(Bash博弈 找规律)
题目链接 此类博弈不需要考虑sg函数,只需要确定必胜态和必败态,解题思路一般为打败先打表找规律,而后找规律给出统一的公式.打表方式:给定初始条件(此题中为ok[0]=ok[1]=0),然后从低到高枚举 ...
- Jenkins之配置GitHub-Webhook2
什么是持续集成(Continuous integration) 提出者Martin Fowler本人对持续集成是这样定义的:持续集成是一种软件开发实践,即团队开发成员经常集成他们的工作,通常每个成员每 ...
- sql 2008常用语法语句收集
EXEC sp_dropuser 'test' : 从当前数据库删除用户 test EXEC sp_droplogin 'test' : 从 SQL Server 中删除登录 test select ...
- VS2010MFC编程入门
一.MFC编程入门教程之目录 第1部分:MFC编程入门教程之目录 1.MFC编程入门之前言 鸡啄米的C++编程入门系列给大家讲了C++的编程入门知识,大家对C++语言在语法和设计思想上应该有了一定的 ...
- CVE-2017-0213 | 记一次失败的提权经历
环境: CVE-2017-0213下载 提权步骤: 提权失败.... 好迷啊,,,,事后查了一下补丁 我的wind7上也没装啊,然后防火墙也是关闭的 迷了迷了....
- Win7系统取消登录界面的两种方法(图文)
windows7系统设置电脑密码后,即使取消密码,也会出现登录界面 ,每次都要点击用户图标才能进入系统,这样比较麻烦.那么有什么办法可以取消登录界面呢?方法当然是有的,阅读下文教程,我们一起来看下Wi ...
- [CSP-S模拟测试]:春思(数学)
蝶恋花·春景花褪残红青杏小.燕子飞时,绿水人家绕.枝上柳绵吹又少.天涯何处无芳草!墙里秋千墙外道.墙外行人,墙里佳人笑.笑渐不闻声渐悄.多情却被无情恼.(本词是伤春之作,写春景清新秀丽.同时,景中又有 ...