
Python 2.7_爬取CSDN单页面利用正则提取博客文章及url_20170114
年前有点忙,没来的及更博,最近看爬虫正则的部分 巩固下
1.爬取的单页面:http://blog.csdn.net/column/details/why-bug.html
2.过程 解析url获得网站源代码
3.找到文章标题列表和文章url(a标签下’href'属性)组成列表
4.for循环取出
#解析用到的还是urlllib urllib2两个模块 并加了个header请求表头
代码及过程如下:
#coding:utf-8

import re

import urllib

import urllib2

rooturl='http://blog.csdn.net/column/details/why-bug.html'

#urllib2.Request()方法 请求

req=urllib2.Request(rooturl)

req.add_header('User-Agent','Chrome')

req=urllib2.urlopen(req)

#req变量的read()方法获得源代码

html=req.read()

#分析文章标题和href属性

#标题和文章url都在a标签内 url格式为'http://blog.csdn.net/pleasecallmewhy/article/details/(****)',标题在'target="_blank">(****)</a>'

#写正则表达式 利用()小括号将url和标题分组

rs=r'<a href="(http://blog.csdn.net/pleasecallmewhy/article/details/.*?)" target="_blank">(.*?)</a>'

#利用正则findall(正则表达式rs,查找的范围) 现在及findall(rs,html)找到所有符合条件的元素并返回一个列表titlelist

titlelist=re.findall(rs,html)

#因为正则表达式是有2个分组 一个是文章url('href='以后括号的内容),一个是文章标题 这两个内容在titlelist里面是以元组形式构成的

#列表的长度就是页面有多少篇博客文章

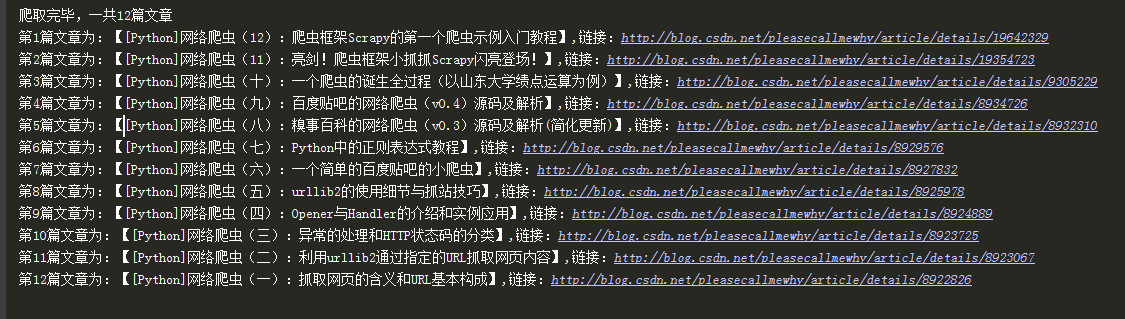
print '爬取完毕,一共%s篇文章' % len(titlelist)

#因为想实现打印出第几篇文章 文章标题 文章链接的效果 需要对titlelist进行遍历 用到的是列表list类的enumerate()方法 打印出列表索引和值

#第一个索引值为0 值为一个元组(文章url,文章标题) 这个元组又可以切片 因此取这个元组的第一个元素和第二个元素及实现效果

for i,j in enumerate(titlelist):

    #i为titlelist列表的索引 j为titlelist列表的值

    #取j的第一个元素j[0]即文章url 赋值给变量titurl 标题同样

    titleurl=j[0]

    titlename=j[1]

    #打印效果 用%格式化输出 titlelist索引值从0开始因此对i+1 代表第一篇文章

    print '第%s篇文章为:【%s】,链接:%s' %(i+1,titlename,titleurl)
Python 2.7_爬取CSDN单页面利用正则提取博客文章及url_20170114的更多相关文章
- Python 2.7_爬取CSDN单页面博客文章及url(二)_xpath提取_20170118
上次用的是正则匹配文章title 和文章url,因为最近在看Scrapy框架爬虫 需要了解xpath语法 学习了下拿这个例子练手 1.爬取的单页面还是这个rooturl:http://blog.csd ...
- [Python学习] 简单爬取CSDN下载资源信息
这是一篇Python爬取CSDN下载资源信息的样例,主要是通过urllib2获取CSDN某个人全部资源的资源URL.资源名称.下载次数.分数等信息.写这篇文章的原因是我想获取自己的资源全部的评论信息. ...
- python爬虫实例——爬取歌单
学习自<<从零开始学python网络爬虫>> 爬取酷狗歌单,保存入csv文件 直接上源代码:(含注释) import requests #用于请求网页获取网页数据 from b ...
- Python 2.7_爬取妹子图网站单页测试图片_20170114
1.url= http://www.mzitu.com/74100/x,2为1到23的值 2.用到模块 os 创建文件目录; re模块正则匹配目录名 图片下载地址; time模块 限制下载时间;req ...
- python使用bs4爬取boss静态页面
思路: 1.将需要查询城市列表,通过城市接口转换成相应的code码 2.遍历城市.职位生成url 3.通过url获取列表页面信息,遍历列表页面信息 4.再根据列表页面信息的job_link获取详情页面 ...
- 看我怎么扒掉CSDN首页的底裤(python selenium+phantomjs爬取CSDN首页内容)
这里只是学习一下动态加载页面内容的抓取,并不适用于所有的页面. 使用到的工具就是python selenium和phantomjs,另外调试的时候还用了firefox的geckodriver.exe. ...
- Python爬取CSDN博客文章
0 url :http://blog.csdn.net/youyou1543724847/article/details/52818339Redis一点基础的东西目录 1.基础底层数据结构 2.win ...
- 开发记录_自学Python写爬虫程序爬取csdn个人博客信息
每天刷开csdn的博客,看到一整个页面,其实对我而言,我只想看看访问量有没有上涨而已... 于是萌生了一个想法: 想写一个爬虫程序把csdn博客上边的访问量和评论数都爬下来. 打算通过网络各种搜集资料 ...
- 大神:python怎么爬取js的页面
大神:python怎么爬取js的页面 可以试试抓包看看它请求了哪些东西, 很多时候可以绕过网页直接请求后面的API 实在不行就上 selenium (selenium大法好) selenium和pha ...
随机推荐
- Centos7.2安装bacula及bacula-web
serverd端安装(centos7) bacula的安装很简单,但是配置文件内容很多,配置不正确服务就启动不了,所以需要用webmin来配置. 1.安装基础软件包: 关闭SElinux(重要)set ...
- yii2弹出层
bootstrap http://getbootstrap.com/javascript/#modals https://github.com/lichunqiang/yii2-sweet-submi ...
- JPEGView——专业、免费、开源的图像浏览器
虽叫JPEGView,它不仅支持jpeg图像格式,主流的图像格式它都支持. 试一试你就知道它有多强大了.
- $ 用python处理Excel文档(1)——用xlrd模块读取xls/xlsx文档
本文主要介绍xlrd模块读取Excel文档的基本用法,并以一个GDP数据的文档为例来进行操作. 1. 准备工作: 1. 安装xlrd:pip install xlrd 2. 准备数据集:从网上找到的1 ...
- sudoers文件设置sudo命令无密码(root密码)登录
参考博客:http://xvshell.iteye.com/blog/1838093 1. 当用户执行sudo时,Linux系统会去寻找/etc/sudoers文件,并且这是主动的,判断用户是否有执行 ...
- Delphi中ComPort通信中的数据处理
源: Delphi中ComPort通信中的数据处理
- P4234 最小差值生成树
题目 P4234 最小差值生成树 做法 和这题解法差不多,稍微变了一点,还不懂就直接看代码吧 \(update(2019.2):\)还是具体说一下吧,排序,直接加入,到了成环情况下,显然我们要把此边代 ...
- php数组函数-array_combine()
array_combine()函数通过合并两个数组来创建一个新数组,其中一个数组是键名,另一个数组的值为键值. 如果其中一个数组为空,或者两个数组的元素个数不同,则该函数返回 false. array ...
- iOS应用网络安全之HTTPS
移动互联网开发中iOS应用的网络安全问题往往被大部分开发者忽略,iOS9和OS X 10.11开始Apple也默认提高了安全配置和要求.本文以iOS平台App开发中对后台数据接口的安全通信进行解析和加 ...
- Jquery 获取地址位置
直接在浏览器地址 输入: http://pv.sohu.com/cityjson?ie=utf-8 可以查看数据格式 引入一个搜狐的js库: <script src="http://p ...