
URL简单梳理
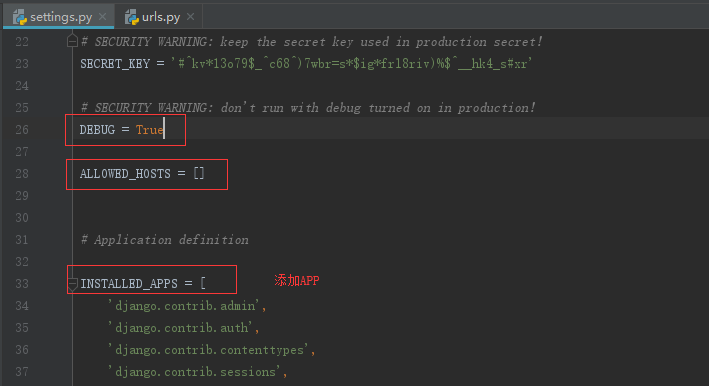
# DEBUG模式:
- 开启debug模式后,修改项目代码时按下ctrl+s可重启项目;
- 项目中出现bug时,浏览器与控制台会打印错误信息;
- 在生产环境中禁止开启DEBUG模式,有很大的安全隐患;
- 将DEBUG设置为False时,必须设置ALLOWED_HOSTS。
- ALLOWED_HOSTS :用来设置以后只能通过这个变量中的IP或域名来进行访问
# 视图函数:
- 第一个参数必须是 request ; book_id 后可添加默认参数。
- 返回值必须是 ‘django.http.response.HttpResponse’ 的子类对象
 #(app)front中views.py

 from django.http import HttpResponse

 def index(request):

     return HttpResponse('网站首页')

 def books(requeset,book_id):

     text = '图书的ID是:%s' % book_id

     return HttpResponse(text)

 #项目urls.py

 from django.urls import path

 from front import views

 urlpatterns = [

     #http://127.0.0.1:8000/

     path('',views.index),

     #http://127.0.0.1:8000/book/1

     path('book/<book_id>/',views.books)

 ]
# urls模块化:
- 每个App的 urls 都放到自己的App进行管理,在App中新建一个 urls.py 文件来存储所有和这个App相关的 子url ,然后在项目的主 urls.py 文件下使用 include 来包含各个App的 urls.py 文件,如:
 #项目urls.py

 '''

 urlpatterns = [

     path('book/',include('book.urls'))

 ]

''' #book.urls为应用程序book的urls.py文件 - ‘App’的 urls.py 中,所有的url匹配也要放在变量 urlpatterns 中,否则找不到;
 #App的urls.py

 '''

 urlpatterns = [

     path('/detail/<book_id>/',views.book_detail)

 ]

''' - 项目的‘url’会根据 urls.py 和App中的 urls.py 进行拼接,注意不能多加斜杆。(得到的URL为:http://.../book/detail/1)
# url命名:
- 为App的‘ url ’命名,防止后期‘url’经常变动。后期反转时使用 name 定义的url名字。前面显示的 login 可变动;
  #app的urls.py

 '''

 path('login/',views.login,name='login')

''' - 存在多个App时,为防止同名的‘url’产生混淆,使用 ‘命名空间 ’app_name 来进行区分;
 #App的urls.py文件

 '''

 app_name = 'front’  #app的名称

 urlpatterns = [

     path('login/',views.login,name='login')

 ]

 '''
反转时使用 命名空间:url名称 进行反转
 app的urls.py文件

 '''

 return redirect(reverse(‘front:login’))   #反转到front应用程序的url页面(name=‘login’的值)。

 '''
# 应用(app)命名空间与实例命名空间:
- 一个App可使用多个URL实例进行映射,所以使用命名空间时容易发生混淆;使用 实例命名空间‘namespace’ 来解决该问题
 #项目urls.py

 '''

     path('login1/',include('front.urls',namespace='login1'))

     path('login2/',include('front.urls',namespace='login2'))

''' - 反转时使用实例命名空间指定具体的url;
 #应用程序urls.py

 '''

 def idnex(request):

     username = request.GET.get('username')

     if username:

         return HttpResponse('front首页')

     else:

         #获取当前命名空间

         current_namespace = request.resolver_match.namespace

         return redirect(reverse('%s:login' % current_namespace))

 '''
# include()函数:
- include(module,namespace=None)
- module:子 url 的模块字符串;
- namespace:指定实例命名空间时必须先指定应用命名空间app_name;
- include((pattern_list,app_namespace),namespace=None)
- 函数的第一个参数可以为一个字符串或者一个元组,为元组时第一个参数为App的 url.py 模块的字符串,第二个参数为应用命名空间;
 '''

 path(('login/',include('front.urls','login'),namespace='book'))

 '''
- 函数的第一个参数可以为一个字符串或者一个元组,为元组时第一个参数为App的 url.py 模块的字符串,第二个参数为应用命名空间;
- include(pattern_list) :列表中装 path 或 re_path 。
 '''

 path('movies/',include([

     path(' ',views.movie),

     path('list/',views.movie_list),

 ]))

 '''
# re_path:
- 作用比 ‘path’ 强大,写 url 时可使用正则表达式;(无特殊情况时建议使用:path)
- 写正则表达式时使用原生字符串,即以 ‘r’ 开头的字符串;
- 正则表达式使用圆括号定义变量,参数有名字时使用 ?P<参数名字> ,然后在后面添加正则表达式的规则。
 '''

 re_path(r"^list/(?P<year>\d{4}/$",views.book_list)

 '''
# reverse函数:
- 在反转 ur l时,如需添加参数,可传递 kwargs 参数到reverse函数中
 #应用urls.py

 '''

 return redirect(reverse('book',kwargs={'book_id':1,'page':2}))

''' - 如需添加字符串的参数,则必须手动进行拼接
 #在没输入关键参数时自动跳转到登录页面,next告诉下一步跳转的位置

 '''

 return redirect(reverse('login') + "?next=/")

 '''

 #类似于知乎的首页登录跳转

 #知乎网站:https://www.zhihu.com/signup?next=%2F    (%2F = /)

 #进入时自动跳转到 signup 的url登录页面,后面告知下一步跳转到首页
URL简单梳理的更多相关文章
- C#正则表达式_简单梳理_Emoji表情字符处理
A-最近一直有接触到正则表达式,现对其做简单梳理: private const RegexOptions OPTIONS = RegexOptions.IgnoreCase | RegexOption ...
- 机器学习&数据挖掘笔记(常见面试之机器学习算法思想简单梳理)
机器学习&数据挖掘笔记_16(常见面试之机器学习算法思想简单梳理) 作者:tornadomeet 出处:http://www.cnblogs.com/tornadomeet 前言: 找工作时( ...
- [转]机器学习&数据挖掘笔记_16(常见面试之机器学习算法思想简单梳理)
机器学习&数据挖掘笔记_16(常见面试之机器学习算法思想简单梳理) 转自http://www.cnblogs.com/tornadomeet/p/3395593.html 前言: 找工作时(I ...
- RocketMQ 简单梳理 及 集群部署笔记【转】
一.RocketMQ 基础知识介绍Apache RocketMQ是阿里开源的一款高性能.高吞吐量.队列模型的消息中间件的分布式消息中间件. 上图是一个典型的消息中间件收发消息的模型,RocketMQ也 ...
- Memcached概念、作用、运行原理、特性、不足简单梳理(1)
大家可能对memcached这种产品早有了解,或者已经应用在自己的网站中了,但是也有一些朋友从来都没有听说过或者使用过.这都没什么关系,本文旨在从各个角度综合的介绍这种产品,尽量深入浅出,如果能对您现 ...
- SpringSecurity配置,简单梳理
生活加油:摘一句子: “我希望自己能写这样的诗.我希望自己也是一颗星星.如果我会发光,就不必害怕黑暗.如果我自己是那么美好,那么一切恐惧就可以烟消云散.于是我开始存下了一点希望—如果我能做到,那么我就 ...
- 简单梳理JavaScript垃圾回收机制
JavaScript具有自动垃圾回收机制,即执行环境会负责管理代码执行过程中使用地内存. 这种垃圾回收机制的原理很简单:找出那些不再继续使用的变量,然后释放其占用的内存.为此,垃圾收集器会按照固定的时 ...
- 简单梳理下 Vue3 的新特性
在 Vue3 测试版刚刚发布的时候,我就学习了下 Composition API,但没想到正式版时隔一年多才出来,看了一下发现还是增加了不少新特性的,在这里我就将它们一一梳理一遍. 本文章只详细阐述 ...
- 机器学习&数据挖掘笔记_16(常见面试之机器学习算法思想简单梳理)
前言: 找工作时(IT行业),除了常见的软件开发以外,机器学习岗位也可以当作是一个选择,不少计算机方向的研究生都会接触这个,如果你的研究方向是机器学习/数据挖掘之类,且又对其非常感兴趣的话,可以考虑考 ...
随机推荐
- python内置函数zip
zip() 函数用于将可迭代的对象作为参数,将对象中对应的元素打包成一个个元组,然后返回由这些元组组成的列表. 如果各个迭代器的元素个数不一致,则返回列表长度与最短的对象相同,利用 * 号操作符,可以 ...
- GAN的文献综述
1.Conditional Generative Adversarial Netwoks Describe GAN: Generative adversarial nets were recently ...
- sublime text3 快捷键和好用的插件
常用快捷键: Ctrl + D 选中一个单词 Ctrl + L 选中一行 Ctrl + A 全选 Ctrl + M 选中括号内所有内容 (编写CSS或JS时非常实用) Ctrl + G 快速定位到某一 ...
- linux上限值网速、限值带宽
Linux操作系统中的流量控制器TC(Traffic Control)用于Linux内核的流量控制,主要是通过在输出端口处建立一个队列来实现流量控制. Linux流量控制的基本原理如下图所示. 接收包 ...
- Django框架----命名空间模式
命名空间模式 即使不同的APP使用相同的URL名称,URL的命名空间模式也可以让你唯一反转命名的URL. 举个例子: project中的urls.py from django.conf.urls im ...
- Oracle误删除数据恢复
select * from tablename as of timestamp to_timestamp('2018-05-04 13:30:00','yyyy-MM-dd hh24:mi:ss') ...
- Struts2 的 配置
三.Struts2配置 Struts2的核心配置文件 1.名称和位置是固定的 在src下struts.xml 2.Struts根标签 Package Action Result Action Pa ...
- Vim常用命令:移动 跳转 到 文档开头或末尾
gg:命令将光标移动到文档开头 G:命令将光标移动到文档末尾 vi编辑器中在命令行模式下输入G可以直接跳转到页面的底部 在命令行模式下输入1G可以跳转到页面的头部位置 更多在vi中移动编辑位置的命令说 ...
- python之面向对象的高级进阶
一 .isinstance(obj,cls)和issubclass(sub,super) isinstance(obj,cls)检查是否obj是否是类 cls 的对象 class Foo(object ...
- python3 独立环境 virtualenv & conda
python3 独立环境 virtualenv & conda virtualenv 创建独立python环境 virtualenv env_name -p /usr/bin/python3 ...