
第六章——决策树(Decision Trees)
决策树是强大的,多功能的机器学习算法。
6.1 训练和可视化一个决策树
在iris数据集训练DecisionTreeClassifier:
from sklearn.datasets import load_iris

from sklearn.tree import DecisionTreeClassifier

iris = load_iris()

X = iris.data[:, 2:] # petal length and width

y = iris.target

tree_clf = DecisionTreeClassifier(max_depth=2)

tree_clf.fit(X, y)
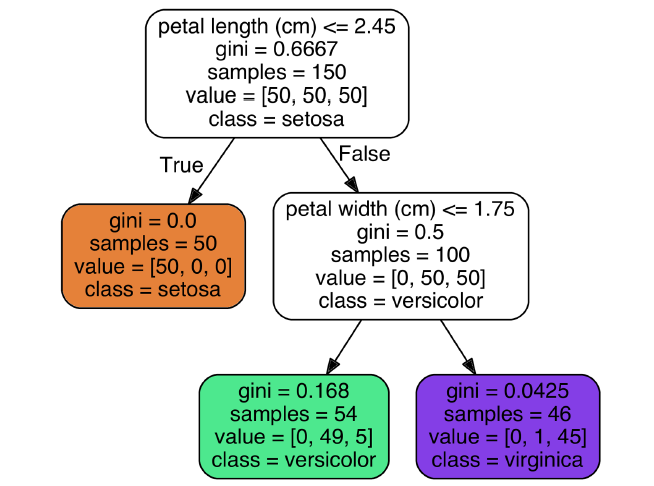
可以将训练好的决策树打印出来:
6.2 预测
从根节点开始,如果满足条件,则转向左子树,否则转向又子树。最终到达的叶子节点即为预测值。
决策树的一个优点是几乎不需要数据预处理,特别是不需要feature scaling或者centering。
基尼系数表示节点的纯洁度。如果gini=0,说明该节点是纯粹的,只包含一种类别。
第$i$个节点的Gini impurity:
$G_i = 1 - \sum_{k=1}^{n} p_{i,k}^2$
其中,$p_{i,k}$是类别$k$的样本数在节点$i$中样本总数所占的比例。
Scikit-Learn使用的是CART算法,产生的是二叉树:非叶子节点只有两个子节点。其它算法比如ID3可以生产具有更多子节点的决策树。
模型解释:白盒 Vs 黑盒:
决策树的可解释性很强,这被称作白盒模型。相应的,随机森林或者神经网络是黑盒模型。
6.3 评估类别概率(Estimating Class Probabilities)
类别的预测概率,就是叶子节点中该类别所占的比例。
6.4 CART训练算法
Scikit-Learn使用分类回归树(Classification And Regression Tree,CART)算法训练决策树。其思想很简单:使用属性$k$和相应的阈值$t_k$将训练集分为两个子集。搜索合适的$(k, t_k)$使得子集的纯净度最高。损失函数如下:
$J(k,t_k) = \frac{m_{left}}{m}G_{left} + \frac{m_{right}}{m}G_{right}$
其中,$G_{left}$、$G_{right}$是左、右子树的纯净度,$m_{left}$、$m_{right}$是左、右子树的样本数。
将训练集切分之后,会对子集继续切分,这是一个递归过程。如果达到最大深度就会停止(通过max_depth超参数控制),或者已经找不到可以增大纯净度的切分(比如已经完全纯净)。还有一些控制切分停止的超参数:min_samples_split, min_samples_leaf,min_weight_fraction_leaf, and max_leaf_nodes。
这是一个贪心算法,虽不能达到最优,但可以得到一足够优的结果。找到最优树属于NP完全(NP-Complete)问题,需要O(exp(m))时间,这使得即使是很小的训练集也难以求解。
6.5 计算复杂度
决策树预测过程,需要从根节点到达一个叶子节点,决策树一般是近似平衡的,这一过程复杂度为$O(log_2(m))$,与样本数无关。
训练过程需要比较所有的特征,训练复杂度是$(n times m log(m))$。
6.6 基尼系数还是熵(Gini Impurity or Entropy)?
熵:
$H_i = \sum_{k=1}^{n} p_{i,k}\ log(p_{i,k})$
二者差别不大,通常会得到相似的决策树。Gini impurity计算起来更快,所有它是默认的。如果非要说它们的区别,Gini impurity倾向于将最频繁的类别分在同一个分支,entropy倾向于生成更平衡的树。
6.7 正则化超参数(Regularization Hyperparameters)
决策树对训练数据几乎不做假设(与之相反,详细模型明显假设数据是线性的)。如果不进行约束,很容易造成过拟合。这种模型被称作无参数模型(nonparametric model),这并不是真的没有参数(通常有很多参数),而是参数个数不需要在训练之前确定下来,这就有很高的自由度去拟合训练数据。与之相反,比如线性模型这种参数模型,需要提前确定参数个数,所以其自由度是受限的,减少了过拟合的风险(但是增加了欠拟合的风险)。
为避免过拟合,需要在训练时现在决策树的自由度,这被称作正则化。正则化超参数跟算法有关,但一般情况下至少可以限制决策树的最大深度。在Scikit-Learn中这由max_depth超参数控制。
另外还有一些算法,不设限地训练决策树,训练完成后会修剪不必要的节点。如果一个节点的子节点都是叶子节点,对该节点的拆分带来的纯净度提升并不是统计学上有效的(statistically significant),那么其子节点就被认为是不必要的,会被删除掉。
6.7 回归
CART回归损失函数:
$J(k, t_k) = \frac{m_{left}}{m} MSE_{left} + \frac{m_{right}}{m} MSE_{right}$
其中,
$MSE_{node} = \sum_{i \in node}(\hat{y}_{node} - y_{(i)})^2$
$\hat{y}_{node} = \frac{1}{m_{node}}\sum_{i \in node}y^{(i)}$
6.8 不稳定性(Instability)
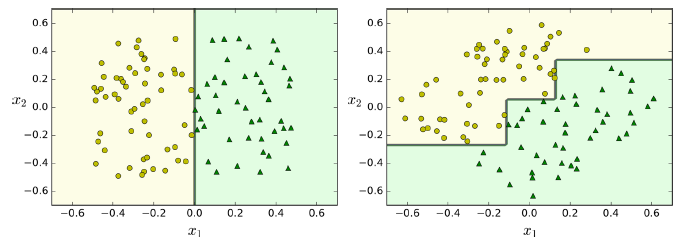
决策树虽然功能强大,但也有一些局限性。首先,决策树的决策边界都是正交直线(所有的切分都和某一个坐标轴垂直),这使得它们对数据集的旋转很敏感。例如,下图显示了简单的线性可分数据集,在左侧,决策树很容易将其切分。但是在右侧,数据集旋转45°,决策树出现了不必要的绕弯弯。尽管二者都很好地拟合了训练集,很明显右侧的模型难以很好地一般化。一个解决方案是使用PCA,它可以使训练集旋转到最好的方向。
此外,决策树对训练数据集微小的变动也会很敏感。
随机森林通过许多决策树的预测平均值,可以避免这一不稳定性。
第六章——决策树(Decision Trees)的更多相关文章
- 海量数据挖掘MMDS week6: 决策树Decision Trees
http://blog.csdn.net/pipisorry/article/details/49445465 海量数据挖掘Mining Massive Datasets(MMDs) -Jure Le ...
- 决策树(Decision Trees)
简介 决策树是一个预测模型,通过坐标数据进行多次分割,找出分界线,绘制决策树. 在机器学习中,决策树学习算法就是根据数据,使用计算机算法自动找出决策边界. 每一次分割代表一次决策,多次决策而形成决策树 ...
- 【机器学习实战】第3章 决策树(Decision Tree)
第3章 决策树 <script type="text/javascript" src="http://cdn.mathjax.org/mathjax/latest/ ...
- Decision Trees 决策树
Decision Trees (DT)是用于分类和回归的非参数监督学习方法. 目标是创建一个模型,通过学习从数据特征推断出的简单决策规则来预测目标变量的值. 例如,在下面的例子中,决策树从数据中学习用 ...
- Facebook Gradient boosting 梯度提升 separate the positive and negative labeled points using a single line 梯度提升决策树 Gradient Boosted Decision Trees (GBDT)
https://www.quora.com/Why-do-people-use-gradient-boosted-decision-trees-to-do-feature-transform Why ...
- CatBoost使用GPU实现决策树的快速梯度提升CatBoost Enables Fast Gradient Boosting on Decision Trees Using GPUs
python机器学习-乳腺癌细胞挖掘(博主亲自录制视频)https://study.163.com/course/introduction.htm?courseId=1005269003&ut ...
- 机器学习算法 --- Pruning (decision trees) & Random Forest Algorithm
一.Table for Content 在之前的文章中我们介绍了Decision Trees Agorithms,然而这个学习算法有一个很大的弊端,就是很容易出现Overfitting,为了解决此问题 ...
- Logistic Regression vs Decision Trees vs SVM: Part II
This is the 2nd part of the series. Read the first part here: Logistic Regression Vs Decision Trees ...
- Logistic Regression Vs Decision Trees Vs SVM: Part I
Classification is one of the major problems that we solve while working on standard business problem ...
随机推荐
- Android性能优化典例(二)
1.使用 Maven 依赖方案代替使用导入jar包方案 如果项目中需要用到第三方jar包,常用的做法是去网上下载后然后放入libs文件夹,再添加到项目依赖,不过,在Android Studio已经不推 ...
- ASCII码表(常用)
- 不用局部变量实现C语言两数交换算法
关于交换算法,我想非常简单,所以,这次不做分析,直接上代码: #include <stdio.h> #include <stdlib.h> //用异或方式实现 void swa ...
- 在 Linux 下用 mkdir 命令来创建目录和子目录
mkdir 是什么呢 Mkdir 是一个用来在 Linux 系统下创建目录的命令.此命令属于内建命令. 运行 mkdir 命令 你可以在你的控制台直接键入 mkdir 来使用它. $ mkdir 默认 ...
- shell脚本调用python脚本的路径问题
脚本的相互调用中,只有在同一级目录下才可以使用__file__参数去获取路径名,(在shell里使用pwd也同样),否则,使用的就是主文件(最开始运行的脚本程序)的所在位置,是错误路径:一定要注意当期 ...
- 【Android 应用开发】Android 开发错误集锦
1. eclipse的Device中不显示手机 在eclipse中连接不上手机,出现adb server didn't ACK fail to start daemon 错误. 出现这种原因是因为a ...
- 解读Raft(三 安全性)
前言 之前的两篇文章更多的是在描述Raft算法的正常流程,没有过多的去讨论异常场景. 而实际在分布式系统中,我们更多的都是在应对网络不可用.机器故障等异常场景,所以本篇来讨论一下Raft协议的安全性, ...
- Thinkphp3.2简单解决多文件上传只上传一张的问题
html简单页面: index.html代码: <form action="{:U('index/upload')}" method="post" enc ...
- Java——接口
被interface修饰的类,叫接口接口里的方法都是抽象的,不能实现.用implements关键字可以让一个类来实现该接口.接口:一个类在继承另一个类的同时.还可以实现多个接口.接口的出现避免了单继承 ...
- 初识java——运算符和表达式以及注释
java中有不同的运算符,并且在运算中有着优先级的排序计算,其中++和——的优先级最高,最先计算 运算符注意:1,增量和减量运算符++,——. int a=1++; int b=++1; 其中1++表 ...