
爬虫技术框架——Heritrix
Heritrix是一个由Java开发的开源Web爬虫系统,用来获取完整的、精确的站点内容的深度复制,
具有强大的可扩展性,运行开发者任意选择或扩展各个组件,实现特定的抓取逻辑。
一、Heritrix介绍
Heritrix采用了模块化的设计,用户可以在运行时选择要用的模块。它由核心类(core classes)和插件模块(pluggable modules)构成。
核心类可以配置,但不能被覆盖,插件模块可以由第三方模块取代。所以我们就可以用实现了特定抓取逻辑的第三方模块来取代默认的插件模块,从而满足自己的抓取需要。
CrawlController(下载控制器)整个下载过程的总控制者,整个抓取工作的起点,决定整个抓取任务的开始和结束。每个URI都有一个独立的线程,它从边界控制器(Frontier)获取新的URI,然后传递给Processor chains(处理链)经过一系列Processor(处理器)处理。
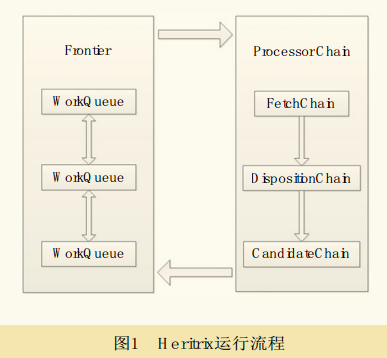
二、Heritrix架构
中央控制器 CrawlController 是核心组件,决定了整个抓取任务的开始与结束。
用户在 Heritrix web UI 控制台设置抓取任务后,heritrix首先构造XMLSettingsHandler对象,然后调用CrawlController的构造函数,构造一个CrawlController实例并初始化,这样,CrawlController就具备了运行条件。
此时,只需调用 requestCrawlStart()方法就可以启动线程池和Frontier,以便向线程池中工作线程提供抓取用的URL链接。
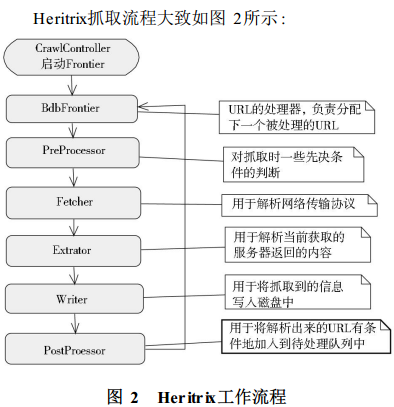
Heritrix 3.x 的框架主要分为 Engine 和 Component
三、一些API
org.archive.crawler.framework.CrawlJob;
org.archive.crawler.postprocessor.CandidatesProcessor;
org.archive.modules.CrawlURI;
等等
抓取任务CrawlOrder类:是整个抓取工作的起点。一次抓取任务包括许多属性,建立一个任务的方式有很多种,最简单的一种就是根据默认的order.xml来配置。
中央控制器CrawlController:该类决定着抓取任务的开始和结束。它包含以下几个组件:
CrawlOrder:该类保存了order.xml的属性配置;
CrawlScope:决定当前抓取范围;
ProcessorChainList:处理器链;
Frontier:一次抓取任务需要设定一个Frontier,以此来不断为其每个线程提供URI;
ToePool:它是一个线程池,管理了所有在当前任务中抓取过的Host名称和Server名称。
中央控制器CrawlControllr的类结构如图所示:
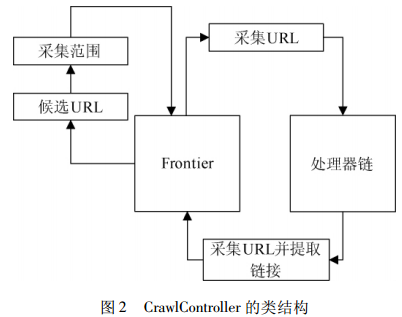
Frontier链接制造工厂:它表示一种为线程提供链接的工具,通过一些特定的算法来决定哪个链接将接下来被送入处理器链中,同时,它本身也负责一定的日志和状态报告功能。
BdbFrontier类:它是用Berkeley DB 实现的,Berkeley DB 就是一个HashTable,它能够按“key/value”方式保存数据,能够为应用程序提供可伸缩的、高性能的、有事务保护功能的嵌入式数据库。
Heritrix的多线程ToeThread和ToePool:要想更快更有效地抓取网页,必须采用多线程,Heritrix则采用多线程机制,提供了一个标准的线程池ToePool,用于管理所有的抓取线程。
处理器链 Processor:包括PreProcessor、Fetcher、Extractor、Writer、PostProcessor五种。
四、应用
作为爬虫模块,爬取数据
扫个红包吧!
Donate捐赠
如果我的文章帮助了你,可以赞赏我 6.66 元给我支持,让我继续写出更好的内容)
(微信) (支付宝)
微信/支付宝 扫一扫
爬虫技术框架——Heritrix的更多相关文章
- golang学习笔记17 爬虫技术路线图,python,java,nodejs,go语言,scrapy主流框架介绍
golang学习笔记17 爬虫技术路线图,python,java,nodejs,go语言,scrapy主流框架介绍 go语言爬虫框架:gocolly/colly,goquery,colly,chrom ...
- 基于Python,scrapy,redis的分布式爬虫实现框架
原文 http://www.xgezhang.com/python_scrapy_redis_crawler.html 爬虫技术,无论是在学术领域,还是在工程领域,都扮演者非常重要的角色.相比于其他 ...
- .net 爬虫技术
关于爬虫 从搜索引擎开始,爬虫应该就出现了,爬的对象当然也就是网页URL,在很长一段时间内,爬虫所做的事情就是分析URL.下载WebServer返回的HTML.分析HTML内容.构建HTTP请求的模拟 ...
- 使用webcollector爬虫技术获取网易云音乐全部歌曲
最近在知乎上看到一个话题,说使用爬虫技术获取网易云音乐上的歌曲,甚至还包括付费的歌曲,哥瞬间心动了,这年头,好听的流行音乐或者经典老歌都开始收费了,只能听不能下载,着实很郁闷,现在机会来了,于是开始研 ...
- 利用python的爬虫技术爬去糗事百科的段子
初次学习爬虫技术,在知乎上看了如何爬去糗事百科的段子,于是打算自己也做一个. 实现目标:1,爬取到糗事百科的段子 2,实现每次爬去一个段子,每按一次回车爬取到下一页 技术实现:基于python的实现, ...
- 爬虫技术实现空间相册采集器V.0.0.1版本
一. 功能需求分析: 在很多时候我们需要做这样一个事情:我们想把我们QQ空间上的相册高清图像下载下来,怎么做?到网上找软件?答案是否定的,理由之一:网上很多软件不知有没有病毒,第二它有可能捆了很 ...
- 使用jsoup十分钟内掌握爬虫技术
对,就是十分钟,没有接触过爬虫的你,肯定一脸懵逼,感觉好高深的样子,一开始我也有点懵,但用了以后发现还是很简单的,java爬虫框架有很多,让我有种选择困难症,通过权衡比较还是感觉jsoup比较好用些, ...
- 总结整理 -- 爬虫技术(C#版)
爬虫技术学习总结 爬虫技术 -- 基础学习(一)HTML规范化(附特殊字符编码表) 爬虫技术 -- 基本学习(二)爬虫基本认知 爬虫技术 -- 基础学习(三)理解URL和URI的联系与区别 爬虫技术 ...
- App技术框架
一.App技术框架的类型 图1 三种App技术框架之间的关系 目前App的技术框架基本分为三种(图1): (1)Native App:互动型,iOS.Android.WP各一套,而且要维护历史版本,要 ...
随机推荐
- innodb的读写参数优化
(1) 读取参数,global buffer pool以及 local buffer Innodb_buffer_pool_size,理论上越大越好,建议服务器50%~80%,实际为数据大小80 ...
- Solr学习笔记(4) —— SolrCloud的概述和搭建
一.概述 1.1 什么是SolrCloud Lucene是一个Java语言编写的利用倒排原理实现的文本检索类库: Solr是以Lucene为基础实现的文本检索应用服务.Solr部署方式有单机方式.多机 ...
- php数组·的方法3-数组和变量之间的转换
/* * 数组和变量之间的转换 * */ //extract() 使用数组定义一组变量 // 键名为变量名 键值为变量值(类似于js的解构赋值) // 返回值是数组的长度 echo '<hr&g ...
- java——快排、冒泡、希尔、归并
直接贴代码 快排: public class Test { private static void sort(int[] nums){ if(nums == null || nums.length = ...
- MemoryFile匿名共享内存
Android提供了一个高效的共享内存机制.如果应用中涉及到在多个进程间交换数据时使用Android提高的共享内存机制将会大大的提高效率.但是也许是出于安全考虑,在应用层使用共享内存机制将会遇到很多障 ...
- WebStorm 预览时把浏览器地址localhost 改成IP
最近在使用WebStorm时,预览网页时地址总是显示的 http://localhost:63342/... ,如果要调试其它设备感觉很不方法,此时肯定首先想到的亲爱的度娘,但是貌似没有真正很解决问题 ...
- jdk 动态代理 数据连接池
package com.itheima.datasource; import java.io.PrintWriter; import java.lang.reflect.InvocationHandl ...
- Collections练习之按照字符串长度进行排序
不多说,直接上干货! 代码需求 想从 [abcde, cba, aa, zzz, cba, nbaa] 变成 [aa, cba, cba, zzz, nbaa, abcde] CollectionsD ...
- spring DelegatingFilterProxy管理过滤器
安全过滤器链 Spring Security的web架构是完全基于标准的servlet过滤器的.它没有在内部使用servlet或任何其他基于servlet的框架(比如spring mvc),所以它没有 ...
- python 字符串转字节数组
场景: java加解密和python加解密互转的时候,因一些非显示字符无法确认两者是否一致,故需要打出他们的十六进制字节数组进行比较 1.python代码实现 str='123';print str. ...