
dome 模块 pyaudio 声音处理 为语音识别准备
dome 模块 pyaudio 声音处理
为语音识别准备
直接上例子
dome1 声音强度检查
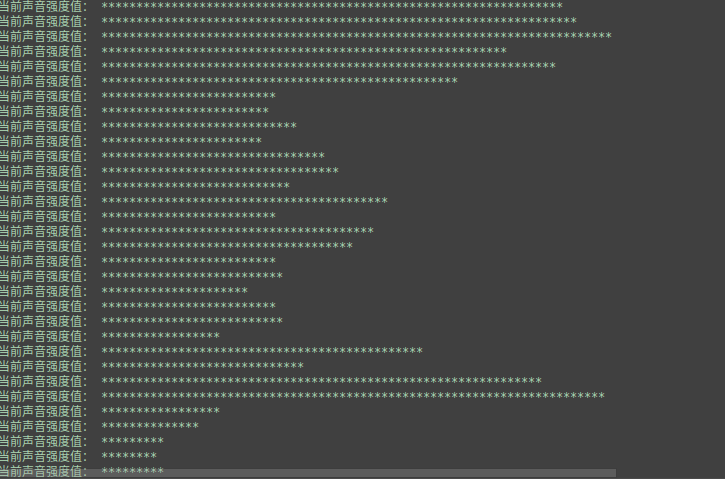
import pyaudio

import numpy as np

class QAudio:

    CHUNK = 512

    FORMAT = pyaudio.paInt16

    CHANNELS = 1

    RATE = 48000

    def __init__(self):

        self.paudio = None

        self.stream = None

    def open(self):

        self.paudio = pyaudio.PyAudio()

        self.stream = self.paudio.open(format=self.FORMAT,

                                       channels=self.CHANNELS,

                                       rate=self.RATE,

                                       input=True,

                                       frames_per_buffer=self.CHUNK)

    def read(self):

        data = self.stream.read(self.CHUNK)

        return data

    def close(self):

        self.stream.close()

        self.paudio.terminate()

def main():

    a = QAudio()

    a.open()

    print("开始聆听...")

    while True:

        data = a.read()

        audio_data = np.fromstring(data, dtype=np.short)

        temp = np.max(audio_data)

        print(f'当前声音强度值: {"*"*(temp//100)}')

if __name__ == '__main__':

    main()
dome2 录音_播放_写到文件
import pyaudio

import wave

class QAudio:

    CHUNK = 512

    FORMAT = pyaudio.paInt16

    CHANNELS = 1

    RATE = 48000

    def __init__(self):

        self.paudio = None

        self.stream = None

    def open(self):

        self.paudio = pyaudio.PyAudio()

        self.stream = self.paudio.open(format=self.FORMAT,

                                       channels=self.CHANNELS,

                                       rate=self.RATE,

                                       input=True,

                                       frames_per_buffer=self.CHUNK)

    def read(self):

        data = self.stream.read(self.CHUNK)

        return data

    def read_s(self, time=1):

        data = []

        for _ in range(self.RATE//self.CHUNK*time):

            data.append(self.stream.read(self.CHUNK))

        return data

    def close(self):

        self.stream.close()

        self.paudio.terminate()

    def save(self, filename='tmp.wav', data=[]):

        wf = wave.open(filename, "wb")

        wf.setnchannels(self.CHANNELS)

        wf.setsampwidth(2)

        wf.setframerate(self.RATE)

        wf.writeframes(b"".join(data))

        wf.close()

    def play(self, path="tmp.wav"):

        # 定义数据流块

        chunk = 1024

        # 只读方式打开wav文件

        f = wave.open(path, "rb")

        # 打开数据流

        fstream = self.paudio.open(format=self.paudio.get_format_from_width(f.getsampwidth()),

                                   channels=f.getnchannels(),

                                   rate=f.getframerate(),

                                   output=True)

        # 读取数据

        data = f.readframes(chunk)

        # 播放

        while data:

            fstream.write(data)

            data = f.readframes(chunk)

        # 停止数据流

        fstream.stop_stream()

        fstream.close()

def main():

    a = QAudio()

    a.open()

    print('开始录音')

    data = a.read_s(10)

    print('保存录音')

    a.save(data=data)

    print('播放声音')

    a.play()

    a.close()

if __name__ == '__main__':

    main()
dome3 自动断句录音,你说啥我说啥
为语音识别准备
import pyaudio

import wave

import numpy as np

class QAudio:

    CHUNK = 512

    FORMAT = pyaudio.paInt16

    CHANNELS = 1

    RATE = 48000

    def __init__(self):

        self.paudio = None

        self.stream = None

    def open(self):

        self.paudio = pyaudio.PyAudio()

        self.stream = self.paudio.open(format=self.FORMAT,

                                       channels=self.CHANNELS,

                                       rate=self.RATE,

                                       input=True,

                                       frames_per_buffer=self.CHUNK)

    def read(self):

        data = self.stream.read(self.CHUNK)

        return data

    def read_s(self, time=1.0):

        data = []

        for _ in range(int(self.RATE//self.CHUNK*time)):

            data.append(self.stream.read(self.CHUNK))

        return data

    def close(self):

        self.stream.close()

        self.paudio.terminate()

    def save(self, filename='tmp.wav', data=[]):

        wf = wave.open(filename, "wb")

        wf.setnchannels(self.CHANNELS)

        wf.setsampwidth(2)

        wf.setframerate(self.RATE)

        wf.writeframes(b"".join(data))

        wf.close()

    def play(self, path="tmp.wav"):

        # 定义数据流块

        chunk = 1024

        # 只读方式打开wav文件

        f = wave.open(path, "rb")

        # 打开数据流

        fstream = self.paudio.open(format=self.paudio.get_format_from_width(f.getsampwidth()),

                                   channels=f.getnchannels(),

                                   rate=f.getframerate(),

                                   output=True)

        # 读取数据

        data = f.readframes(chunk)

        # 播放

        while data:

            fstream.write(data)

            data = f.readframes(chunk)

        # 停止数据流

        fstream.stop_stream()

        fstream.close()

    def read_auto(self):

        self.read_s(0.1)  # 先取0.1s,清一下buf

        while True:

            data = []

            flag = None

            count = 1

            while True:

                result = self.read()

                audio_data = np.fromstring(result, dtype=np.short)

                # audio_data = np.array(result)

                temp = np.max(audio_data)

                print(f'当前声音强度值: {"*" * (temp // 100)}')

                if temp < 400:

                    if flag:

                        count -= 1

                        if count < 0:

                            break

                    continue

                else:

                    flag = True

                    data.append(result)

            print(len(data))

            if len(data) > (self.RATE//self.CHUNK)//3:

                break

        return data

def main():

    a = QAudio()

    a.open()

    while True:

        print('开始录音')

        data = a.read_auto()

        print('保存录音')

        a.save(data=data)

        print('播放声音')

        a.play()

        # 清空buff 避免噪音回响

        a.read_s(len(data)//(a.RATE//a.CHUNK)+0.5)

if __name__ == '__main__':

    main()
dome 模块 pyaudio 声音处理 为语音识别准备的更多相关文章
- Unity 声音处理 之 语音识别
音量检测 检测当前麦克风的输入音量 using System.Collections; using System.Collections.Generic; using UnityEngine; usi ...
- 基于语音识别、音文同步、图像OCR的字幕解决方案HtwMedia介绍
背景介绍 俗话说,“好记性不如乱笔头”,这充分说明了文字归档的重要性.如今随着微信.抖音等移动端app的使用越来越广,人们生产音.视频内容也越来越便捷.而相比语音和视频而言,文字具有易存档.易检索.易 ...
- 关于编码和解码问题——encode、decode
一.背景和问题 近期在做一个关于声卡录音的项目,开发环境是win10 64位家庭中文版,pycharm2019.1,python3.6(Anaconda3),python模块pyaud ...
- webrtc中APM(AudioProcessing module)的使用
一,实例化和配置 AudioProcessing* apm = AudioProcessing::Create(0); //这里的0指的是channelID,只是一个标注那个通道的表示 apm-> ...
- AngularJs angular.injector、angular.module
angular.injector 创建一个injector对象, 调用injector对象的方法可用于获取服务以及依赖注入. 格式:angular.injector(modules); modules ...
- webrtc--AudioProcessing的使用
1.AudioProcessing的实例化和配置: AudioProcessing* apm = AudioProcessing::Create(0); apm->level_estimator ...
- LINUX下 Udev详解
如果你使用Linux比较长时间了,那你就知道,在对待设备文件这块,Linux改变了几次策略.在Linux早期,设备文件仅仅是是一些带有适当的属性集的普通文件,它由mknod命令创建,文件存放在/dev ...
- 【Cocos2d-X开发笔记】第一期 Cocos2d-X的环境搭建
作者今天开始正式开始学习Cocos2d-X引擎进行游戏编程,预计两天会更新一期,最后实现ios游戏的appsore上线. (部分内容转载自:http://blog.csdn.net/yan ...
- 【Cocos2d-X开发学习笔记】第01期:PC开发环境的详细搭建
本文使用的是cocos2d-x-2.1.4版本 ,截至目前为止是最新稳定版 所谓的开发环境就是制作游戏的地方,打个比方读者就会十分清楚了.比如提到做饭,人们都会想到厨房.这是 因为厨房有炉灶.烟机.水 ...
随机推荐
- Django报Warning错误 RuntimeWarning: DateTimeField Goods.create_at received a naive datetime (2019-07-31 23:05:58) while time zone support is active
报错和UTC(世界标准时间)有关,在settings.py 文件中设置 USE_TZ = False 警告错误不再报
- 简单易懂的Servlet路径问题
关于servlet路径,我看了一下网上别人的博客园,发现都有一个通病,讲的太专业了,又抓不住关键部分,往往看一眼就不想看第二眼.所以我特地准备了初学者所通识的servlet路径问题. 1.标识符 /j ...
- SpringBoot入门系列(四)整合模板引擎Thymeleaf
前面介绍了Spring Boot的优点,然后介绍了如何快速创建Spring Boot 项目.不清楚的朋友可以看看之前的文章:https://www.cnblogs.com/zhangweizhong/ ...
- js中的this和arguments.callee
this和 arguments.callee this 全局作用域下,this指向Window 其他情况下,谁调用this就指向谁 console.log(this) //对调用就指向谁系列 func ...
- OpenCV3入门(十三)图像运动模糊
1.原理 运动模糊产生: 由于相机传感器或物体相对运动, 按快门瞬间造成图像产生运动模糊. 在用摄像机获取景物图像时,如果在相机曝光期间景物和摄像机之间存在相对运动,例如用照相机拍摄快速运动的物体,或 ...
- 【图文+视频新手也友好】Java一维数组详细讲解(内含练习题答案+详解彩蛋喔~)
目录 视频讲解: 一.数组的概述 二.一维数组的使用 三.Arrays工具类中的sort方法(sort方法用的多,我们具体讲一下) 四.数组中的常见异常 五.一维数组练习题 六.彩蛋(本期视频使用的P ...
- Java 添加、读取、删除Excel文本框
本文介绍通过Java程序添加文本框到Excel的方法,添加文本框时,可以添加文本.设置文本方向.文本对齐方式.设置文本框大小.位置.填充色/填充图片.文本框旋转角度.文本框名称.可选文本.文本框隐藏或 ...
- Vue2.0 【第四季】第1节 实例入门-实例属性
目录 Vue2.0 [第四季]第1节 实例入门-实例属性 第1节 实例入门-实例属性 一.Vue和Jquery.js一起使用 二.实例调用自定义方法 Vue2.0 [第四季]第1节 实例入门-实例属性 ...
- 基于 Roslyn 实现一个简单的条件解析引擎
基于 Roslyn 实现一个简单的条件解析引擎 Intro 最近在做一个勋章的服务,我们想定义一些勋章的获取条件,满足条件之后就给用户颁发一个勋章,定义条件的时候会定义需要哪些参数,参数的类型,获取勋 ...
- python基础--深浅拷贝copy
拷贝是音译的词,其实他是从copy这个英文单词音译过来的,那什么是copy? copy其实就是复制一份,也就是所谓的抄一份.深浅copy其实就是完全复制一份,和部分复制一份的意思. 1.赋值运算 l1 ...