
python爬虫之requests的高级使用
1、requests能上传文件
# 导入requests模块

import requests

# 定义一个dict

files = {'file': open('D:/360Downloads/1.txt', 'rb')}

# post请求

response = requests.post("http://httpbin.org/post",files=files)

# 以字符串形式返回

print(response.text)
结果:
{
"args": {},
"data": "",
"files": {
"file": "data:application/octet-stream;base64,ZGVtbzAxxOO6ww=="
},
"form": {},
"headers": {
"Accept": "*/*",
"Accept-Encoding": "gzip, deflate",
"Content-Length": "151",
"Content-Type": "multipart/form-data; boundary=9502063320dadabde8e0197a299a933c",
"Host": "httpbin.org",
"User-Agent": "python-requests/2.23.0",
"X-Amzn-Trace-Id": "Root=1-5e71d1bc-221f2f9c5a23aa1c11d21b3c"
},
"json": null,
"origin": "111.77.5.100",
"url": "http://httpbin.org/post"
}
Process finished with exit code 0
2、requests能获取cookies(网页识别码)
# 导入requests模块
import requests
# get请求
response=requests.get("https://fanyi.baidu.com")
# 获取cookies
print(response.cookies)
# 获取cookies信息
print(tuple(response.cookies))
# 调用items,遍历一个dict的key和value
for key,value in response.cookies.items():
    print(key+"="+value)
结果:
<RequestsCookieJar[<Cookie BAIDUID=72BE4EB04DB39349C036BA1BDF4D2895:FG=1 for .baidu.com/>]>
(Cookie(version=0, name='BAIDUID', value='72BE4EB04DB39349C036BA1BDF4D2895:FG=1', port=None, port_specified=False, domain='.baidu.com', domain_specified=True, domain_initial_dot=True, path='/', path_specified=True, secure=False, expires=1616058282, discard=False, comment=None, comment_url=None, rest={}, rfc2109=True),)
BAIDUID=405DCB00DFE182D6581CBFAA3297C6BA:FG=1
Process finished with exit code 0
知道cookies的name,快速访问cookies的value:
# 导入requests模块

import requests

# get请求

response= requests.get('http://fanyi.baidu.com')

# 访问cookies的值

print(response.cookies['BAIDUID'])

# 以元组形式返回cookies

print(tuple(response.cookies))
结果:
B5A1A6A7B622F295DF802DA4D10F92CB:FG=1
(Cookie(version=0, name='BAIDUID', value='B5A1A6A7B622F295DF802DA4D10F92CB:FG=1', port=None, port_specified=False, domain='.baidu.com', domain_specified=True, domain_initial_dot=True, path='/', path_specified=True, secure=False, expires=1616068429, discard=False, comment=None, comment_url=None, rest={}, rfc2109=True),)
Process finished with exit code 0
3、会话维持
cookies一个作用就是模拟登入,做会话维持,如何把自己的cookies发送到服务器上:
# 导入requests模块
import requests
# 导入json模块
import json
# 定义cookies,dict形式
cookies={"number":"1234567"}
# get请求,加上
response=requests.get("http://httpbin.org/cookies",cookies=cookies)
# 以字符串形式返回
print(response.text)
结果:
{
"cookies": {
"number": "1234567"
}
}
Process finished with exit code 0
或者用requests.session也可以把自己的cookies发到服务器上:
# 导入requests模块

import requests

# 建立session对象

session = requests.session()

# get请求

response = session.get('http://httpbin.org/cookies/set/number/1234567')

# 以字符串形式返回

print(response.text)
结果:
{
"cookies": {
"number": "1234567"
}
}
Process finished with exit code 0
4、证书验证
# 导入requests模块

import requests

# get请求

response = requests.get('https://www.12306.cn')

# 在请求https时,request会进行证书的验证,如果验证失败则会抛出异常

print(response.status_code)
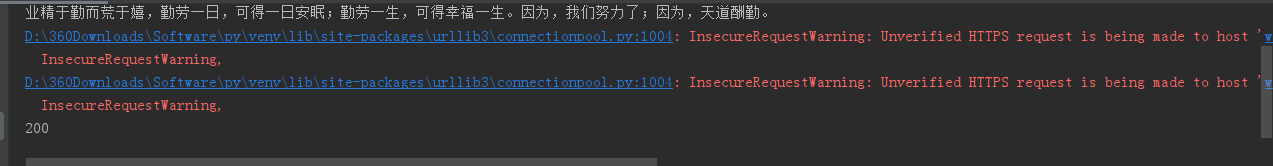
如果无证书验证,会抛出异常。有证书验证,返回200。
怎么关闭证书验证:
# 导入requests模块

import requests

# get请求,关闭证书验证

response = requests.get('https://www.12306.cn',verify=False)

# 在请求https时,request会进行证书的验证,如果验证失败则会抛出异常

print(response.status_code)
结果:显示有warning
关闭证书验证后,怎么消除waring:
# 导入urllib3函数

from requests.packages import urllib3

# 导入requests模块

import requests

# 消除警告

urllib3.disable_warnings()

# get请求

response = requests.get('https://www.12306.cn', verify=False)

# 返回状态代码

print(response.status_code)
结果:200
python爬虫之requests的高级使用的更多相关文章
- Python爬虫Urllib库的高级用法
Python爬虫Urllib库的高级用法 设置Headers 有些网站不会同意程序直接用上面的方式进行访问,如果识别有问题,那么站点根本不会响应,所以为了完全模拟浏览器的工作,我们需要设置一些Head ...
- 孤荷凌寒自学python第六十七天初步了解Python爬虫初识requests模块
孤荷凌寒自学python第六十七天初步了解Python爬虫初识requests模块 (完整学习过程屏幕记录视频地址在文末) 从今天起开始正式学习Python的爬虫. 今天已经初步了解了两个主要的模块: ...
- Python爬虫练习(requests模块)
Python爬虫练习(requests模块) 关注公众号"轻松学编程"了解更多. 一.使用正则表达式解析页面和提取数据 1.爬取动态数据(js格式) 爬取http://fund.e ...
- python爬虫之requests库
在python爬虫中,要想获取url的原网页,就要用到众所周知的强大好用的requests库,在2018年python文档年度总结中,requests库使用率排行第一,接下来就开始简单的使用reque ...
- Python爬虫之requests
爬虫之requests 库的基本用法 基本请求: requests库提供了http所有的基本请求方式.例如 r = requests.post("http://httpbin.org/pos ...
- Python 爬虫二 requests模块
requests模块 Requests模块 get方法请求 整体演示一下: import requests response = requests.get("https://www.baid ...
- python爬虫之requests的基本使用
简介 Requests是用python语言基于urllib编写的,采用的是Apache2 Licensed开源协议的HTTP库,Requests它会比urllib更加方便,可以节约我们大量的工作. 一 ...
- python爬虫之requests库介绍(二)
一.requests基于cookie操作 引言:有些时候,我们在使用爬虫程序去爬取一些用户相关信息的数据(爬取张三“人人网”个人主页数据)时,如果使用之前requests模块常规操作时,往往达不到我们 ...
- Python爬虫之requests库介绍(一)
一:Requests: 让 HTTP 服务人类 虽然Python的标准库中 urllib2 模块已经包含了平常我们使用的大多数功能,但是它的 API 使用起来让人感觉不太好,而 Requests 自称 ...
随机推荐
- echarts 图点击事件
有三种方式,介绍一下,大家学习哈 1.利用tooltip记录信息,使用zr 监听事件,进行事件处理. 这种方法是利用showTip方法或者tooltip的formatter函数记录选中的数据信息,并在 ...
- ASP.NET Core身份认证服务框架IdentityServer4 介绍
IdentityServer4是ASP.NET Core 2的OpenID Connect和OAuth 2.0框架.它可以在您的应用程序中提供以下功能: 它使你的应用程序具有如下特点: 认证即服务 适 ...
- 数据结构之HashMap
前言 在我们开发中,HashMap是我们非常常用的数据结构,接下来我将进一步去了解HashMap的原理.结构. 1.HashMap的实现原理 HashMap底层是基于Hash表(也称“散列”)的数据结 ...
- 关于form表单:hover没有修改表单子元素样式
原来在写todolist的时候遇到的一个问题 是关于form表单的hover属性设置背景颜色 想要实现的效果如下: 但是一开始直接给form加hover选择器的时候是这样: 可以看到这样子直接加会使得 ...
- 文本编辑器 - Sublime Text 3 换行无法自动缩进的解决方法
一.换行无法自动缩进的问题,如图: 稍微查了一下网上的办法,是把汉化文件删除,但是会造成菜单栏混乱,简直无法忍受... 那么这里介绍的是另一种解决办法.在用户的热键配置文件(preferences-k ...
- Java 添加、读取、删除Excel文本框
本文介绍通过Java程序添加文本框到Excel的方法,添加文本框时,可以添加文本.设置文本方向.文本对齐方式.设置文本框大小.位置.填充色/填充图片.文本框旋转角度.文本框名称.可选文本.文本框隐藏或 ...
- Kona JDK 在腾讯大数据领域内的实践与发展
导语 | 近日,云+社区技术沙龙“腾讯开源技术”圆满落幕.本次沙龙邀请了多位腾讯技术专家,深度揭秘了腾讯开源项目TencentOS tiny.TubeMQ.Kona JDK.TARS以及Medical ...
- 一键配置openstack-cata版的在线yum源
下面脚本可以直接复制来配置openstack-ocata版的yum源: echo "nameserver 8.8.8.8 nameserver 119.29.29.29 nameserver ...
- 【视频+图文】Java基础经典练习题(一)输出2-100之间的素数,及素数个数
目录 第一题:判断2-100之间有多少个素数,并输出所有素数. 1.视频讲解: 2.思路分析: 代码讲解:以i=4为例 4.为大家准备了彩蛋: 能解决题目的代码并不是一次就可以写好的 我们需要根据我们 ...
- 初始Django—Hello world
1. 准备环境 > python -V Python > pip -V pip from c:\python3\lib\site-packages\pip (python 3.7) > ...