
python3+selenium3+requests爬取我的博客粉丝的名称
爬取目标
1.本次代码是在python3上运行通过的
- selenium3 +firefox59.0.1(最新)
- BeautifulSoup
- requests
2.爬取目标网站,我的博客:https://home.cnblogs.com/u/lxs1314
爬取内容:爬我的博客的所有粉丝的名称,并保存到txt
3.由于博客园的登录是需要人机验证的,所以是无法直接用账号密码登录,需借助selenium登录
直接贴代码:
# coding:utf-8

# __author__ = 'Carry'

import requests

from selenium import webdriver

from bs4 import BeautifulSoup

import re

import time

# firefox浏览器配置文件地址

profile_directory = r'C:\Users\Administrator\AppData\Roaming\Mozilla\Firefox\Profiles\pxp74n2x.default'

s = requests.session()  # 新建session

url = "https://home.cnblogs.com/u/lxs1314"

def get_cookies(url):

    '''启动selenium获取登录的cookies'''

    # 加载配置

    profile = webdriver.FirefoxProfile(profile_directory)

    # 启动浏览器配置

    driver = webdriver.Firefox(profile)

    driver.get(url+"/followers")

    time.sleep(3)

    cookies = driver.get_cookies()  # 获取浏览器cookies

    print(cookies)

    driver.quit()

    return cookies

def add_cookies(cookies):

    '''往session添加cookies'''

    # 添加cookies到CookieJar

    c = requests.cookies.RequestsCookieJar()

    for i in cookies:

        c.set(i["name"], i['value'])

    s.cookies.update(c)  # 更新session里cookies

def get_ye_nub(url):

    # 发请求

    r1 = s.get(url+"/relation/followers")

    soup = BeautifulSoup(r1.content, "html.parser")

    # 抓取我的粉丝数

    fensinub = soup.find_all(class_="current_nav")

    print (fensinub[0].string)

    num = re.findall(u"我的粉丝\((.+?)\)", fensinub[0].string)

    print (u"我的粉丝数量:%s"%str(num[0]))

    # 计算有多少页,每页45条

    ye = int(int(num[0])/45)+1

    print (u"总共分页数:%s"%str(ye))

    return ye

def save_name(nub):

    # 抓取第一页的数据

    if nub <= 1:

        url_page = url+"/relation/followers"

    else:

        url_page = url+"/relation/followers?page=%s" % str(nub)

    print (u"正在抓取的页面:%s" %url_page)

    r2 = s.get(url_page)

    soup = BeautifulSoup(r2.content, "html.parser")

    fensi = soup.find_all(class_="avatar_name")

    for i in fensi:

        name = i.string.replace("\n", "").replace(" ","")

        print (name)

        with open("name.txt", "a") as f:  # 追加写入

            f.write(name+"\n")

            #name.encode("utf-8")

if __name__ == "__main__":

    cookies = get_cookies(url)

    add_cookies(cookies)

    n = get_ye_nub(url)

    for i in range(1, n+1):

        save_name(i)
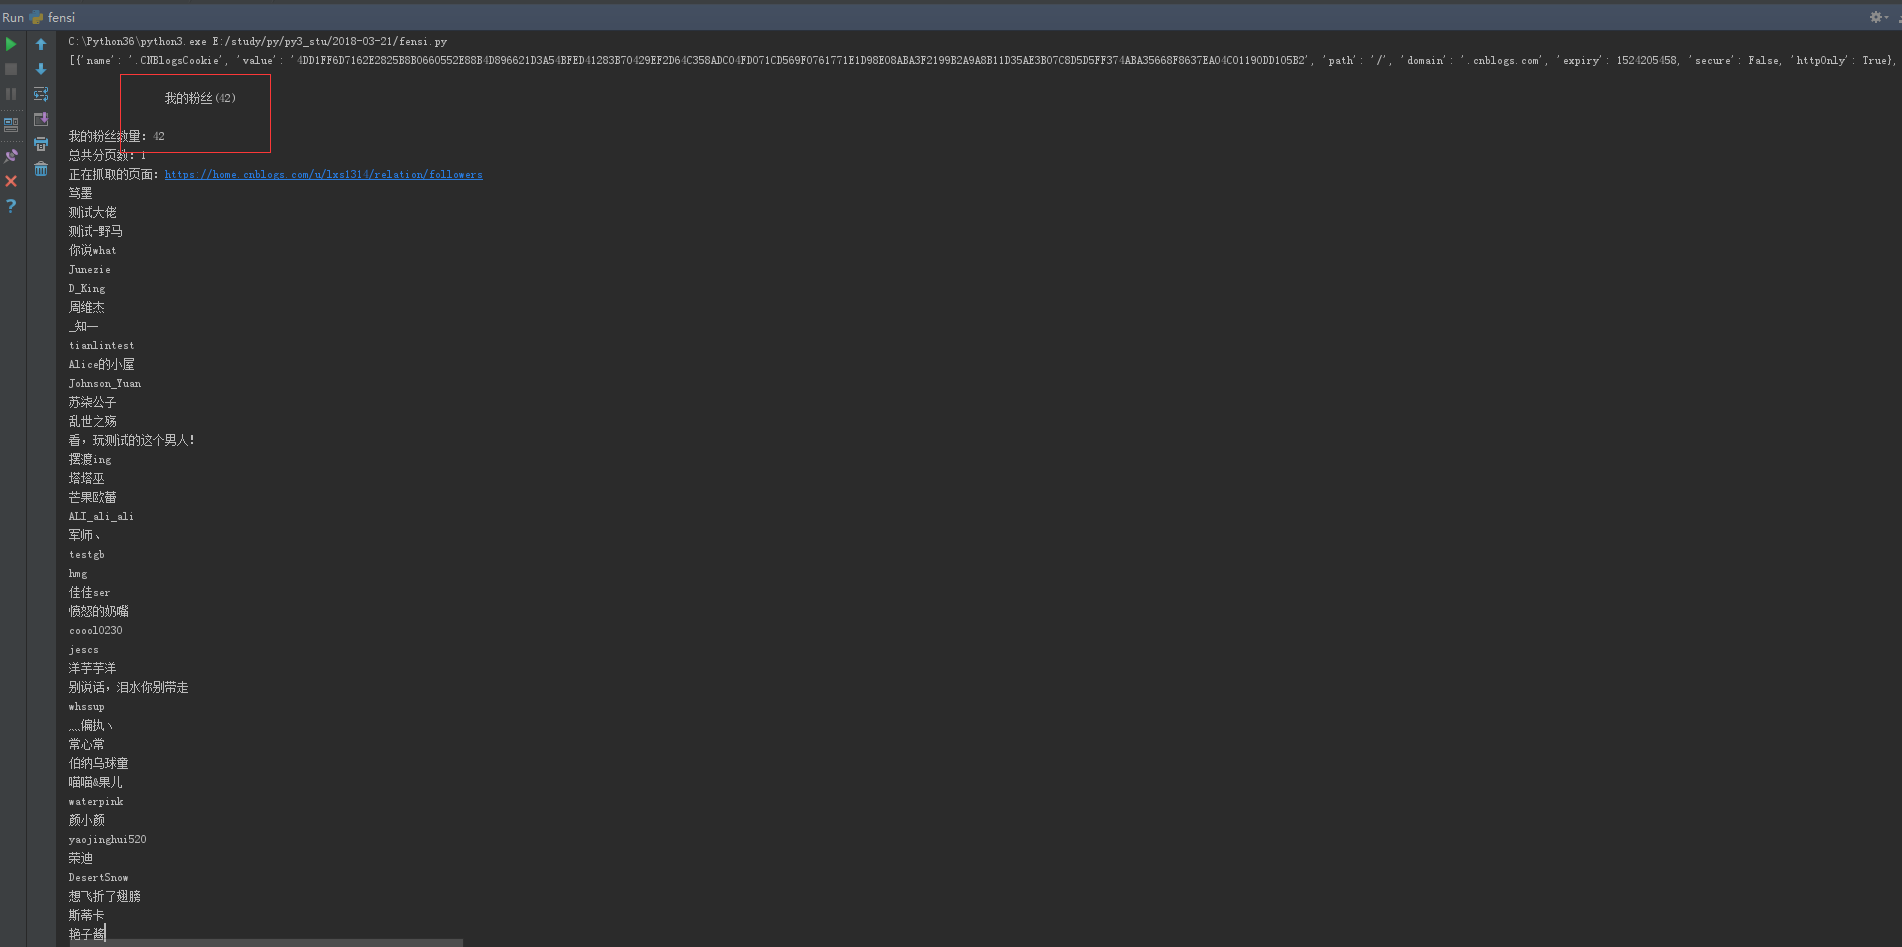
原文链接:http://www.cnblogs.com/yoyoketang/p/8610779.html
python3+selenium3+requests爬取我的博客粉丝的名称的更多相关文章
- python+selenium+requests爬取我的博客粉丝的名称
爬取目标 1.本次代码是在python2上运行通过的,python3的最需改2行代码,用到其它python模块 selenium 2.53.6 +firefox 44 BeautifulSoup re ...
- Python爬虫小实践:爬取任意CSDN博客所有文章的文字内容(或可改写为保存其他的元素),间接增加博客访问量
Python并不是我的主业,当初学Python主要是为了学爬虫,以为自己觉得能够从网上爬东西是一件非常神奇又是一件非常有用的事情,因为我们可以获取一些方面的数据或者其他的东西,反正各有用处. 这两天闲 ...
- Scrapy爬取自己的博客内容
python中常用的写爬虫的库有urllib2.requests,对于大多数比较简单的场景或者以学习为目的,可以用这两个库实现.这里有一篇我之前写过的用urllib2+BeautifulSoup做的一 ...
- python3使用requests爬取新浪热门微博
微博登录的实现代码来源:https://gist.github.com/mrluanma/3621775 相关环境 使用的python3.4,发现配置好环境后可以直接使用pip easy_instal ...
- 开发记录_自学Python写爬虫程序爬取csdn个人博客信息
每天刷开csdn的博客,看到一整个页面,其实对我而言,我只想看看访问量有没有上涨而已... 于是萌生了一个想法: 想写一个爬虫程序把csdn博客上边的访问量和评论数都爬下来. 打算通过网络各种搜集资料 ...
- step2: 爬取廖雪峰博客
#https://zhuanlan.zhihu.com/p/26342933 #https://zhuanlan.zhihu.com/p/26833760 scrapy startproject li ...
- scrapy 爬取自己的博客
定义项目 # -*- coding: utf-8 -*- # items.py import scrapy class LianxiCnblogsItem(scrapy.Item): # define ...
- requests爬取百度音乐
使用requests爬取百度音乐,我想把当前热门歌手的音乐信息爬下来. 首先进行url分析,可以看到: 歌手网页: 薛之谦网页: 可以看到,似乎这些路劲的获取一切都很顺利,然后可以写代码: # -*- ...
- Python爬虫入门——使用requests爬取python岗位招聘数据
爬虫目的 使用requests库和BeautifulSoup4库来爬取拉勾网Python相关岗位数据 爬虫工具 使用Requests库发送http请求,然后用BeautifulSoup库解析HTML文 ...
随机推荐
- 怎么使用Spring配置事务 ?
Spring同时支持编程式事务策略和声明式事务策略,大部分时候都采用声明式事务策略. 声明式事务管理的配置方式,通常有以下4种: (1) 使用TransactionProxyFactoryBean为目 ...
- css学习杂记
1.css中的&语法 &是sass的语法,代表上一级选择器. 例如: .el-row { margin-bottom: 20px; &:last-child { margin- ...
- 自己编写的:centos6.6上编译安装apache2.4+php5.6+mysql5.6【亲自】
在centos6.6上安装apache2.4+php5.6+mysql5.6 关于wget的安装 将之前装系统的.iso文件挂载到光驱 由于我在/home/jinnan/下建立了一个cdrom文件夹 ...
- 算法设计:UNION-FIND算法实现
在上周的算法设计课程中,我们学习了UNION-FIND算法,该算法用来对不相交集进行查询与合并操作,但任何优秀的算法都必须要用实际的代码来进行实现,接下来我们就来看看具体的代码实现 1. 不相关集数据 ...
- Oracle数据库之分组查询及排序
分组查询:使用 group by 来设置分组,把该列具有相同值的多条记录当成一组记录来处理,然后只会输出一条记录,得到的结果会默认使用升序的方式进行排列. 规则: (1)如果使用了分组函数,或者是 g ...
- 遇到执行SQL 的参数最大个数
报错: 传入的表格格式数据流(TDS)远程过程调用(RPC)协议流不正确.此 RPC 请求中提供了过多的参数.最多应为 2100. 现象是: SQL 执行的参数过多,超过了 最大值 :2100 个. ...
- url的param与dict转换
urllib.parse.urlencode urlencode from urllib import parse from urllib.request import urlopen from ur ...
- web14 validation.xml配置 登录验证文件配置
电影网站:www.aikan66.com 项目网站:www.aikan66.com 游戏网站:www.aikan66.com 图片网站:www.aikan66.com 书籍网站:www.aikan66 ...
- fullPage全屏高度自适应
<!DOCTYPE html> <html> <head> <meta http-equiv="Content-Type" content ...
- Reaction to 构造之法 of Software Engineering From The First Chapter toThe Fifth Chapter
几个星期前,我阅读过一篇文章,一位老师教导自己的学生要积极地去阅读文学文献,其中,我很欣赏他的一句话:“Just think of liturature as if you're reading a ...