
Python爬虫入门——使用requests爬取python岗位招聘数据
爬虫目的
使用requests库和BeautifulSoup4库来爬取拉勾网Python相关岗位数据
爬虫工具
使用Requests库发送http请求,然后用BeautifulSoup库解析HTML文档对象,并提取职位信息。
爬取过程
1.请求地址
https://www.lagou.com/zhaopin/Python/
2.需要爬取的内容
(1)岗位名称
(2)薪资
(3)公司所在地
3.查看html
使用FireFox浏览器,登陆拉勾网,按F12可以进入开发者工具页面:
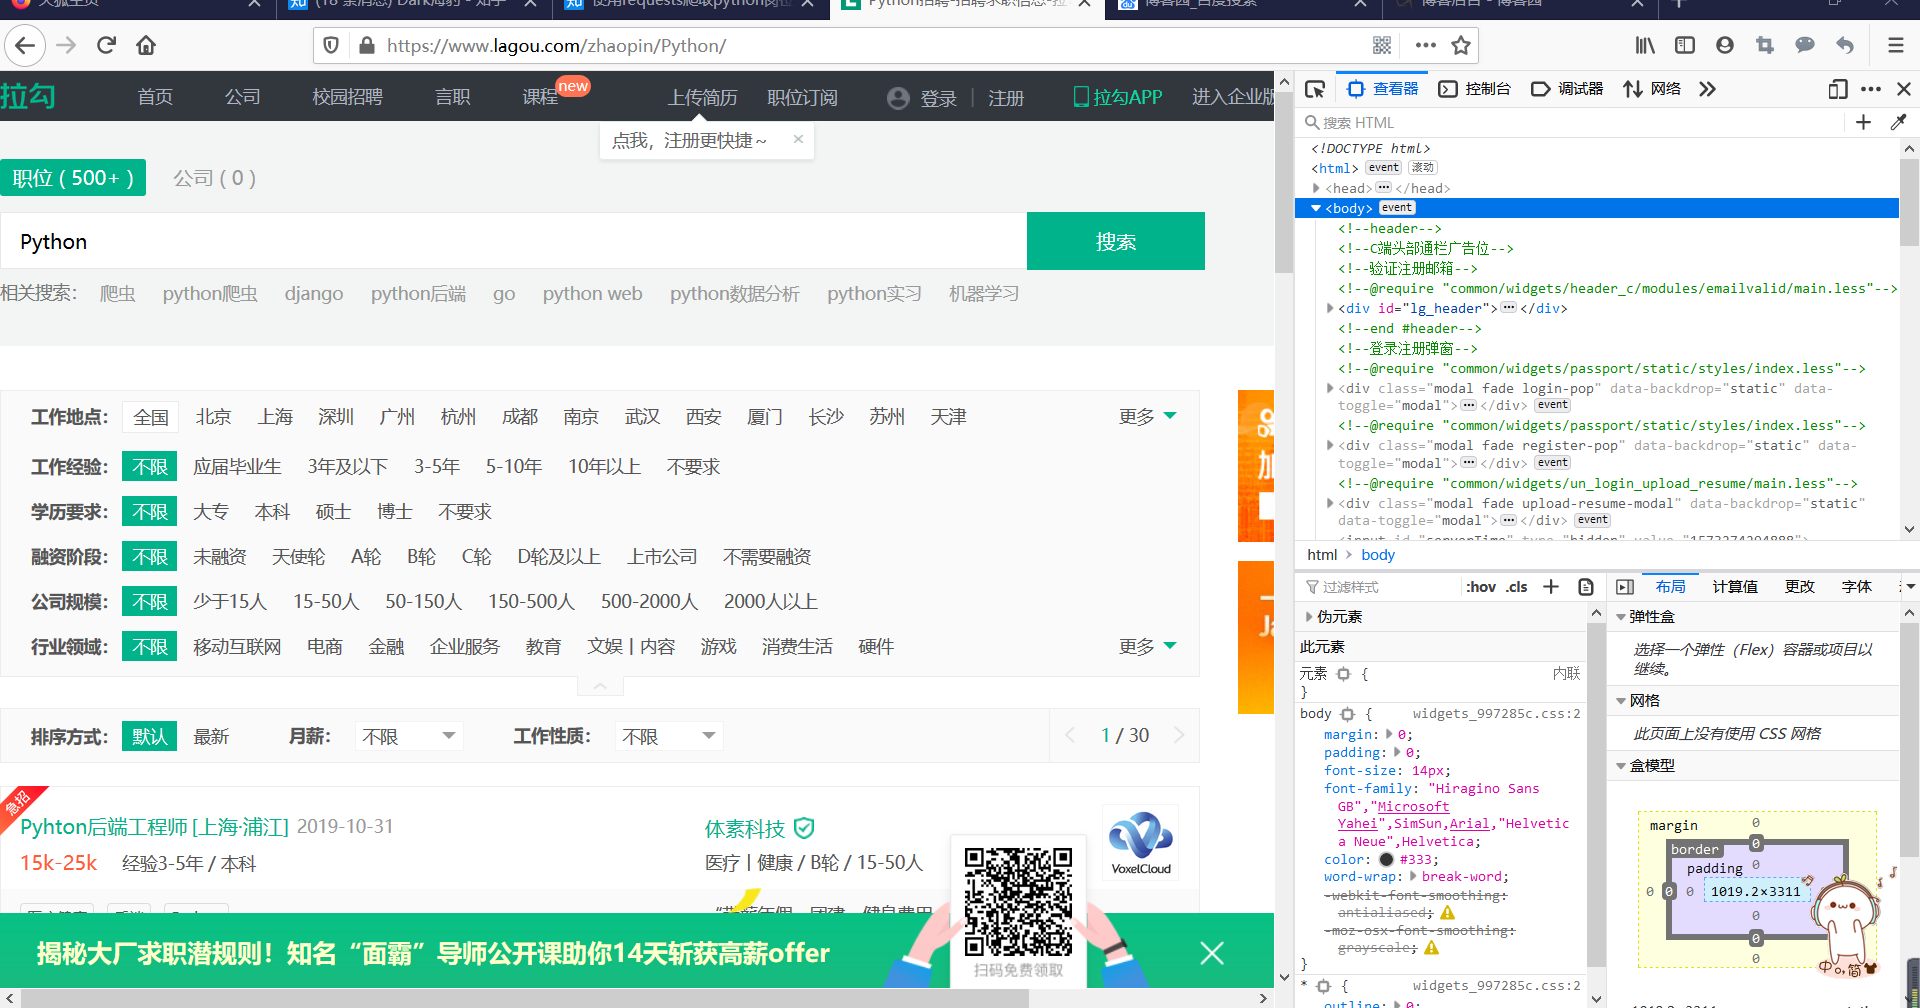
这时候会看到该页面的html网页源码。
接下来需要寻找岗位信息对应的源码,比如岗位名称:
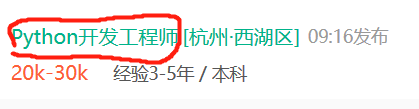
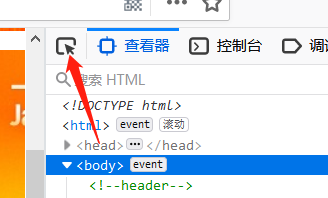
在开发者工具页面左上角有个箭头标志,点击它,然后再点击岗位名称,就能看到对应的源码。
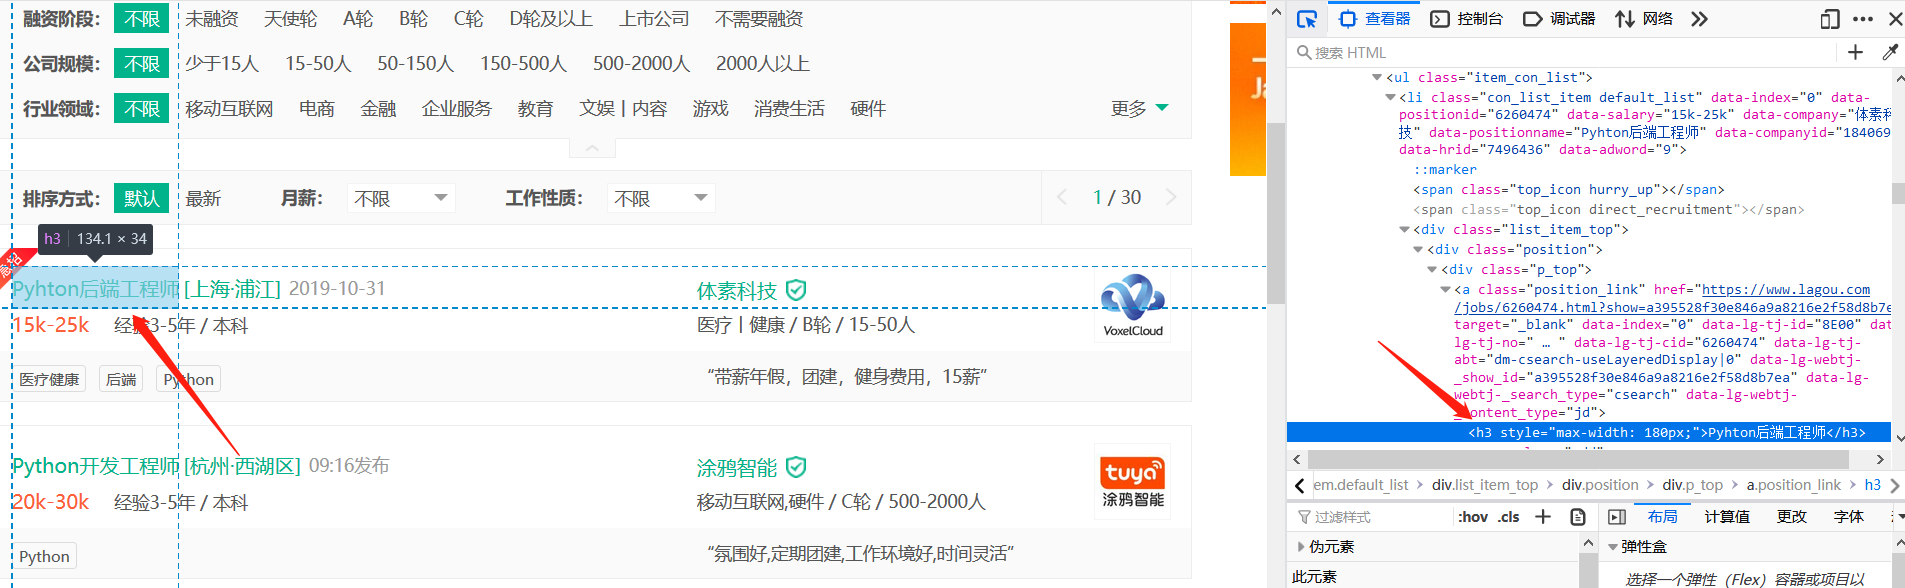
知道对应的源码后,还需要知道请求头:
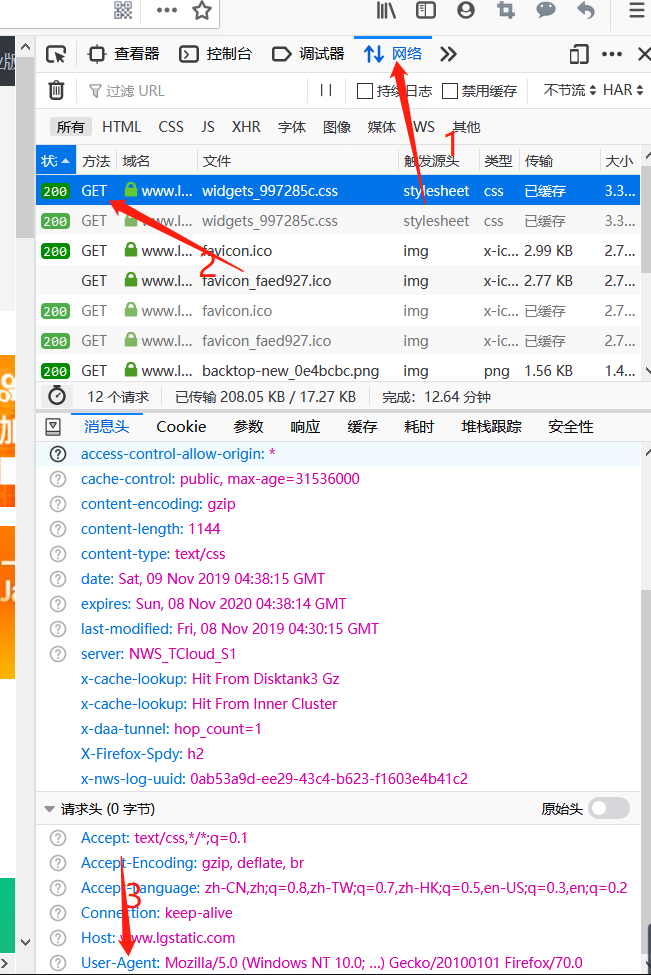
点击“网络”,之后点击“get”,在最下方User-Agent中的内容就是请求头
(如果是使用Chrome浏览器或者其它浏览器方法会有所不同)
完成上述操作后就可以利用BeautifulSoup4提取里面的文本。
利用requests发出数据请求
import requests

import io

import sys

from bs4 import BeautifulSoup

sys.stdout=io.TextIOWrapper(sys.stdout.buffer,encoding='gb18030')

headers = {

        'User-Agent':'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/72.0.3626.109 Safari/537.36',}

r = requests.get('https://www.lagou.com/zhaopin/Python/',headers=headers)  #设置请求头

r.encoding=r.apparent_encoding

result=r.text

bs=BeautifulSoup(result,'html.parser')  #创建一个BeautifulSoup对象
利用BeautifulSoup提取网页数据
b=[]  #创建空列表用来存储爬取的数据

a=[]

d=[]

name = bs.find_all('h3')  #获取所有包含'h3'标签的内容
’

for h3 in name:

    b.append(h3.string)

money = bs.find_all('span',attrs={'class':'money'})

for span in money:

    a.append(span.string)  #获取字符串形式的数据

ltd=bs.find_all('em')

for em in ltd:

    d.append(em.string)

i=0

print("职业:","           薪资:","    地点:")

try:

    while True:

        print(b[i],a[i],d[i])

        i+=1

except IndexError:

    print()
Python爬虫入门——使用requests爬取python岗位招聘数据的更多相关文章
- Python爬虫入门教程 42-100 爬取儿歌多多APP数据-手机APP爬虫部分
1. 儿歌多多APP简单分析 今天是手机APP数据爬取的第一篇案例博客,我找到了一个儿歌多多APP,没有加固,没有加壳,没有加密参数,对新手来说,比较友好,咱就拿它练练手,熟悉一下Fiddler和夜神 ...
- Python爬虫:为什么你爬取不到网页数据
前言: 之前小编写了一篇关于爬虫为什么爬取不到数据文章(文章链接为:Python爬虫经常爬不到数据,或许你可以看一下小编的这篇文章), 但是当时小编也是胡乱编写的,其实里面有很多问题的,现在小编重新发 ...
- python爬虫入门10分钟爬取一个网站
一.基础入门 1.1什么是爬虫 爬虫(spider,又网络爬虫),是指向网站/网络发起请求,获取资源后分析并提取有用数据的程序. 从技术层面来说就是 通过程序模拟浏览器请求站点的行为,把站点返回的HT ...
- Python 爬虫入门实例(爬取小米应用商店的top应用apk)
一,爬虫是什么? 爬虫就是获取网络上各种资源,数据的一种工具.具体的可以自行百度. 二,如何写简单爬虫 1,获取网页内容 可以通过 Python(3.x) 自带的 urllib,来实现网页内容的下载. ...
- Python爬虫之简单的爬取百度贴吧数据
首先要使用的第类库有 urllib下的request 以及urllib下的parse 以及 time包 random包 之后我们定义一个名叫BaiduSpider类用来爬取信息 属性有 url: ...
- Python爬虫实战一之爬取糗事百科段子
大家好,前面入门已经说了那么多基础知识了,下面我们做几个实战项目来挑战一下吧.那么这次为大家带来,Python爬取糗事百科的小段子的例子. 首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把 ...
- python爬虫学习01--电子书爬取
python爬虫学习01--电子书爬取 1.获取网页信息 import requests #导入requests库 ''' 获取网页信息 ''' if __name__ == '__main__': ...
- python爬虫:了解JS加密爬取网易云音乐
python爬虫:了解JS加密爬取网易云音乐 前言 大家好,我是"持之以恒_liu",之所以起这个名字,就是希望我自己无论做什么事,只要一开始选择了,那么就要坚持到底,不管结果如何 ...
- Python爬虫实战二之爬取百度贴吧帖子
大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 前言 亲爱的们,教程比较旧了,百度贴吧页面可能改版,可能代码不 ...
随机推荐
- mavn jar包依赖冲突解决
背景:使用maven很方便,但是引入冲突也很常见.后果很严重,各种不明实体找不到,所以需要对jar包的依赖有一个清晰的认识. 查看冲突 参考:用dependency:tree查看maven引入jar包 ...
- 【转】【bat】Bat 中特殊符号
批处理.Bat 中特殊符号的实际作用,Windows 批处理中特殊符号的作用: @\\隐藏命令的回显. ~\\在for中表示使用增强的变量扩展:在set中表示使用扩展环境变量指定位置的字符串:在set ...
- JVM的基本结构和JVM的内存结构
这里概要介绍一下JVM在启动后,作为操作系统的一个进程的基本结构,以及从操作系统角度看,JVM如何管理它从操作系统里申请来的内存的,也就是JVM的内存结构或者叫JVM内存模型. 1.JVM的基本结构 ...
- kafka-manager 创建 topic【转】
1,add cluster 添加cluster 添加cluster 选择一下kafka的版本 2,创建topic 添加topic 3,查看topic 查看topic
- Resouce Pool的理解
本篇文章从现象到本质再到具象去理解 , 从理论到实战再到源码回顾去深化. 1.在开发中,无处不在的池. eg 网络通信连接池: HttpClient连接池 HttpClient通过PoolingHtt ...
- redis底层实现的几种数据结构
redis底层数据结构 一.简单动态字符串(SDS) 定义: struct sdshdr{ int len; //SDS所保存的字符串长度 int free //记录buf数组中为使用的字节数量 ...
- python基础教程_查询价格
少儿编程和数学是有这一定联系的,若是将编程弄好了,数学成绩也就会有所提高,今天就为大家来介绍一下一个关于数学的相关编程,现在我们就来看看吧! 题目描述 编程实现以下功能:查询水果的单价.有4种水果,苹 ...
- Python 入门(1):hello world 到流程控制
1.hello world 在D:\python\目录下新建文件hello.txt,编写代码如下 print("hello world!") 修改后缀名为.py,执行hello.p ...
- 【题解】Luogu P5341 [TJOI2019]甲苯先生和大中锋的字符串
原题传送门 实际按照题意模拟就行 我们先求出字符串的sa 因为要在字符串中出现k次,所以我们枚举\(l,r(r-l+1=k)\)看一共有多少种合法的方案 合法方案的长度下界\(lb\)为\(Max(h ...
- IDEA远程调试Ambari Server
1.配置端口 Ambari Server默认配置了服务端的debug参数,端口为5005.如果要修改端口,可以在/usr/sbin/ambari_server_main.py文件中对应地方修改,直接改 ...