
Hive学习之路 (十七)Hive分析窗口函数(五) GROUPING SETS、GROUPING__ID、CUBE和ROLLUP
概述
GROUPING SETS,GROUPING__ID,CUBE,ROLLUP
这几个分析函数通常用于OLAP中,不能累加,而且需要根据不同维度上钻和下钻的指标统计,比如,分小时、天、月的UV数。
数据准备
数据格式
2015-03,2015-03-10,cookie1

2015-03,2015-03-10,cookie5

2015-03,2015-03-12,cookie7

2015-04,2015-04-12,cookie3

2015-04,2015-04-13,cookie2

2015-04,2015-04-13,cookie4

2015-04,2015-04-16,cookie4

2015-03,2015-03-10,cookie2

2015-03,2015-03-10,cookie3

2015-04,2015-04-12,cookie5

2015-04,2015-04-13,cookie6

2015-04,2015-04-15,cookie3

2015-04,2015-04-15,cookie2

2015-04,2015-04-16,cookie1
创建表
use cookie;

drop table if exists cookie5;

create table cookie5(month string, day string, cookieid string)

row format delimited fields terminated by ',';

load data local inpath "/home/hadoop/cookie5.txt" into table cookie5;

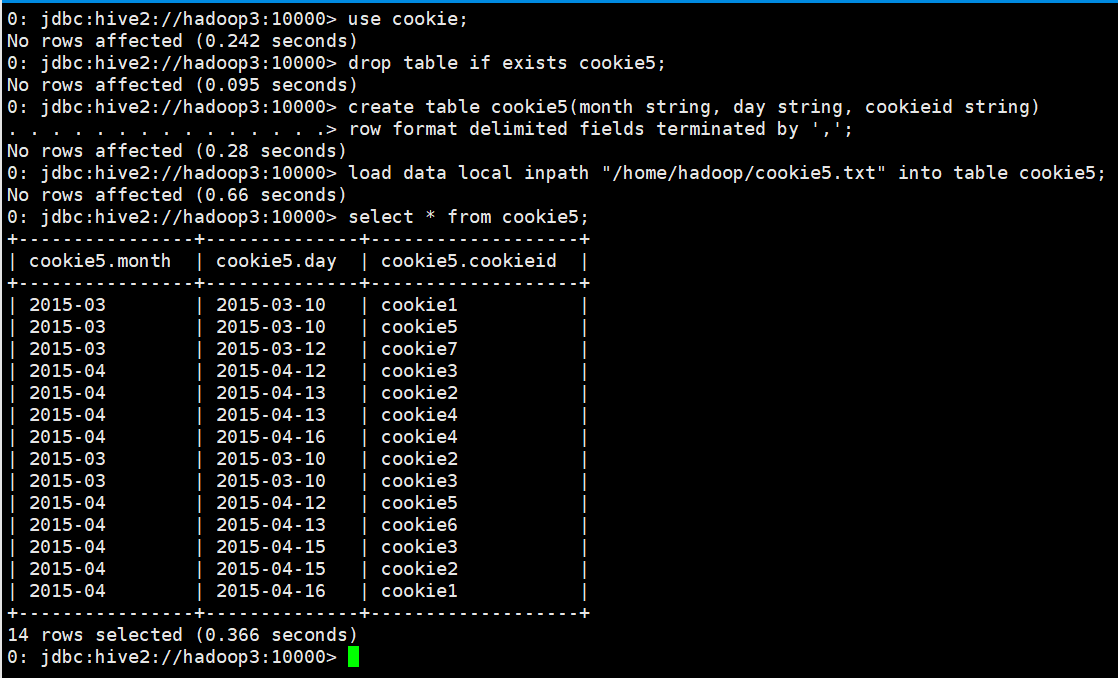
select * from cookie5;
玩一玩GROUPING SETS和GROUPING__ID
说明
在一个GROUP BY查询中,根据不同的维度组合进行聚合,等价于将不同维度的GROUP BY结果集进行UNION ALL
GROUPING__ID,表示结果属于哪一个分组集合。
查询语句
select

  month,

  day,

  count(distinct cookieid) as uv,

  GROUPING__ID

from cookie.cookie5

group by month,day

grouping sets (month,day)

order by GROUPING__ID;
等价于
SELECT month,NULL,COUNT(DISTINCT cookieid) AS uv,1 AS GROUPING__ID FROM cookie5 GROUP BY month

UNION ALL

SELECT NULL,day,COUNT(DISTINCT cookieid) AS uv,2 AS GROUPING__ID FROM cookie5 GROUP BY day
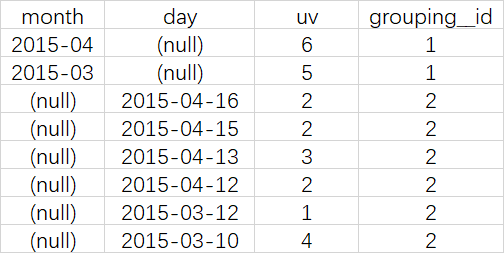
查询结果
结果说明
第一列是按照month进行分组
第二列是按照day进行分组
第三列是按照month或day分组是,统计这一组有几个不同的cookieid
第四列grouping_id表示这一组结果属于哪个分组集合,根据grouping sets中的分组条件month,day,1是代表month,2是代表day
再比如
SELECT  month, day,

COUNT(DISTINCT cookieid) AS uv,

GROUPING__ID

FROM cookie5

GROUP BY month,day

GROUPING SETS (month,day,(month,day))

ORDER BY GROUPING__ID;
等价于
SELECT month,NULL,COUNT(DISTINCT cookieid) AS uv,1 AS GROUPING__ID FROM cookie5 GROUP BY month

UNION ALL

SELECT NULL,day,COUNT(DISTINCT cookieid) AS uv,2 AS GROUPING__ID FROM cookie5 GROUP BY day

UNION ALL

SELECT month,day,COUNT(DISTINCT cookieid) AS uv,3 AS GROUPING__ID FROM cookie5 GROUP BY month,day

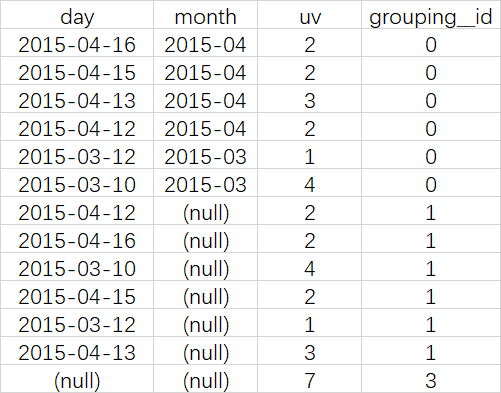
玩一玩CUBE
说明
根据GROUP BY的维度的所有组合进行聚合
查询语句
SELECT  month, day,

COUNT(DISTINCT cookieid) AS uv,

GROUPING__ID

FROM cookie5

GROUP BY month,day

WITH CUBE

ORDER BY GROUPING__ID;
等价于
SELECT NULL,NULL,COUNT(DISTINCT cookieid) AS uv,0 AS GROUPING__ID FROM cookie5

UNION ALL

SELECT month,NULL,COUNT(DISTINCT cookieid) AS uv,1 AS GROUPING__ID FROM cookie5 GROUP BY month

UNION ALL

SELECT NULL,day,COUNT(DISTINCT cookieid) AS uv,2 AS GROUPING__ID FROM cookie5 GROUP BY day

UNION ALL

SELECT month,day,COUNT(DISTINCT cookieid) AS uv,3 AS GROUPING__ID FROM cookie5 GROUP BY month,day
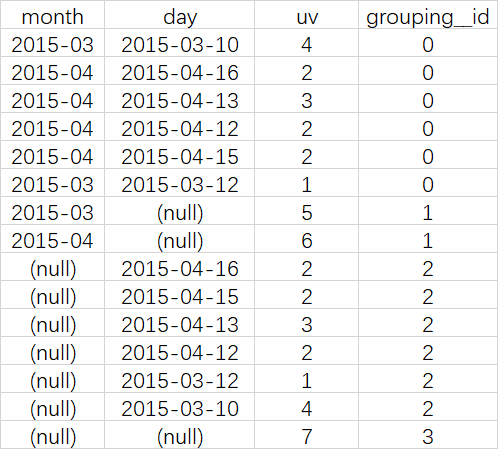
查询结果
玩一玩ROLLUP
说明
是CUBE的子集,以最左侧的维度为主,从该维度进行层级聚合
查询语句
-- 比如,以month维度进行层级聚合
SELECT  month, day, COUNT(DISTINCT cookieid) AS uv, GROUPING__ID

FROM cookie5

GROUP BY month,day WITH ROLLUP  ORDER BY GROUPING__ID;
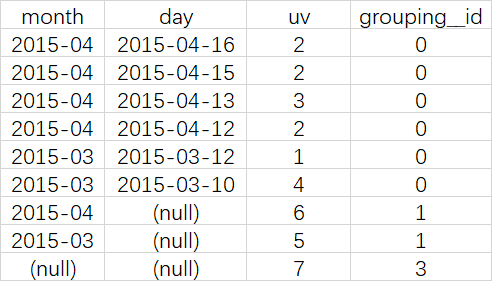
可以实现这样的上钻过程:
月天的UV->月的UV->总UV
--把month和day调换顺序,则以day维度进行层级聚合:
可以实现这样的上钻过程:
天月的UV->天的UV->总UV
(这里,根据天和月进行聚合,和根据天聚合结果一样,因为有父子关系,如果是其他维度组合的话,就会不一样)
Hive学习之路 (十七)Hive分析窗口函数(五) GROUPING SETS、GROUPING__ID、CUBE和ROLLUP的更多相关文章
- Hive高阶聚合函数 GROUPING SETS、Cube、Rollup
-- GROUPING SETS作为GROUP BY的子句,允许开发人员在GROUP BY语句后面指定多个统计选项,可以简单理解为多条group by语句通过union all把查询结果聚合起来结合起 ...
- Hive函数:GROUPING SETS,GROUPING__ID,CUBE,ROLLUP
参考:lxw大数据田地:http://lxw1234.com/archives/2015/04/193.htm 数据准备: CREATE EXTERNAL TABLE test_data ( mont ...
- [转帖]Hive学习之路 (一)Hive初识
Hive学习之路 (一)Hive初识 https://www.cnblogs.com/qingyunzong/p/8707885.html 讨论QQ:1586558083 目录 Hive 简介 什么是 ...
- Hive学习之路 (二十)Hive 执行过程实例分析
一.Hive 执行过程概述 1.概述 (1) Hive 将 HQL 转换成一组操作符(Operator),比如 GroupByOperator, JoinOperator 等 (2)操作符 Opera ...
- Hive学习之路 (一)Hive初识
Hive 简介 什么是Hive 1.Hive 由 Facebook 实现并开源 2.是基于 Hadoop 的一个数据仓库工具 3.可以将结构化的数据映射为一张数据库表 4.并提供 HQL(Hive S ...
- Hive学习之路 (二十一)Hive 优化策略
一.Hadoop 框架计算特性 1.数据量大不是问题,数据倾斜是个问题 2.jobs 数比较多的作业运行效率相对比较低,比如即使有几百行的表,如果多次关联多次 汇总,产生十几个 jobs,耗时很长.原 ...
- Hive学习之路 (十一)Hive的5个面试题
一.求单月访问次数和总访问次数 1.数据说明 数据字段说明 用户名,月份,访问次数 数据格式 A,, A,, B,, A,, B,, A,, A,, A,, B,, B,, A,, A,, B,, B ...
- Hive 学习之路(八)—— Hive 数据查询详解
一.数据准备 为了演示查询操作,这里需要预先创建三张表,并加载测试数据. 数据文件emp.txt和dept.txt可以从本仓库的resources目录下载. 1.1 员工表 -- 建表语句 CREAT ...
- Hive学习之路 (二)Hive安装
Hive的下载 下载地址http://mirrors.hust.edu.cn/apache/ 选择合适的Hive版本进行下载,进到stable-2文件夹可以看到稳定的2.x的版本是2.3.3 Hive ...
随机推荐
- [源码] 定义String s="abcd", 求长度
一般会答: s.length() 看源码是如何实现的: /** * Returns the length of this string. * The length is equal to the nu ...
- 【基于初学者的SSH】struts2 的拦截器、令牌的简单应用及理解
一:拦截器与过滤器类似,但是它们的区别也很大: 01):过滤器理论上可以过滤任意内容,比如HTML,servlet,jsp,图片路径 02):拦截器只可以拦截action. 二:拦截器的原理 act ...
- Windows应用程序对键盘与鼠标的响应
编写程序: 设计一个窗口, 当单击鼠标左键时, 窗口中显示"LEFT BUTTON"; 当单击鼠标右键时, 窗口中显示"RIGHT BUTTON"; 当单击 ...
- 【学习笔记】--- 老男孩学Python,day10, 初识函数 形参、实参
函数:对功能的封装语法: def 函数名(形参): 函数体 函数名(实参) 函数名:命名规则和变量一样 函数的返回值: return, 函数执行完毕. 不会执行后面逻辑 1. 如果函数中不写retur ...
- @media 各大尺寸
@media screen and (min-width:1200px){ #page{ width: 1100px; }#content,.div1{width: 730px;}#secondary ...
- 云数据库Redis版256M双机热备款
云数据库Redis版是兼容Redis协议标准的.提供持久化的缓存式数据库服务,基于高可靠双机热备架构:全新推出的256M小规格款,适用于高QPS.小数据量业务,并支持免费全量迁移,完美服务于个人开发者 ...
- error MSB3552: Resource file "**/*.resx" cannot be found. [/ConsoleApp1.csproj]
问题场景: 练习在docker下操作netcore,镜像为centos7,安装完netcore sdk 2.2后,执行操作: dotnet new consoledotnet run 出现报错: /u ...
- sqlserver 统计信息自动更新 ----trace flag 2371
对于已经应用的表(非临时表)统计信息更新条件为500+20%,具体更新条件 If the statistics is defined on a regular table, it is out of ...
- AWK与SED命令
linux系统比较常用的AWK与SED命令,这两个命令主要是格式化文本文件信息.接下来将详细介绍这两个命令的基本用法以及可以实现的功能. 一.AWK命令 AWK语言的基本功能是在文件或者字符串中基于指 ...
- Windows2003系统取消关机提示的方法
方法有两种:1.编辑组策略 打开“开始”-“运行”,在“打开”一栏中输入“gpedit.msc”命令打开组策略编辑器,依次展开“计算机配置”→“管理模板”→“系统”,双击右侧窗口出现的“显示‘关闭事件 ...