
IDEA提交任务到spark standalone集群
参考文章: 在idea里面怎么远程提交spark任务到yarn集群
代码
注意setJars,提交的代码,要提前打好包。否则会报找不到类的错误
个人理解就相当于运行的main方法是起了一个spark-submit任务,提交任务到集群时还是要指定好任务的jar包,以便复制到各个Executor执行代码。
import org.apache.spark.rdd.RDD

import org.apache.spark.{SparkConf, SparkContext}

object TestSparkStandalone {

  def main(args: Array[String]): Unit = {

    val conf = new SparkConf().setAppName("TestSparkStandalone")

      .setMaster("spark://xxx.xxx.xxx.xxx:7077")

      .setJars(List("D:\\CodePlace\\myspark\\target\\myspark-1.0-SNAPSHOT.jar"))

    val spark = new SparkContext(conf)

    val value: RDD[Int] = spark.makeRDD(1 to 5)

    value.foreach(println _)

  }

}
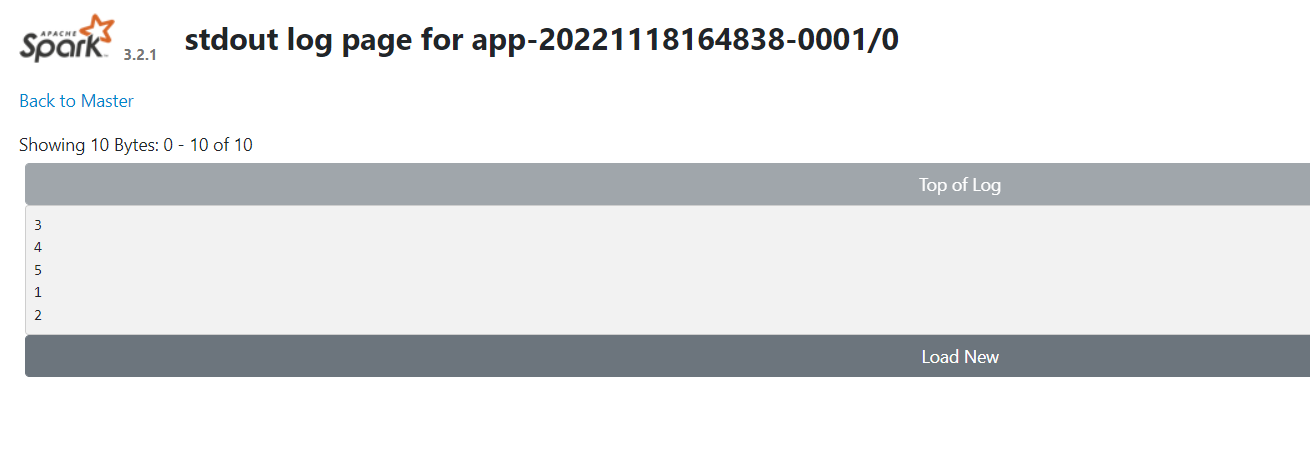
driver问题
报错内容:
Caused by: java.net.UnknownHostException: LAPTOP-2B1EN4I2
at java.net.InetAddress.getAllByName0(InetAddress.java:1281)
at java.net.InetAddress.getAllByName(InetAddress.java:1193)
at java.net.InetAddress.getAllByName(InetAddress.java:1127)
at java.net.InetAddress.getByName(InetAddress.java:1077)
解决方式:
回调driver端接口的时候域名解析问题,在executor的机器上配置hosts文件,将LAPTOP-2B1EN4I2指定对应的ip地址即可
IDEA提交任务到spark standalone集群的更多相关文章
- (二)win7下用Intelij IDEA 远程调试spark standalone 集群
关于这个spark的环境搭建了好久,踩了一堆坑,今天 环境: WIN7笔记本 spark 集群(4个虚拟机搭建的) Intelij IDEA15 scala-2.10.4 java-1.7.0 版本 ...
- 04、Spark Standalone集群搭建
04.Spark Standalone集群搭建 4.1 集群概述 独立模式是Spark集群模式之一,需要在多台节点上安装spark软件包,并分别启动master节点和worker节点.master节点 ...
- spark standalone集群部署 实践记录
本文记录了一次搭建spark-standalone模式集群的过程,我准备了3个虚拟机服务器,三个centos系统的虚拟机. 环境准备: -每台上安装java1.8 -以及scala2.11.x (x代 ...
- (一) 从零开始搭建Spark Standalone集群环境搭建
本文主要讲解spark 环境的搭建 主机配置 4核8线程,主频3.4G,16G内存 虚拟环境: VMWare 虚拟环境系统:Ubuntu 14.10 虚拟机运行环境: jdk-1.7.0_79(64 ...
- linux平台 spark standalone集群 使用 start-all,stop-all 管理集群的启动和退出
一.配置/etc/profile: 文件尾部增加以下内容: export SPARK_HOME=/home/spark/spark-2.2.0-bin-hadoop2.7 export PATH=$P ...
- Standalone集群搭建和Spark应用监控
注:图片如果损坏,点击文章链接:https://www.toutiao.com/i6815920501530034696/ 承接上一篇文档<Spark词频前十的统计练习> Spark on ...
- Standalone 集群部署
Spark中调度其实是分为两个层级的,即集群层级的资源分配和任务调度,以及任务层级的任务管理.其中集群层级调度是可配置的,Spark目前提供了Local,Standalone,YARN,Mesos.任 ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(三)安装spark2.2.1
如何搭建配置centos虚拟机请参考<Kafka:ZK+Kafka+Spark Streaming集群环境搭建(一)VMW安装四台CentOS,并实现本机与它们能交互,虚拟机内部实现可以上网.& ...
- spark使用idea以client模式提交应用到standalone集群
使用idea以client方式提交代码到standalone集群非常简单. 1.首先有一个部署好且已经启动的standalone集群 --------------------------------- ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(十三)kafka+spark streaming打包好的程序提交时提示虚拟内存不足(Container is running beyond virtual memory limits. Current usage: 119.5 MB of 1 GB physical memory used; 2.2 GB of 2.1 G)
异常问题:Container is running beyond virtual memory limits. Current usage: 119.5 MB of 1 GB physical mem ...
随机推荐
- KingbaseES 全局索引是否因为DDL操作而变为Unusable ?
前言 Oracle 在对分区做DDL操作时,会使分区全局索引失效,需要加上关键字update global indexes.KingbaseES 同样支持全局索引.那么,如果对分区表进行DDL操作,那 ...
- 【Android 逆向】手动构造dex文件
public class Hello { public static void main(String[] args) { System.out.println("hello android ...
- uniapp路由守卫
项目地址:https://hhyang.cn/v2/start/quickstart.html 按照他的方法安装,创建相应的js即可,有点基础的自己捣鼓一下就可以了.我的应用场景是:没有登录痕迹- ...
- Kubernetes实践技巧:资源预留
ubernetes 的节点可以按照节点的资源容量进行调度,默认情况下 Pod 能够使用节点全部可用容量.这样就会造成一个问题,因为节点自己通常运行了不少驱动 OS 和 Kubernetes 的系统守护 ...
- 第六章:Django 综合篇 - 3:使用MySQL数据库
在实际生产环境,Django是不可能使用SQLite这种轻量级的基于文件的数据库作为生产数据库.一般较多的会选择MySQL. 下面介绍一下如何在Django中使用MySQL数据库. 一.安装MySQL ...
- docker的cmd命令详解-前后台理解
CMD 指令的格式和 RUN 相似,也是两种格式: shell 格式:CMD <命令> exec 格式:CMD ["可执行文件", "参数1", & ...
- 手把手教你玩转 Gitea|使用 Docker 安装 Gitea
使用 Docker 安装 Gitea 的过程非常简单的,堪比"一键式"安装.Gitea 安装使用系列教程将会从多种方式进行全方位的实操演示. 视频演示中使用腾讯云实验环境安装 Do ...
- python流程控制下-for、while循环补充
循环结构之for循环 实现循环结构还可以用关键字for. for关键字 我们来看这一段代码: emotions = ['smile', 'laugh', 'cry', 'angry'] for emo ...
- 超强的纯 CSS 鼠标点击拖拽效果
背景 鼠标拖拽元素移动,算是一个稍微有点点复杂的交互. 而在本文,我们就将打破常规,向大家介绍一种超强的仅仅使用纯 CSS 就能够实现的鼠标点击拖拽效果. 在之前的这篇文章中 -- 不可思议的纯 CS ...
- 驱动开发:内核枚举Minifilter微过滤驱动
Minifilter 是一种文件过滤驱动,该驱动简称为微过滤驱动,相对于传统的sfilter文件过滤驱动来说,微过滤驱动编写时更简单,其不需要考虑底层RIP如何派发且无需要考虑兼容性问题,微过滤驱动使 ...