
4.3:flume+Kafka日志采集实验
〇、目标
使用kafka和flume组合进行日志采集
拓扑结构
一、重启SSH和zk服务
打开终端,首先输入:sudo service ssh restart
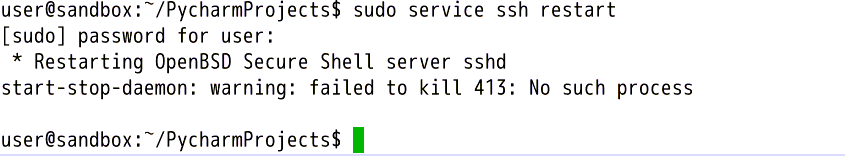
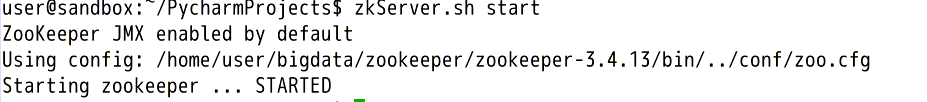
重启ssh服务。之后输入下述命令开启zookeeper服务:
zkServer.sh start
二、启动flume
输入cd /home/user/bigdata/apache-flume-1.9.0-bin
进入flume目录后输入
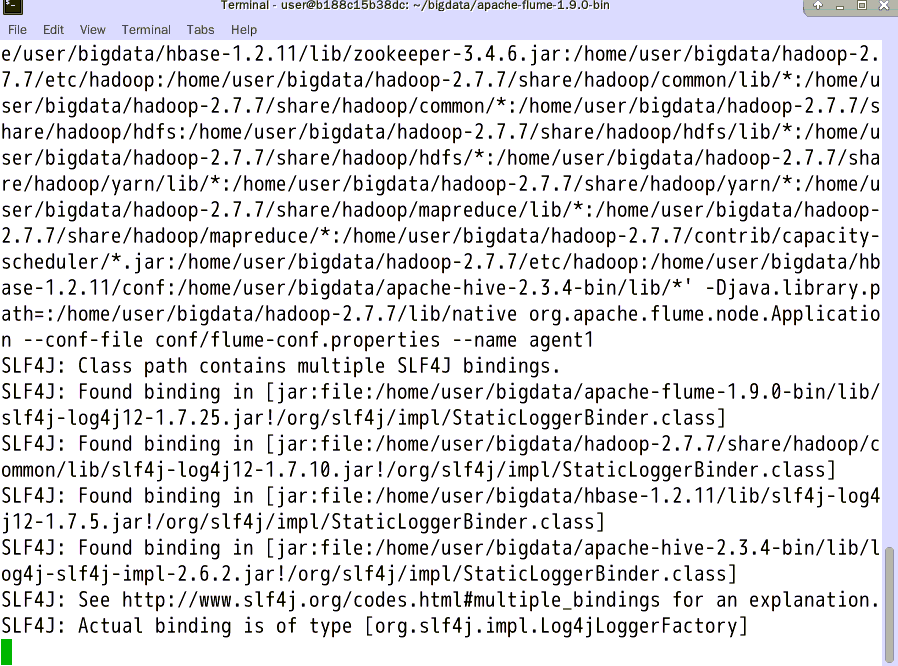
bin/flume-ng agent --conf conf --conf-file conf/flume-conf.properties --name agent1
启动flume
三、启动kafka
打开一个终端,先配置hosts再进入到kafka目录,输入:
echo "127.0.0.1 "$HOSTNAME | sudo tee -a /etc/hosts
进入kafka目录,输入
cd /home/user/bigdata/kafka_2.11-1.0.0

nohup bin/kafka-server-start.sh config/server.properties >~/bigdata/kafka_2.11-1.0.0/logs/server.log 2>&1 &
后台启动kafka。输入jps查看进程:jps
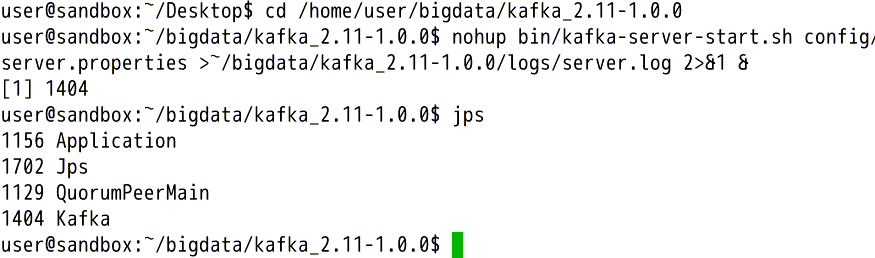
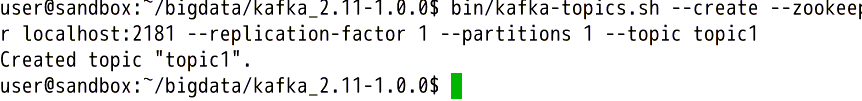
输入:bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 1 --topic topic1
创建topic
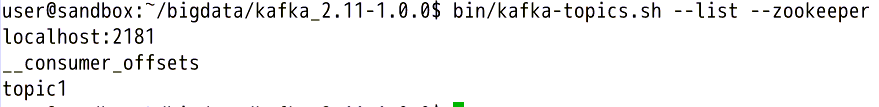
输入bin/kafka-topics.sh --list --zookeeper localhost:2181
查看已经创建好的topic
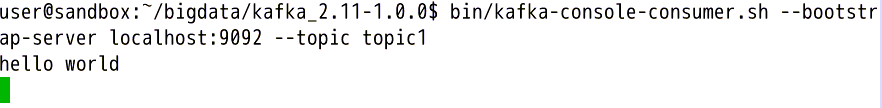
输入bin/kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic topic1
打开kafka的comsumer消费发来的信息。
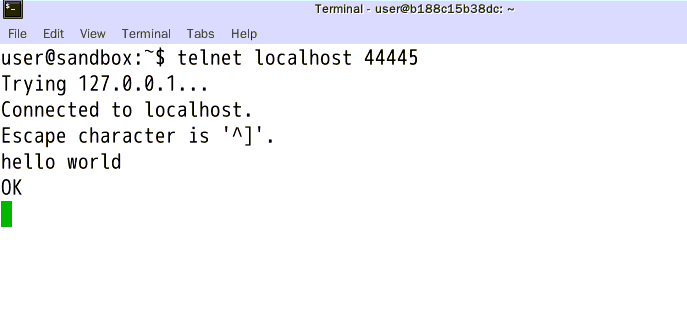
再打开第三个终端,输入:telnet localhost 44445
之后进行任意输入,会发现kafka的终端中出现了你输入的话。
4.3:flume+Kafka日志采集实验的更多相关文章
- Flume - Kafka日志平台整合
1. Flume介绍 Flume是Cloudera提供的一个高可用的,高可靠的,分布式的海量日志采集.聚合和传输的系统,Flume支持在日志系统中定制各类数据发送方,用于收集数据:同时,Flume提供 ...
- kafka+flume+HDFS日志采集项目框架
1,项目图如下: 2, 实现过程 启动HDFS: sbin/start-dfs.sh 启动zookeeper(三台): bin/zkServer.sh start 启动kafka(三台): root@ ...
- 大数据软件安装之Flume(日志采集)
一.安装地址 1) Flume官网地址 http://flume.apache.org/ 2)文档查看地址 http://flume.apache.org/FlumeUserGuide.html 3) ...
- 基于Flume+LOG4J+Kafka的日志采集架构方案
本文将会介绍如何使用 Flume.log4j.Kafka进行规范的日志采集. Flume 基本概念 Flume是一个完善.强大的日志采集工具,关于它的配置,在网上有很多现成的例子和资料,这里仅做简单说 ...
- 一次flume exec source采集日志到kafka因为单条日志数据非常大同步失败的踩坑带来的思考
本次遇到的问题描述,日志采集同步时,当单条日志(日志文件中一行日志)超过2M大小,数据无法采集同步到kafka,分析后,共踩到如下几个坑.1.flume采集时,通过shell+EXEC(tail -F ...
- 日志采集框架Flume以及Flume的安装部署(一个分布式、可靠、和高可用的海量日志采集、聚合和传输的系统)
Flume支持众多的source和sink类型,详细手册可参考官方文档,更多source和sink组件 http://flume.apache.org/FlumeUserGuide.html Flum ...
- 日志采集框架Flume
前言 在一个完整的大数据处理系统中,除了hdfs+mapreduce+hive组成分析系统的核心之外,还需要数据采集.结果数据导出.任务调度等不可或缺的辅助系统,而这些辅助工具在hadoop生态体系中 ...
- 日志采集框架 Flume
日志采集框架 Flume 1 概述 Flume是一个分布式.可靠.和高可用的海量日志采集.聚合和传输的系统. Flume可以采集文件,socket数据包等各种形式源数据,又可以将采集到的数据输出到H ...
- 基于Flume+Kafka+ Elasticsearch+Storm的海量日志实时分析平台(转)
0背景介绍 随着机器个数的增加.各种服务.各种组件的扩容.开发人员的递增,日志的运维问题是日渐尖锐.通常,日志都是存储在服务运行的本地机器上,使用脚本来管理,一般非压缩日志保留最近三天,压缩保留最近1 ...
- Flume日志采集框架的使用
文章作者:foochane 原文链接:https://foochane.cn/article/2019062701.html Flume日志采集框架 安装和部署 Flume运行机制 采集静态文件到h ...
随机推荐
- Nginx 动态压缩与静态压缩,显著提高前后端分离项目响应速度!
文章转载自:https://mp.weixin.qq.com/s/NuTmEUQU5L69is53bCauKA Nginx 中配置前端的 gzip 压缩,有两种思路: Nginx 动态压缩,静态文件还 ...
- 监控Redis集群,有两种方法
前提条件 redis集群:已搭建三主三从(三台主机) prometheus.grafana已安装 三台主机ip: 192.168.0.39,192.168.0.164,192.168.0.68 第一种 ...
- win7通过netsh命令禁用、启用本地连接 定时关闭开启网络连接
1) 先检查网络接口名称 C:\Windows\system32>netsh interface show interface 管理员状态 状态 类型 接口名称 ---------------- ...
- Elasticsearch:使用 Nginx 来保护 Elastic Stack
文章转载自:https://elasticstack.blog.csdn.net/article/details/112213364
- SonarQube 的安装、配置及 Maven 项目的使用
转载自:https://cloud.tencent.com/developer/article/1010612 1.SonarQube 介绍 SonarQube 是一个用于管理源代码质量开放平台,它可 ...
- 编写一个应用程序,在主类Test1类中,创建两个链表List<E>对象,分别存储通过键盘输入的字符串内容
题目1:编写一个应用程序,在主类Test1类中,创建两个链表List<E>对象,分别存储通过键盘输入的字符串内容--"chen","wang",&q ...
- Linux shell猜数游戏
题目:猜随机数随机1-100中的一个数字,要求用户猜数字,猜中则退出脚本并告知用户猜测次 数和随机数字,否则要求用户继续猜,并告知当前猜的数字和随机数的关系. #!/bin/bash #猜数游戏 Ra ...
- NOI2014 洛谷P2114 起床困难综合征(位运算)
呃...这道题算是noi中比较简单的题吧...... 众所周知,位运算是个好东西,它就是对应的位进行运算,跟其他的位没有关系. 我们要选取一个m值使最后的攻击力最大,对于这个m,从高位开始枚举,判断该 ...
- Netty 学习(十):ChannelPipeline源码说明
Netty 学习(十):ChannelPipeline源码说明 作者: Grey 原文地址: 博客园:Netty 学习(十):ChannelPipeline源码说明 CSDN:Netty 学习(十): ...
- 微信小程序js-时间转换函数使用
最近在做云开发博客小程序 采集微信发布的信息放入数据库会有createTime因此发现了不一样的地方 云函数可以直接使用 但是放到引导全局的app.js文件却是找不到该方法-->dateform ...