
Hadoop3.x完全分布式搭建(详细)
环境准备
- vm虚拟机(自行安装Centos7系统)
- hadoop3.x安装包(linux版本)
- java1.8安装包(linux版本)
为了能够按照教程顺利操作,需要注意几点细节
- 不要不看文字直接复制粘贴
- 操作命令的用户很重要,否则后续会引发关于权限的问题
- ftp 与 终端工具需要自己操作使用本教程不涵盖操作,如有需要,自行百度,本教程均使用终端shell工具截图,其性质与linux系统右键打开终端相同。
开始啦!
- 使用root用户登录,用一个单独的用户管理hadoop集群,所以要用管理员(root)用户创建一个名字为hadoop的用户。
[root@hadoop102 ~]# useradd hadoop
- 设置 hadoop 用户的密码
[root@hadoop102 ~]# passwd hadoop
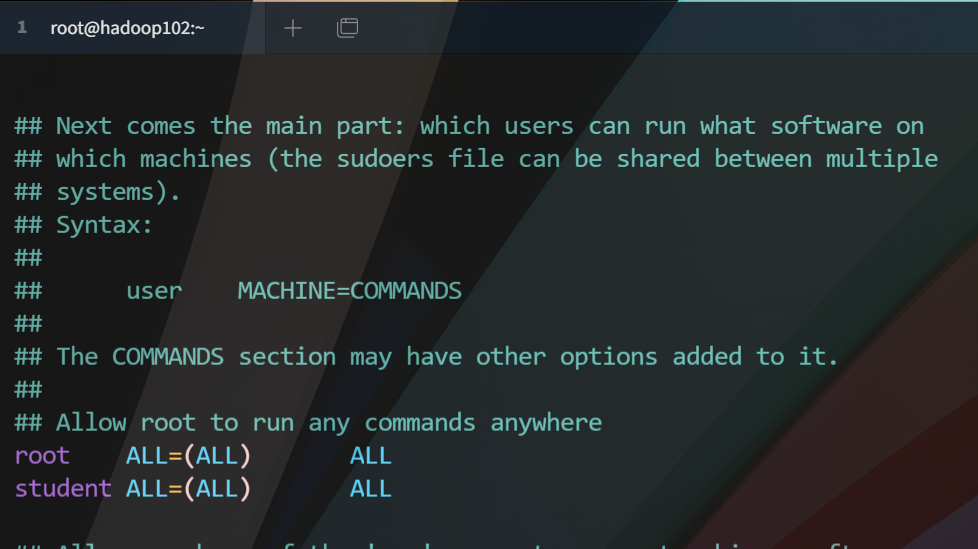
- 给 hadoop 用户提权,编辑如下路径文件
[root@hadoop102 ~]# vim /etc/sudoers
将文件此处修改为这样(在100行左右)
- 修改静态IP
[root@hadoop102 ~]# vim /etc/sysconfig/network-scripts/ifcfg-ens33
静态ip文件修改如下
TYPE="Ethernet"

PROXY_METHOD="none"

BROWSER_ONLY="no"

BOOTPROTO="static"

DEFROUTE="yes"

IPV4_FAILURE_FATAL="no"

IPV6INIT="yes"

IPV6_AUTOCONF="yes"

IPV6_DEFROUTE="yes"

IPV6_FAILURE_FATAL="no"

IPV6_ADDR_GEN_MODE="stable-privacy"

NAME="ens33"

UUID="385ea190-1b85-42cf-9df4-916f2dd86bc7"

DEVICE="ens33"

ONBOOT="yes"

#ip 写自己设置的

IPADDR=192.168.127.112

#子网掩码 固定的

NETMASK=255.255.255.0

#网关 就是将你ip最后一段改成1

GATEWAY=192.168.127.1
- 修改主机名
[root@hadoop102 ~]# vim /etc/hostname
文件内写入自己的主机名字即可
- 
- 修改主机域名映射
[root@hadoop102 ~]# vim /etc/hosts
hosts文件内容如下

关闭防火墙(运行b即可永久关闭)
一次性关闭 -- 重启之后系统会默认打开防火墙
[root@hadoop102 ~]# systemctl stop firewalld
永久关闭防火墙
[root@hadoop102 ~]# systemctl disable firewalld
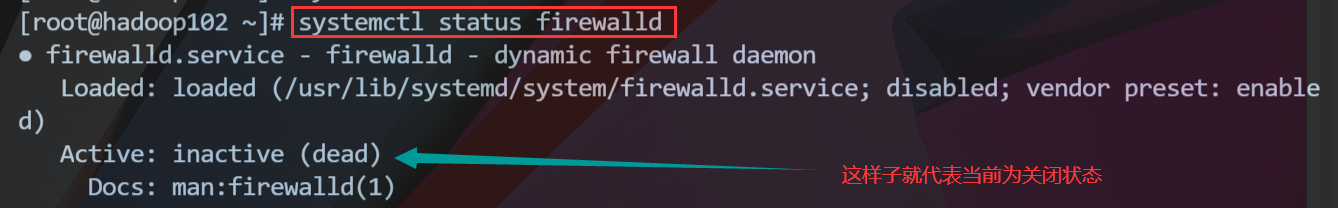
查看当前防火墙状态
[root@hadoop102 ~]# systemctl status firewalld
状态截图
重启机器,生效所有配置,注意 下次登录直接使用 hadoop 账户信息登录系统,这样子直接创建目录权限就是属于hadoop的
- 如果想要终端连接虚拟机,待重启之后即可输入ip与用户信息即可登录终端。
[root@hadoop102 ~]# reboot
创建javajdk 和 hadoop 安装所需目录
创建软件安装包存放目录
- software目录用于存放安装包
- module目录用于软件的安装目录(或者叫解压目录)
[hadoop@hadoop102 /]$ sudo mkdir /opt/software

[hadoop@hadoop102 /]$ sudo mkdir /opt/module
赋予software目录上传权限,可以看到下面的权限已经允许外部读取写入
[root@hadoop102 opt]# chmod +777 /opt/software /opt/module

[root@hadoop102 opt]# ll

总用量 12

drwxrwxrwx. 2 root root 4096 3月   9 21:56 module

drwxr-xr-x. 2 root root 4096 10月 31 2018 rh

drwxrwxrwx. 2 root root 4096 3月   9 21:56 software
上传hadoop和java安装包(本操作不涵盖,注意:使用任意的ftp工具登录连接时候请使用 hadoop 用户登录操作)
解压至module目录
[hadoop@hadoop102 software]$ tar -zxvf hadoop-3.1.3.tar.gz -C ../module/

[hadoop@hadoop102 software]$ tar -zxvf jdk-8u212-linux-x64.tar.gz -C ../module/
配置java 和 hadoop的环境变量
切换至root用户操作系统文件,操作完成之后切换成hadoop用户
[hadoop@hadoop102 software]$ su root
使用root用户修改环境变量文件,在文件末尾追加如下信息,如果你的安装路径跟我不同这里需要写你自己的,跟着教程走且是同一个版本安装包或者同一个安装文件夹名字的不需要任何修改
#java

export JAVA_HOME=/opt/module/jdk1.8.0_212

export PATH=$PATH:$JAVA_HOME/bin

#hadoop3.1.3

export HADOOP_HOME=/opt/module/hadoop-3.1.3

export PATH=$PATH:$HADOOP_HOME/bin
切换至hadoop用户,并生效配置文件,查看效果
[hadoop@hadoop102 software]$ source /etc/profile
自行运行如下命令进行环境测试,足够自行不测试也可以的。
[hadoop@hadoop102 software]$ java

[hadoop@hadoop102 software]$ javac

[hadoop@hadoop102 software]$ java -version

[hadoop@hadoop102 software]$ hadoop version
配置hadoop
编辑core-site.xml文件
[hadoop@hadoop102 /]$ vim /opt/module/hadoop-3.1.3/etc/hadoop/core-site.xml
<!-- 指定NameNode的地址 -->

<property>

	<name>fs.defaultFS</name>

	<value>hdfs://hadoop102:8020</value>

</property>

<!-- 指定hadoop数据的存储目录 -->

<property>

	<name>hadoop.tmp.dir</name>

	<value>/opt/module/hadoop-3.1.3/data</value>

</property>
编辑hdfs-site.xml文件
[hadoop@hadoop102 /]$ vim /opt/module/hadoop-3.1.3/etc/hadoop/hdfs-site.xml
<!-- nn web端访问地址-->

<property>

    <name>dfs.namenode.http-address</name>

    <value>hadoop102:9870</value>

</property>

<!-- 2nn web端访问地址-->

<property>

    <name>dfs.namenode.secondary.http-address</name>

    <value>hadoop104:9868</value>

</property>
编辑yarn-site.xml文件
[hadoop@hadoop102 /]$ vim /opt/module/hadoop-3.1.3/etc/hadoop/yarn-site.xml
<!-- 指定MR走shuffle -->

<property>

    <name>yarn.nodemanager.aux-services</name>

    <value>mapreduce_shuffle</value>

</property>

<!-- 指定ResourceManager的地址-->

<property>

    <name>yarn.resourcemanager.hostname</name>

    <value>hadoop103</value>

</property>

<!-- 环境变量的继承 -->

<property>

    <name>yarn.nodemanager.env-whitelist</name>

    <value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_MAPRED_HOME</value>

</property>
编辑mapred-site.xml文件
[hadoop@hadoop102 /]$ vim /opt/module/hadoop-3.1.3/etc/hadoop/mapred-site.xml
<!-- 指定MapReduce程序运行在Yarn上 -->

<property>

    <name>mapreduce.framework.name</name>

    <value>yarn</value>

</property>
编辑hadoop-env.sh文件
[hadoop@hadoop102 /]$ vim /opt/module/hadoop-3.1.3/etc/hadoop/hadoop-env.sh
- 文件末尾追加一行
export JAVA_HOME=/opt/module/jdk1.8.0_212
编辑workers文件
[hadoop@hadoop102 hadoop]$ vim workers
- 写入如下内容
hadoop102

hadoop103

hadoop104
到此步骤,关闭虚拟机,克隆两台,请自行百度,待克隆完成之后,开启两个克隆的机器,不要通过终端连接,然后做下面操作,在vm中进行。
三台主机都使用root用户登录
修改克隆1机器的主机名
[root@hadoop102 hadoop]# vim /etc/hostname
内容如下
hadoop103
修改克隆1的ip
[root@hadoop102 ~]# vim /etc/sysconfig/network-scripts/ifcfg-ens33
内容如下
TYPE="Ethernet"

PROXY_METHOD="none"

BROWSER_ONLY="no"

BOOTPROTO="static"

DEFROUTE="yes"

IPV4_FAILURE_FATAL="no"

IPV6INIT="yes"

IPV6_AUTOCONF="yes"

IPV6_DEFROUTE="yes"

IPV6_FAILURE_FATAL="no"

IPV6_ADDR_GEN_MODE="stable-privacy"

NAME="ens33"

UUID="385ea190-1b85-42cf-9df4-916f2dd86bc7"

DEVICE="ens33"

ONBOOT="yes"

IPADDR=192.168.127.113

NETMASK=255.255.255.0

GATEWAY=192.168.127.1
修改克隆2机器的主机名
[root@hadoop102 hadoop]# vim /etc/hostname
内容如下
hadoop104
修改克隆2机器的ip
[root@hadoop102 ~]# vim /etc/sysconfig/network-scripts/ifcfg-ens33
内容如下
TYPE="Ethernet"

PROXY_METHOD="none"

BROWSER_ONLY="no"

BOOTPROTO="static"

DEFROUTE="yes"

IPV4_FAILURE_FATAL="no"

IPV6INIT="yes"

IPV6_AUTOCONF="yes"

IPV6_DEFROUTE="yes"

IPV6_FAILURE_FATAL="no"

IPV6_ADDR_GEN_MODE="stable-privacy"

NAME="ens33"

UUID="385ea190-1b85-42cf-9df4-916f2dd86bc7"

DEVICE="ens33"

ONBOOT="yes"

IPADDR=192.168.127.114

NETMASK=255.255.255.0

GATEWAY=192.168.127.1
重启两台克隆机器,使配置重新加载生效。
[root@hadoop102 ~]#reboot
配置免密登录
hadoop102生成免密并发送给其余两个节点(hadoop102,hadoop103,hadoop104)
[hadoop@hadoop102 .ssh]$ ssh-keygen -t rsa

[hadoop@hadoop104 .ssh]$ ssh-copy-id hadoop102

[hadoop@hadoop102 .ssh]$ ssh-copy-id hadoop103

[hadoop@hadoop102 .ssh]$ ssh-copy-id hadoop104
hadoop103生成免密并发送给其余两个节点(hadoop102,hadoop103,hadoop104)
[hadoop@hadoop103 .ssh]$ ssh-keygen -t rsa

[hadoop@hadoop103 .ssh]$ ssh-copy-id hadoop102

[hadoop@hadoop104 .ssh]$ ssh-copy-id hadoop103

[hadoop@hadoop103 .ssh]$ ssh-copy-id hadoop104
hadoop104生成免密并发送给其余两个节点(hadoop102,hadoop104,hadoop103)
[hadoop@hadoop104 .ssh]$ ssh-keygen -t rsa

[hadoop@hadoop104 .ssh]$ ssh-copy-id hadoop102

[hadoop@hadoop104 .ssh]$ ssh-copy-id hadoop103

[hadoop@hadoop104 .ssh]$ ssh-copy-id hadoop104
格式化(必须主节点操作,既hadoop102这个节点)
[hadoop@hadoop102 sbin]$ hdfs namenode -format
然后可以通过如下文本查看对应的信息
192.168.127.112:9870  --访问hadoop集群前台页面

192.168.127.113:8088  --访问hadoop的所有应用页面

还可以通过各个节点jps命令查看启动的任务节点状态。
Hadoop3.x完全分布式搭建(详细)的更多相关文章
- VM上Hadoop3.1伪分布式模式搭建
https://www.cnblogs.com/asker009/p/9126354.html 最近要搭建一个Hadoop做实验,因为版本的问题遇到不少的坑,本文记录VM上搭建的CentOS7.0+H ...
- hadoop3自学入门笔记(2)—— HDFS分布式搭建
一些介绍 Hadoop 2和Hadoop 3的端口区别 Hadoop 3 HDFS集群架构 我的集群规划 name ip role 61 192.168.3.61 namenode,datanode ...
- Centos7完全分布式搭建Hadoop2.7.3
(一)软件准备 1,hadoop-2.7.3.tar.gz(包) 2,三台机器装有cetos7的机子 (二)安装步骤 1,给每台机子配相同的用户 进入root : su root ---------& ...
- Solr集群搭建详细教程(一)
一.Solr集群的系统架构 注:欢迎大家转载,非商业用途请在醒目位置注明本文链接和作者名dijia478,商业用途请联系本人dijia478@163.com. SolrCloud(solr 云)是So ...
- 3.hadoop完全分布式搭建
3.Hadoop完全分布式搭建 1.完全分布式搭建 配置 #cd /soft/hadoop/etc/ #mv hadoop local #cp -r local full #ln -s full ha ...
- 2.hadoop基本配置,本地模式,伪分布式搭建
2. Hadoop三种集群方式 1. 三种集群方式 本地模式 hdfs dfs -ls / 不需要启动任何进程 伪分布式 所有进程跑在一个机器上 完全分布式 每个机器运行不同的进程 2. 服务器基本配 ...
- hadoop2.8 集群 1 (伪分布式搭建)
简介: 关于完整分布式请参考: hadoop2.8 ha 集群搭建 [七台机器的集群] Hadoop:(hadoop2.8) Hadoop是一个由Apache基金会所开发的分布式系统基础架构.用户 ...
- Solr集群搭建详细教程(二)
注:欢迎大家转载,非商业用途请在醒目位置注明本文链接和作者名dijia478,商业用途请联系本人dijia478@163.com. 之前步骤:Solr集群搭建详细教程(一) 三.solr集群搭建 注意 ...
- hadoop分布式搭建
1.新建三台机器,分别为: hadoop分布式搭建至少需要三台机器: master extension1 extension2 本文利用在VMware Workstation下安装Linux cent ...
随机推荐
- 斯坦福 CS183 & YC 创业课系列中文笔记
欢迎任何人参与和完善:一个人可以走的很快,但是一群人却可以走的更远. 在线阅读 ApacheCN 面试求职交流群 724187166 ApacheCN 学习资源 目录 Zero to One 从0到1 ...
- STC8H开发(九): STC8H8K64U模拟USB HID外设
目录 STC8H开发(一): 在Keil5中配置和使用FwLib_STC8封装库(图文详解) STC8H开发(二): 在Linux VSCode中配置和使用FwLib_STC8封装库(图文详解) ST ...
- bom-offset
<!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8&quo ...
- js 计算中英文混合字符串长度
转载请注明来源:https://www.cnblogs.com/hookjc/ function isChinese(str) { var lst = /[u00-uFF]/; ...
- 自定义UITableview自带侧滑删除按钮样式 by 徐
效果如下: 实现原理: 1.打开tableview自带的侧滑删除功能 核心代码: 1 -(void)tableView:(UITableView *)tableView commitEditingSt ...
- iOS - TableViewCell分割线 --By吴帮雷
千万别小看UI中得线,否则你的设计师和测试组会无休止地来找你的!!(如果是美女还好,如果是恐龙....) 在开发中运用最多的是什么,对,表格--TableView,之所以称作表格,是因为他天生带有分割 ...
- Kubernetes(K8s)基础概念 —— 凿壁偷光
Kubernetes(K8s)基础概念 -- 凿壁偷光 K8s是什么:全称 kubernetes (k12345678s) 作用:用于自动部署,扩展和管理"容器化应用程序"的 ...
- xshell脚本之条件语句
xshell脚本之条件语句 1.test命令: 如果test命令中列出的条件成立,test命令就会退出并返回状态码0, 如果条件不成立,test命令就会退出并返回非零的退出状态码,这使得if-then ...
- PyTorch深度学习入门笔记(一)PyTorch环境配置及安装
@ 目录 一.工具安装 1.1 Anaconda 安装 1.2 Pytorch安装 二.编辑器安装 2.1 Pycharm安装 2.2 Jupyter安装 OS: ubuntu 20.04(虚拟机) ...
- Mybatis第三方PageHelper分页插件原理
欢迎关注公号:BiggerBoy,看更多文章 原文链接:https://mp.weixin.qq.com/s?__biz=MzUxNTQyOTIxNA==&mid=2247485158&a ...