
CNN-4: GoogLeNet 卷积神经网络模型
1、GoogLeNet 模型简介
GoogLeNet 是2014年Christian Szegedy提出的一种全新的深度学习结构,该模型获得了ImageNet挑战赛的冠军。
2、GoogLeNet 模型的提出
1)在这之前的AlexNet、VGG等结构都是通过增大网络的深度(层数)来获得更好的训练效果,但层数的增加会带来很
多负作用,比如过拟合、梯度消失、梯度爆炸等。
2)解决这些问题的方法当然就是在增加网络深度和宽度的同时减少参数,为了减少参数,自然就想到将全连接变成稀疏
连接。但是在实现上,全连接变成稀疏连接后实际计算量并不会有质的提升,因为大部分硬件是针对密集矩阵计算优化的,
稀疏矩阵虽然数据量少,但是计算所消耗的时间却很难减少。
3)那么,有没有一种方法既能保持网络结构的稀疏性,又能利用密集矩阵的高计算性能。大量的文献表明可以将稀疏矩阵
聚类为较为密集的子矩阵来提高计算性能,就如人类的大脑是可以看做是神经元的重复堆积,因此,GoogLeNet团队提出了
Inception网络结构,就是构造一种“基础神经元”结构,来搭建一个稀疏性、高计算性能的网络结构。
3、Inception 模块结构
Inception模块的提出是从另一种角度来提升训练结果,其能更高效的利用计算资源,在相同的计算量下能提取到更多的特征,
从而提升训练结果。
Inception历经了V1、V2、V3、V4等多个版本的发展,不断趋于完善。
1) Inception V1
通过设计一个稀疏网络结构,但是能够产生稠密的数据,既能增加神经网络表现,又能保证计算资源的使用效率。
谷歌提出了最原始Inception的基本结构:
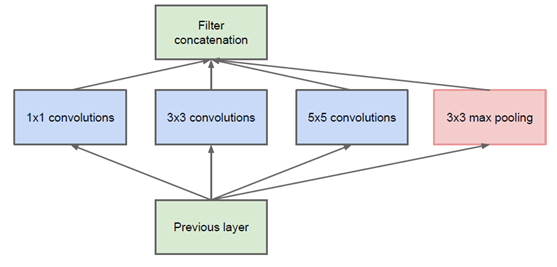
该结构将CNN中常用的卷积(1x1,3x3,5x5)、池化操作(3x3)堆叠在一起(卷积、池化后的尺寸相同,将通道相加),
一方面增加了网络的宽度,另一方面也增加了网络对尺度的适应性。
网络卷积层中的网络能够提取输入的每一个细节信息,同时5x5的滤波器也能够覆盖大部分接受层的的输入。还可以进行
一个池化操作,以减少空间大小,降低过度拟合。在这些层之上,在每一个卷积层后都要做一个ReLU操作,以增加网络
的非线性特征。
然而这个Inception原始版本,所有的卷积核都在上一层的所有输出上来做,而那个5x5的卷积核所需的计算量就太大了,
造成了特征图的厚度很大,为了避免这种情况,在3x3前、5x5前、max pooling后分别加上了1x1的卷积核,以起到了降低
特征图厚度的作用,这也就形成了Inception v1的网络结构,如下图所示:
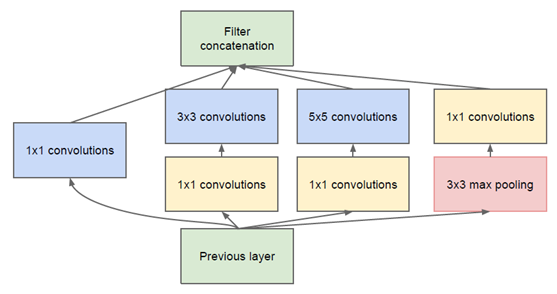
1x1的卷积核的作用:
1x1卷积的主要目的是为了减少维度,还用于修正线性激活(ReLU)。比如,上一层的输出为100x100x128,经过具有
256个通道的5x5卷积层之后(stride=1,pad=2),输出数据为100x100x256,其中,卷积层的参数为128x5x5x256= 819200。
而假如上一层输出先经过具有32个通道的1x1卷积层,再经过具有256个输出的5x5卷积层,那么输出数据仍为为100x100x256,
但卷积参数量已经减少为128x1x1x32 + 32x5x5x256= 204800,大约减少了4倍。
基于Inception构建了GoogLeNet的网络结构如下(共22层):
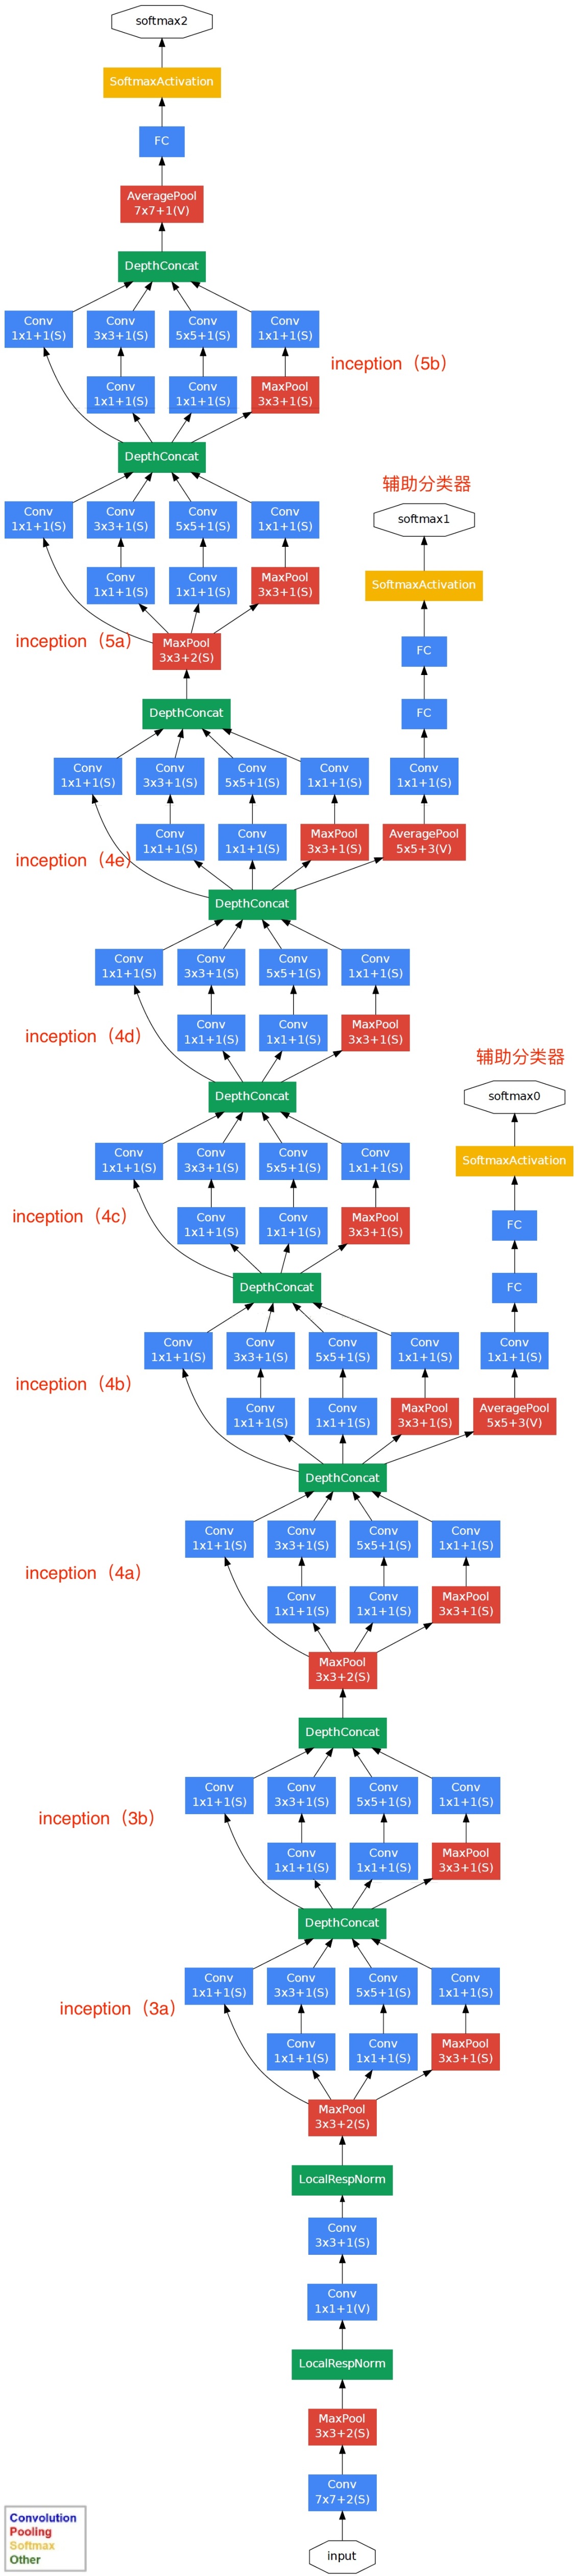
对上图说明如下:
(1)GoogLeNet采用了模块化的结构(Inception结构),方便增添和修改;
(2)网络最后采用了average pooling(平均池化)来代替全连接层,该想法来自NIN(Network in Network),
事实证明这样可以将准确率提高0.6%。但是,实际在最后还是加了一个全连接层,主要是为了方便对输出进行灵活调整;
(3)虽然移除了全连接,但是网络中依然使用了Dropout ;
(4)为了避免梯度消失,网络额外增加了2个辅助的softmax用于向前传导梯度(辅助分类器)。辅助分类器是将中间
某一层的输出用作分类,并按一个较小的权重(0.3)加到最终分类结果中,这样相当于做了模型融合,同时给网络
增加了反向传播的梯度信号,也提供了额外的正则化,对于整个网络的训练很有裨益。而在实际测试的时候,这两个
额外的softmax会被去掉。
GoogLeNet的网络结构图细节如下:
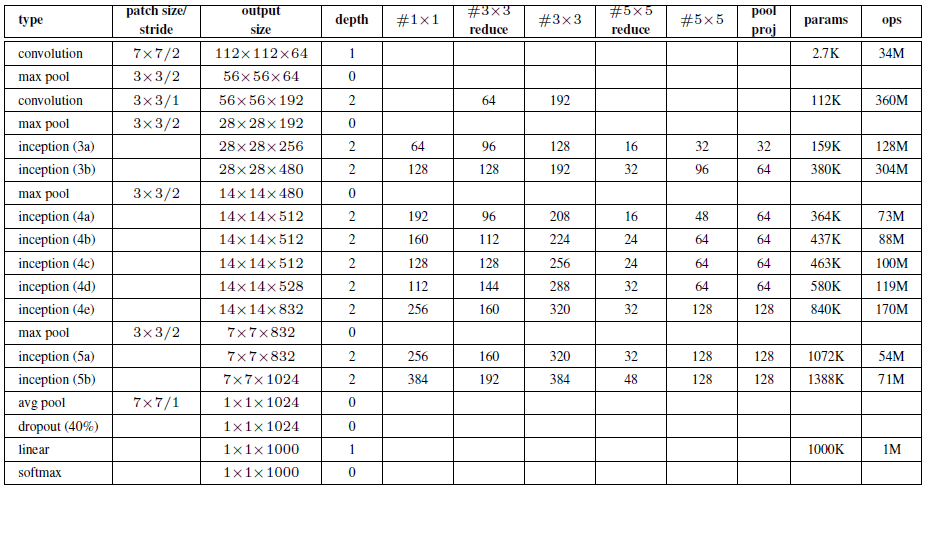
注:上表中的“#3x3 reduce”,“#5x5 reduce”表示在3x3,5x5卷积操作之前使用了1x1卷积的数量。
GoogLeNet网络结构明细表解析如下:
0、输入
原始输入图像为224x224x3,且都进行了零均值化的预处理操作(图像每个像素减去均值)。
1、第一层(卷积层)
使用7x7的卷积核(滑动步长2,padding为3),64通道,输出为112x112x64,卷积后进行ReLU操作
经过3x3的max pooling(步长为2),输出为((112 - 3+1)/2)+1=56,即56x56x64,再进行ReLU操作
2、第二层(卷积层)
使用3x3的卷积核(滑动步长为1,padding为1),192通道,输出为56x56x192,卷积后进行ReLU操作
经过3x3的max pooling(步长为2),输出为((56 - 3+1)/2)+1=28,即28x28x192,再进行ReLU操作
3a、第三层(Inception 3a层)
分为四个分支,采用不同尺度的卷积核来进行处理
(1)64个1x1的卷积核,然后RuLU,输出28x28x64;
(2)96个1x1的卷积核,作为3x3卷积核之前的降维,变成28x28x96,然后进行ReLU计算,再进行
128个3x3的卷积(padding为1),输出28x28x128;
(3)16个1x1的卷积核,作为5x5卷积核之前的降维,变成28x28x16,进行ReLU计算后,再进行32个
5x5的卷积(padding为2),输出28x28x32;
(4)pool层,使用3x3的核(padding为1),输出28x28x192,然后进行32个1x1的卷积,输出28x28x32。
将四个结果进行连接,对这四部分输出结果的第三维并联,即64+128+32+32=256,最终输出28x28x256。
3b、第三层(Inception 3b层)
(1)128个1x1的卷积核,然后RuLU,输出28x28x128
(2)128个1x1的卷积核,作为3x3卷积核之前的降维,变成28x28x128,进行ReLU,再进行192个3x3的
卷积(padding为1),输出28x28x192;
(3)32个1x1的卷积核,作为5x5卷积核之前的降维,变成28x28x32,进行ReLU计算后,再进行96个5x5
的卷积(padding为2),输出28x28x96;
(4)pool层,使用3x3的核(padding为1),输出28x28x256,然后进行64个1x1的卷积,输出28x28x64。
将四个结果进行连接,对这四部分输出结果的第三维并联,即128+192+96+64=480,最终输出输出为28x28x480
第四层(4a,4b,4c,4d,4e)、第五层(5a,5b)……,与3a、3b类似,在此就不再重复。
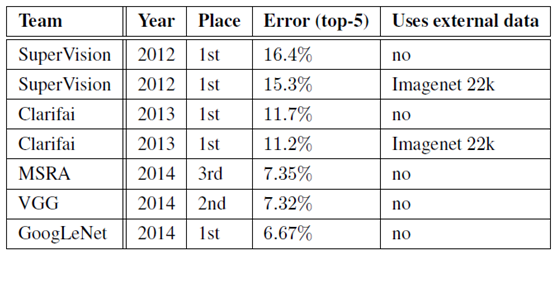
从GoogLeNet的实验结果来看,效果很明显,差错率比MSRA、VGG等模型都要低,对比结果如下表所示:
2) Inception V2
GoogLeNet凭借其优秀的表现,得到了很多研究人员的学习和使用,因此GoogLeNet团队又对其进行了
进一步地发掘改进,产生了升级版本的GoogLeNet。
GoogLeNet设计的初衷就是要又准又快,而如果只是单纯的堆叠网络虽然可以提高准确率,但是会导致
计算效率有明显的下降,所以如何在不增加过多计算量的同时提高网络的表达能力就成为了一个问题。
Inception V2版本的解决方案就是修改Inception的内部计算逻辑,提出了比较特殊的“卷积”计算结构。
1、卷积分解(Factorizing Convolutions)
大尺寸的卷积核可以带来更大的感受野,但也意味着会产生更多的参数,比如5x5卷积核的参数有25个,
3x3卷积核的参数有9个,前者是后者的25/9=2.78倍。因此,GoogLeNet团队提出可以用2个连续的3x3
卷积层组成的小网络来代替单个的5x5卷积层,即在保持感受野范围的同时又减少了参数量,
如下图:
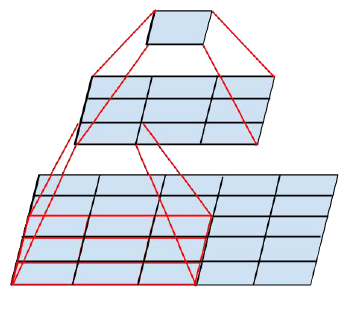
那么这种替代方案会造成表达能力的下降吗?通过大量实验表明,并不会造成表达缺失。
可以看出,大卷积核完全可以由一系列的3x3卷积核来替代,那能不能再分解得更小一点呢?GoogLeNet团队考虑了nx1的卷积核,如下图所示,用3个3x1取代3x3卷积: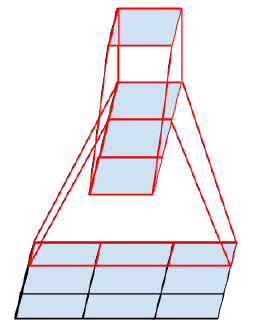
因此,任意nxn的卷积都可以通过1xn卷积后接nx1卷积来替代。GoogLeNet团队发现在网络的前期使用
这种分解效果并不好,在中度大小的特征图(feature map)上使用效果才会更好(特征图大小建议在12到20之间)。

2、降低特征图大小
一般情况下,如果想让图像缩小,可以有如下两种方式:
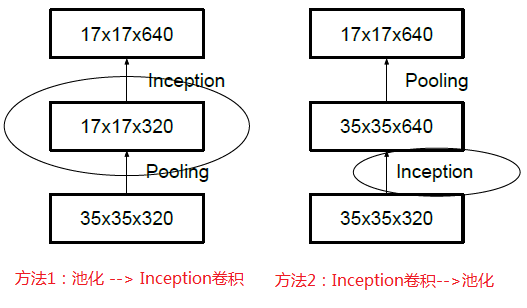
先池化再作Inception卷积,或者先作Inception卷积再作池化。但是方法一(左图)先作pooling(池化)
会导致特征表示遇到瓶颈(特征缺失),方法二(右图)是正常的缩小,但计算量很大。为了同时保持特征表示
且降低计算量,将网络结构改为下图,使用两个并行化的模块来降低计算量(卷积、池化并行执行,再进行合并)
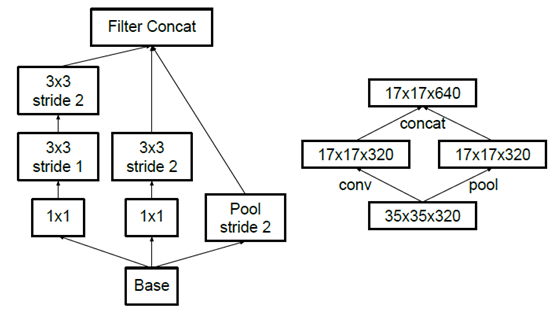
使用Inception V2作改进版的GoogLeNet,网络结构图如下:

注:上表中的Figure 5指没有进化的Inception,Figure 6是指小卷积版的Inception(用3x3卷积核代替5x5卷积核),
Figure 7是指不对称版的Inception(用1xn、nx1卷积核代替nxn卷积核)。
经实验,模型结果与旧的GoogleNet相比有较大提升,如下表所示:

3)Inception V3
Inception V3一个最重要的改进是分解(Factorization),将7x7分解成两个一维的卷积(1x7,7x1),
3x3也是一样(1x3,3x1),这样的好处,既可以加速计算,又可以将1个卷积拆成2个卷积,使得网络
深度进一步增加,增加了网络的非线性(每增加一层都要进行ReLU)。另外,网络输入从224x224变为了299x299。
4)Inception V4
Inception V4研究了Inception模块与残差连接的结合。ResNet结构大大地加深了网络深度,还极大地提升了
训练速度,同时性能也有提升(ResNet的技术原理介绍见本博客之前的文章:大话深度残差网络ResNet)。
Inception V4主要利用残差连接(Residual Connection)来改进V3结构,得到Inception-ResNet-v1,
Inception-ResNet-v2,Inception-v4网络。
ResNet的残差结构如下:
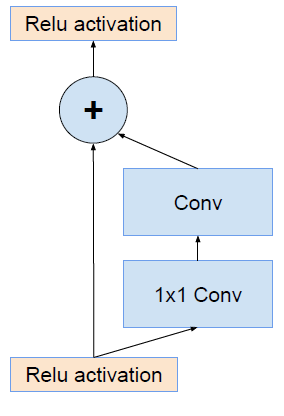
将该结构与Inception相结合,变成下图:

通过20个类似的模块组合,Inception-ResNet构建如下:
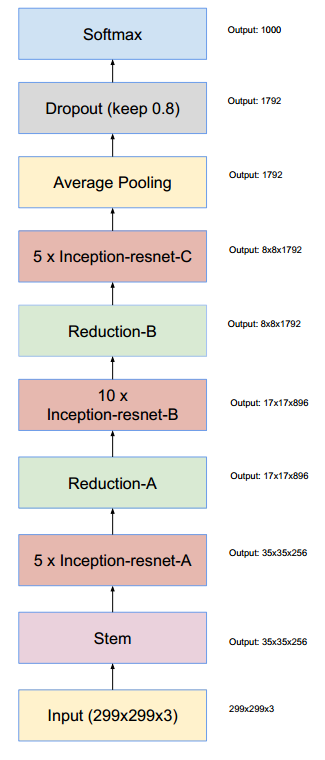
参考文献
[1] 大话CNN经典模型:GoogLeNet(从Inception v1到v4的演进)
[2] Szegedy C , Liu W , Jia Y , et al. Going Deeper with Convolutions[J]. 2014.
[3] Ioffe S , Szegedy C . Batch normalization: accelerating deep network training by reducing internal covariate shift[C]// International Conference on International Conference on Machine Learning (ICML), 2015.
[4] Szegedy C , Vanhoucke V , Ioffe S , et al. Rethinking the Inception Architecture for Computer Vision[C]// IEEE Conference on Computer Vision and Pattern Recognition (CVPR) ,2016.
[5] Szegedy C , Ioffe S , Vanhoucke V , et al. Inception-v4, Inception-ResNet and the Impact of Residual Connections on Learning[J]. 2016.
CNN-4: GoogLeNet 卷积神经网络模型的更多相关文章
- 利用Tensorflow实现卷积神经网络模型
首先看一下卷积神经网络模型,如下图: 卷积神经网络(CNN)由输入层.卷积层.激活函数.池化层.全连接层组成,即INPUT-CONV-RELU-POOL-FC池化层:为了减少运算量和数据维度而设置的一 ...
- 使用PyTorch简单实现卷积神经网络模型
这里我们会用 Python 实现三个简单的卷积神经网络模型:LeNet .AlexNet .VGGNet,首先我们需要了解三大基础数据集:MNIST 数据集.Cifar 数据集和 ImageNet 数 ...
- 手写数字识别 ----卷积神经网络模型官方案例注释(基于Tensorflow,Python)
# 手写数字识别 ----卷积神经网络模型 import os import tensorflow as tf #部分注释来源于 # http://www.cnblogs.com/rgvb178/p/ ...
- CNN-1: LeNet-5 卷积神经网络模型
1.LeNet-5模型简介 LeNet-5 模型是 Yann LeCun 教授于 1998 年在论文 Gradient-based learning applied to document ...
- 【TensorFlow/简单网络】MNIST数据集-softmax、全连接神经网络,卷积神经网络模型
初学tensorflow,参考了以下几篇博客: soft模型 tensorflow构建全连接神经网络 tensorflow构建卷积神经网络 tensorflow构建卷积神经网络 tensorflow构 ...
- CNN-2: AlexNet 卷积神经网络模型
1.AlexNet 模型简介 由于受到计算机性能的影响,虽然LeNet在图像分类中取得了较好的成绩,但是并没有引起很多的关注. 知道2012年,Alex等人提出的AlexNet网络在ImageNet大 ...
- caffe中LetNet-5卷积神经网络模型文件lenet.prototxt理解
caffe在 .\examples\mnist文件夹下有一个 lenet.prototxt文件,这个文件定义了一个广义的LetNet-5模型,对这个模型文件逐段分解一下. name: "Le ...
- CNN-3: VGGNet 卷积神经网络模型
1.VGGNet 模型简介 VGG Net由牛津大学的视觉几何组(Visual Geometry Group)和 Google DeepMind公司的研究员一起研发的的深度卷积神经网络,在 ILSVR ...
- 吴裕雄--天生自然python Google深度学习框架:经典卷积神经网络模型
import tensorflow as tf INPUT_NODE = 784 OUTPUT_NODE = 10 IMAGE_SIZE = 28 NUM_CHANNELS = 1 NUM_LABEL ...
随机推荐
- 关于 requestAnimationFrame 小结
一.小谈 requestAnimationFrame: 说起 requestAnimationFrame,我们先看幅图: 相当一部分的浏览器的显示频率是16.7ms, 就是上图第一行的节奏,表现就是“ ...
- TensorFlow(九):卷积神经网络
一:传统神经网络存在的问题 权值太多,计算量太大 权值太多,需要大量样本进行训练 二:卷积神经网络(CNN) CNN通过感受野和权值共享减少了神经网络需要训练的参数个数. 三:池化 四:卷积操作 五: ...
- Linux find,grep 命令
使用实验楼Linux环境开发,部分内容有所参考,link:https://www.shiyanlou.com/ 概述: find: 在目录中搜索文件,它的使用权限是所有用户 命令格式: find [路 ...
- Spring Cloud Gateway(十):网关过滤器工厂 GatewayFilterFactory
本文基于 spring cloud gateway 2.0.1 1.GatewayFilterFactory 简介 路由过滤器允许以某种方式修改传入的HTTP请求或传出的HTTP响应. 路径过滤器的范 ...
- MapReduce 基本优化相关参数
MapReduce优化优化(1)资源相关参数:以下参数是在自己的 MapReduce 应用程序中配置就可以生效 mapreduce.map.memory.mb: 一个 Map Task 可使用的内存上 ...
- Js 之cookie插件(jquery.cookie.js)
一.代码 (function (factory) { if (typeof define === 'function' && define.amd) { // AMD define([ ...
- java集合——Map
声明:以下内容都是来自网络总结,将会参考很多,没有声明转载来源. 一.Map接口 1.HashMap HashMap和HashTable的区别:http://blog.csdn.net/shohoku ...
- libcurl在mac上编译
wget http://ftp.gnu.org/gnu/m4/m4-1.4.17.tar.gz wget http://ftp.gnu.org/gnu/autoconf/autoconf-2.69.t ...
- AtomicInteger的CAS算法浅析
之前浅析过自旋锁(自旋锁浅析),我们知道它的实现原理就是CAS算法.CAS(Compare and Swap)即比较并交换,作为著名的无锁算法,它也是乐观锁的实现方式之一.JDK并发包里也有许多代码中 ...
- 阶段5 3.微服务项目【学成在线】_day18 用户授权_04-方法授权-方法授权实现
2.3 方法授权实现 2.3.1资源服务添加授权控制 1.要想在资源服务使用方法授权,首先在资源服务配置授权控制 1)添加spring-cloud-starter-oauth2依赖. 2)拷贝授权配置 ...