
Hadoop之HDFS介绍
1. 概述
- HDFS是一种分布式文件管理系统。
- HDFS的使用场景:
- 适合一次写入,多次读出的场景,且不支持文件的修改;
- 适合用来做数据分析,并不适合用来做网盘应用;
1.2 优缺点
- 优点:
- 高容错性
- 适合处理大数据
- 缺点:
- 不适合**低延时*数据访问;
- 无法高效的对大量小文件进行存储;
- 不支持并发写入,文件随机修改:
- 一个文件只能有一个写,不允许多个线程同时写;
- 仅支持数据append(追加),不支持文件的随机修改。
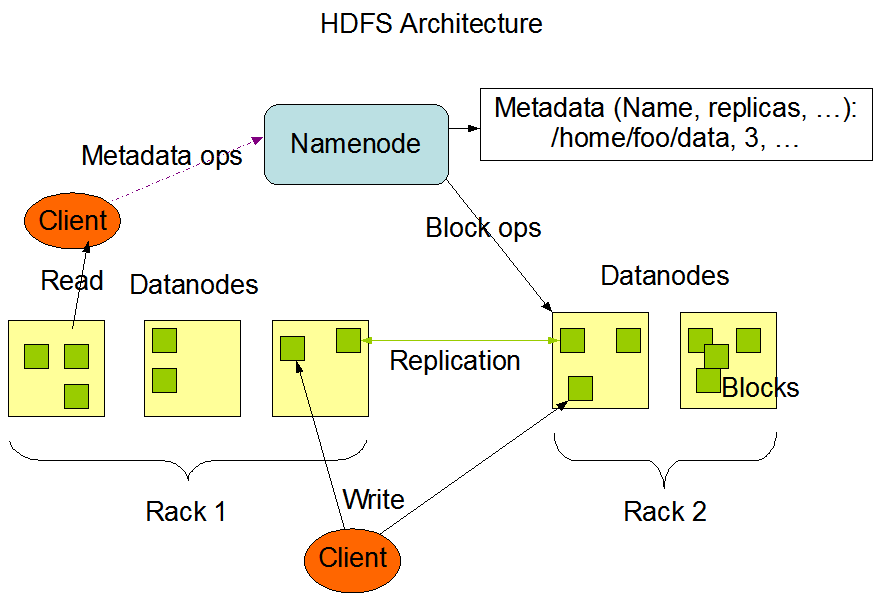
1.3 HDFS 组成架构
- NameNode(nn):
- 管理HDFS的名称空间;
- 配置副本策略;
- 管理数据块(Block)映射信息;
- 处理客户端读写请求;
- DataNode:NameNode下达命令,DataNode执行实际操作;
- 存储实际的数据块;
- 执行数据块的读/写操作;
- Client: 客户端
- 文件切分:文件上传到HDFS时,Client将文件切分成一个一个的Block,然后进行上传;
- 与NameNode交互,获取文件的位置信息;
- 与DataNode交互,读取或者写入数据;
- Client提供一些命令来管理HDFS,比如NameNode格式化;
- Client可以通过一些命令来访问HDFS,例如对HDFS进行增删改查操作;
- Secondary NameNode:并非NameNode的热备。当NameNode挂掉后,它并不能马上替换NameNode并提供服务;
- 辅助NameNode,分担其工作量,比如定期合并Fsimage和Edits,并推送给NameNode;
- 在紧急情况下,可辅助恢复NameNode;
1.4 HDFS 文件块大小
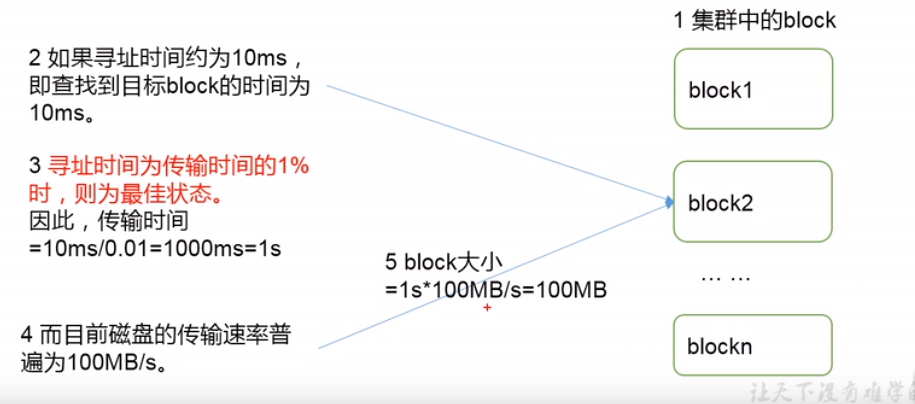
- HDFS中的文件在物理上是分块存储(Block),块的大小可以通过配置参数(dfs.blocksize)来规定
- 默认大小在Hadoop2.x版本是128M,老版本是64M;
- HDFS块的大小设置主要取决于磁盘传输速率。
2. HDFS的 Shell 操作
2.1 基本语法
bin/hadoop fs 基本命令bin/hadoop fs -getmerge /测试目录/* ./本地目录指定文件名.txt: 合并下载多个文件bin/hadoop fs -du -s -h /测试目录: 统计当前文件夹总的大小;bin/hadoop fs -du -h /测试目录: 统计当前文件夹各项的大小;
bin/hdfs dfs 基本命令: “dfs”是“fs”的实现类。
参考资料:
Hadoop之HDFS介绍的更多相关文章
- hadoop(一HDFS)
hadoop(一HDFS) 介绍 狭义上来说: hadoop指的是以下的三大系统: HDFS :分布式文件系统(高吞吐,没有延时要求,容错性,扩展能力) MapReduce : 分布式计算系统 Yar ...
- Hadoop基础-Hdfs各个组件的运行原理介绍
Hadoop基础-Hdfs各个组件的运行原理介绍 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.NameNode工作原理(默认端口号:50070) 1>.什么是NameN ...
- Hadoop介绍-3.HDFS介绍和YARN原理介绍
一. HDFS介绍: Hadoop2介绍 HDFS概述 HDFS读写流程 1. Hadoop2介绍 Hadoop是Apache软件基金会旗下的一个分布式系统基础架构.Hadoop2的框架最核心的 ...
- 介绍hadoop中的hadoop和hdfs命令
有些hive安装文档提到了hdfs dfs -mkdir ,也就是说hdfs也是可以用的,但在2.8.0中已经不那么处理了,之所以还可以使用,是为了向下兼容. 本文简要介绍一下有关的命令,以便对had ...
- Hadoop之HDFS文件操作常有两种方式(转载)
摘要:Hadoop之HDFS文件操作常有两种方式,命令行方式和JavaAPI方式.本文介绍如何利用这两种方式对HDFS文件进行操作. 关键词:HDFS文件 命令行 Java API HD ...
- Hadoop之HDFS原理及文件上传下载源码分析(下)
上篇Hadoop之HDFS原理及文件上传下载源码分析(上)楼主主要介绍了hdfs原理及FileSystem的初始化源码解析, Client如何与NameNode建立RPC通信.本篇将继续介绍hdfs文 ...
- Hadoop之HDFS及NameNode单点故障解决方案
Hadoop之HDFS 版权声明:本文为yunshuxueyuan原创文章.如需转载请标明出处: http://www.cnblogs.com/sxt-zkys/QQ技术交流群:299142667 H ...
- Hadoop基础-HDFS的读取与写入过程剖析
Hadoop基础-HDFS的读取与写入过程剖析 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 本篇博客会简要介绍hadoop的写入过程,并不会设计到源码,我会用图和文字来描述hdf ...
- Hadoop日记Day5---HDFS介绍
一.HDFS介绍 1.1 背景 随着数据量越来越大,在一个操作系统管辖的范围存不下了,那么就分配到更多的操作系统管理的磁盘中,但是不方便管理和维护,迫切需要一种系统来管理多台机器上的文件,这就是分布式 ...
随机推荐
- jQuery.each(object, [callback])
jQuery.each(object, [callback]) 概述 通用遍历方法,可用于遍历对象和数组.大理石平台检定规程 不同于遍历 jQuery 对象的 $().each() 方法,此方法可用于 ...
- java+批量下载文件到指定文件夹
需求 导出文件后存留在了服务器中,需要提供下载按钮,点击后可下载到本地:(因为涉及多个文件,下载前先将文件进行压缩,提供下载压缩文件) 效果预览 代码 主要方法 /** * 下载生成的所有在线 ...
- vue中mixin的理解与用法
vue中提供了一种混合机制--mixins,用来更高效的实现组件内容的复用.最开始我一度认为这个和组件好像没啥区别..后来发现错了.下面我们来看看mixins和普通情况下引入组件有什么区别? 组件在引 ...
- Dubbo——基础
一.分布式基础理论 1.1 什么是分布式系统? “分布式系统是若干独立计算机的集合,这些计算机对于用户来说就像单个相关系统” 分布式系统(distributed system)是建立在网络之上的软件系 ...
- POJ 1051 Jury Compromise ——(暴力DP)
题目不难,暴力地dp一下就好,但是不知道我WA在哪里了,对拍了好多的数据都没找出错误= =.估计又是哪里小细节写错了QAQ..思路是用dp[i][j]表示已经选了i个,差值为j的最大和.转移的话暴力枚 ...
- Eclipse生成EXE文件(可视化Login/读取文件)
Java Swing实现文件的简单读取 WindowBuilder的安装与使用 如何采用java设置一个登陆界面 package jp.services.slink2.batch.so2or; imp ...
- PyTricks-How to Sort a Python dict
字典的键值排序 import operator # 1表示按照值排序 xs = {"a": 4, "b": 3, "c": 2, " ...
- CISCO实验记录八:ACL访问控制
1.使用ACL实现免ping #access-list 100 deny icmp 192.168.0.1 0.0.0.0 192.168.1.2 0.0.0.0 #access-list 100 p ...
- Python 类中__init__()方法中的形参与如何修改类中属性的值
一.__init__()方法 如果__init__()方法为 class Cat(): def __init__(self,num) : self.num=num Python中类的__init__( ...
- linux tftp配置 (Ubuntu18.04)
安装tftp客户端和服务器sudo apt-get install tftp-hpa tftpd-hpa xinetdtftp-hpa是客户端tftpd-hpa是服务器 配置文件 sudo vim / ...