
spark的sparkUI如何解读?
spark的sparkUI如何解读?
以spark2.1.4来做例子
Job - schedule mode
进入之后默认是进入spark job 页面
这个说明有很详细的解释,spark有两种操作算子:转换算子(transformation)和执行算子(Action)。当执行到行为算子的时候,就出发了一个Job作业,比如count()和saveAsTextFile()。
sparkJob页面头部有几个,最重要的是Schedule mode,表示的是Job的调度模型。如果多个线程调用多个并行的job,这些job就会被分配调用,这里就有个调度模型,一般是FIFO模型,先进先出模型。但是在spark0.8之后,就支持了一种FAIR模型,FAIR模型是一种公平模型,相当于每个任务轮换使用资源等,这样能使的小job能很快执行,而不用等大job完成才执行了。
Job - Event Timeline
这个就是用来表示调度job何时启动,何时结束,并且excutor何时加入。
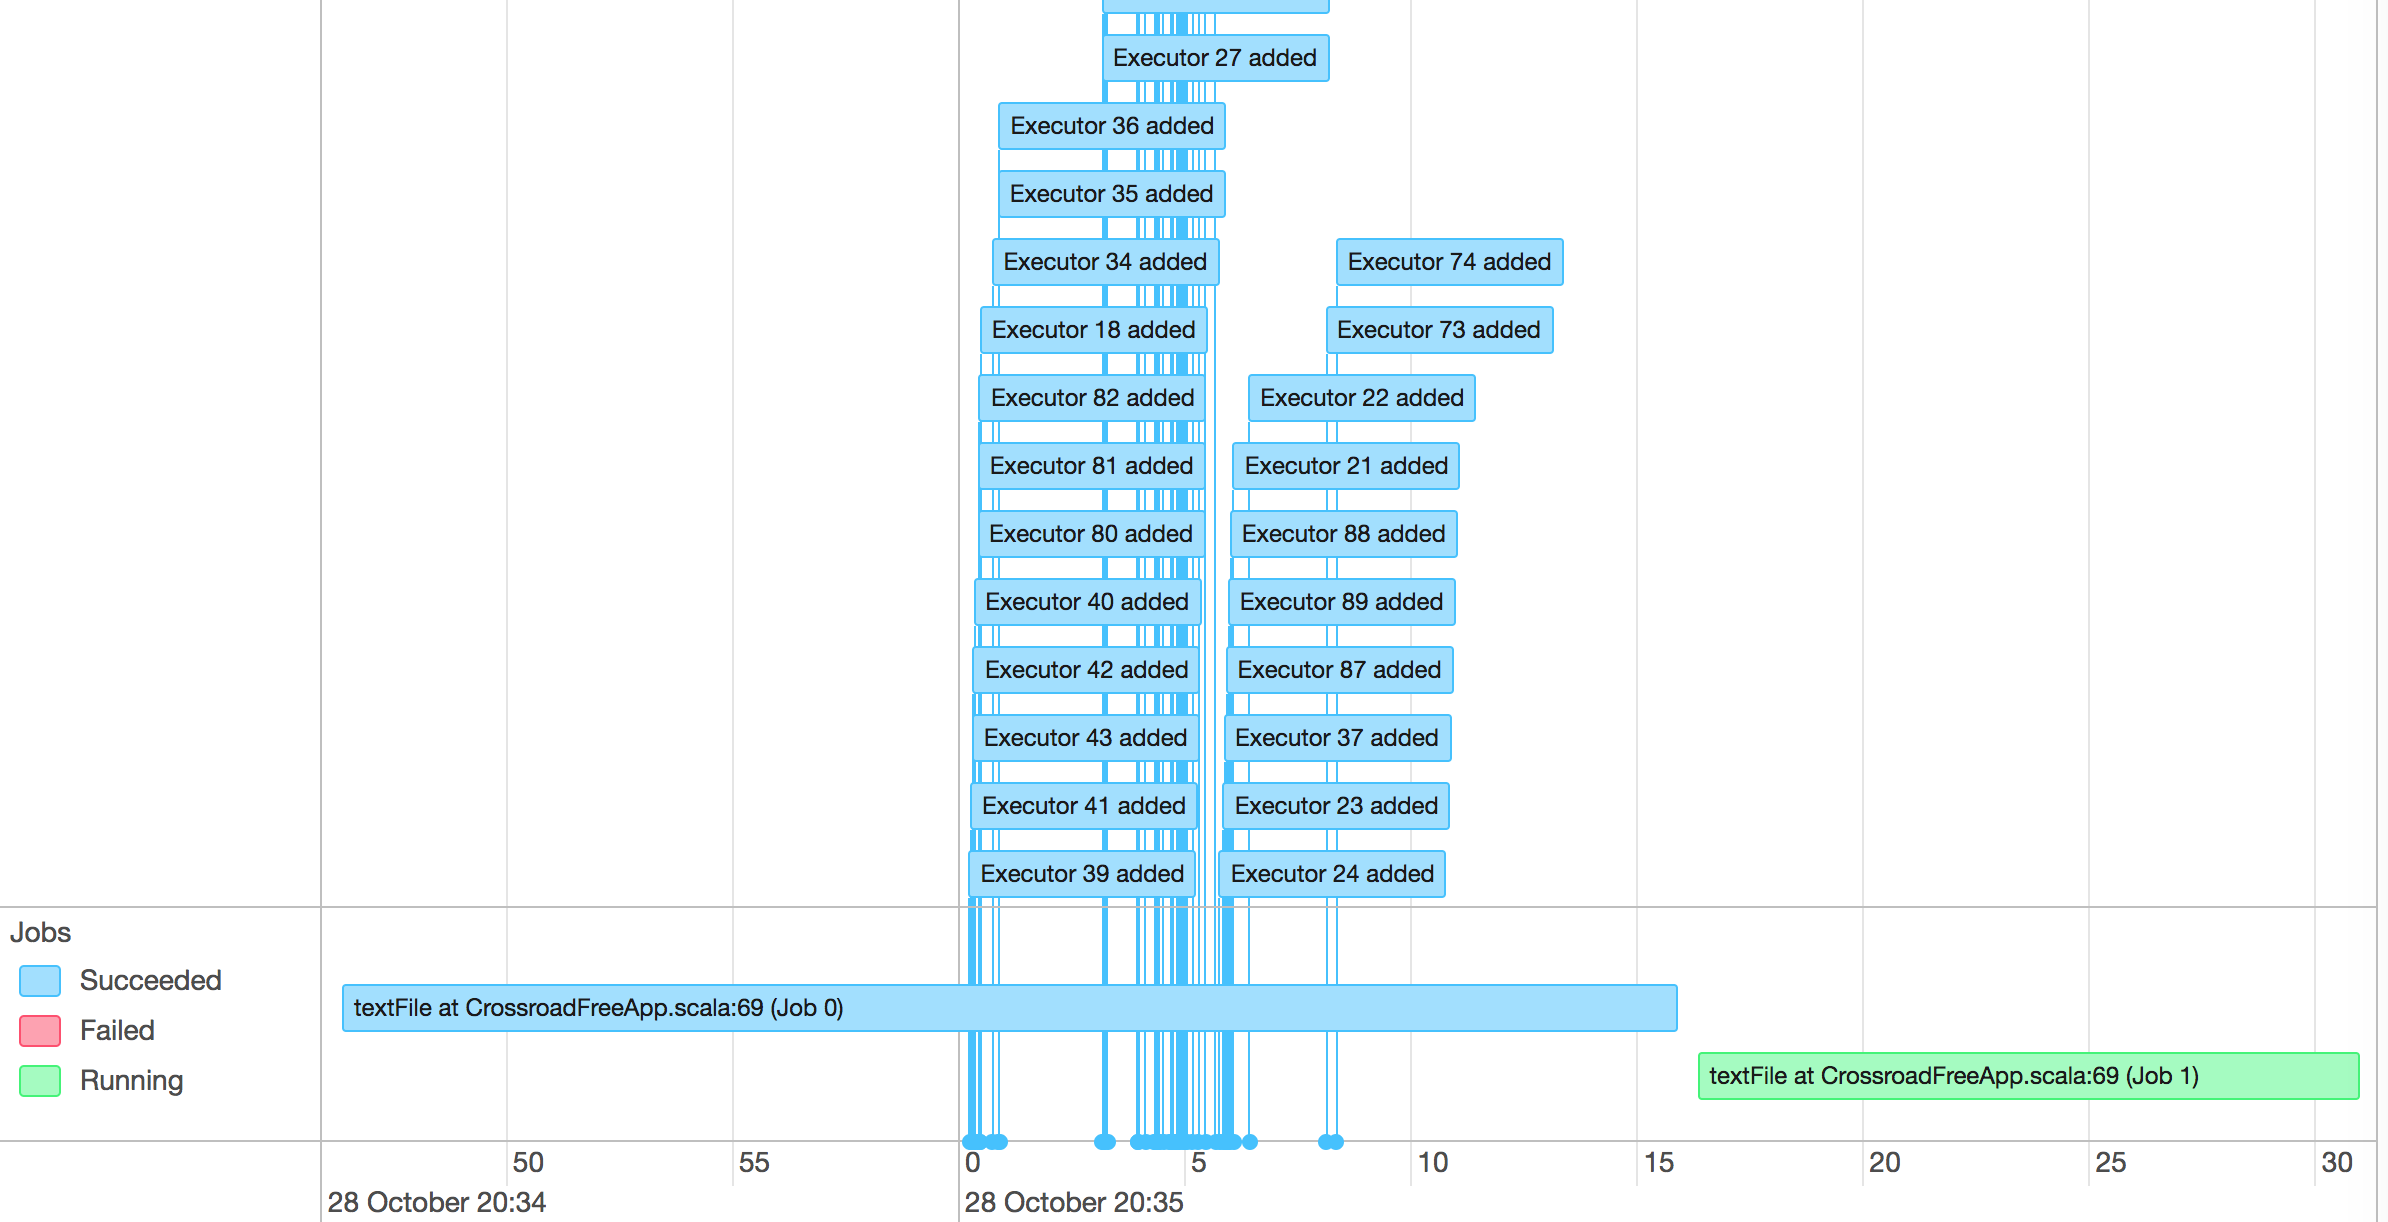
我们可以很方便看到哪些job已经运行完成,使用了多少excutor,哪些正在运行。
点击进入每个job,我们就可以看到每个job的detail
Details for Job
在这个页面我们能看到job的详情。一个job会被分为一个或者多个stage
这里也有event timeline,告诉我们这个job中每个stage执行时间。
这里多了一个DAG可视化的图
DAG
DAG图是有向无环图的意思。spark中使用有向无环图来显示流程。
DAG也是一种调度模型,在spark的作业调度中,有很多作业存在依赖关系,所以有的作业可以并行执行,有的作业不能并行执行。把这些作业的内部转向关系描绘清楚,就是一个DAG图。使用DAG图,就能很清晰看到我们的作业(RDD)哪些先执行,哪些后执行,哪些是并行执行的。
当调用了一个行为算子的时候,前面的所有转换算子也会一并提交给DAG调度器,DAG调度器把这些算子操作分为不同的stage,这个就是stage的由来。而DAG在画stage的时候也会产生出一个DAG图,就是这里的图了。
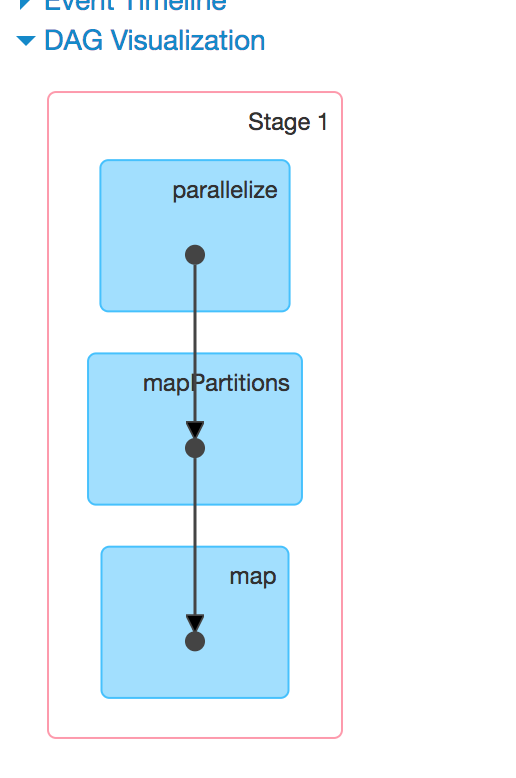
点击每个stage,我们就能看到这个stage执行的任务(Task)了。
Details for Stage
标题
标题代表这是第几号stage,第几次尝试。
Show Additional Metrics
Scheduler Delay
调度延迟时间,包含把任务从调度器输送给excutor,并且把任务的结果从excutor返回给调度器。如果调度时间比较久,则考虑降低任务的数量,并且降低任务结果大小
Task Deserialization Time
反序列化excutor的任务,也包含读取广播任务的时间
Shuffle Read Blocked Time
任务shuffle时间,从远端机器读取shuffle数据的时间
Shuffle Remote Reads
从远端机器读取shuffle数据的时间
Getting Result Time
从worker中获取结果的时间
// 这里应该还有一些其它的各种指标,等以后看代码的时候再补充。
在用图形表示完之后还有一个summary的时间统计,告诉你每个阶段的时间,所有任务的分布图。
Aggregated Metrics by Executor
这个矩阵告诉我们每个excutor的执行情况。
Tasks
告知每个任务的执行情况。
Environment
显示所有的环境变量
Excutors
显示每个excutor的统计情况
参考文章
http://www.csdn.net/article/2015-07-08/2825162
https://jaceklaskowski.gitbooks.io/mastering-apache-spark/content/spark-webui-StagePage.html
spark的sparkUI如何解读?的更多相关文章
- 【Spark】SparkContext源代码解读
SparkContext的初始化 SparkContext是应用启动时创建的Spark上下文对象,是进行Spark应用开发的主要接口,是Spark上层应用与底层实现的中转站(SparkContext负 ...
- 15、Spark Streaming源码解读之No Receivers彻底思考
在前几期文章里讲了带Receiver的Spark Streaming 应用的相关源码解读,但是现在开发Spark Streaming的应用越来越多的采用No Receivers(Direct Appr ...
- Spark Streaming源码解读之流数据不断接收和全生命周期彻底研究和思考
本节的主要内容: 一.数据接受架构和设计模式 二.接受数据的源码解读 Spark Streaming不断持续的接收数据,具有Receiver的Spark 应用程序的考虑. Receiver和Drive ...
- Spark Streaming源码解读之No Receivers彻底思考
本期内容 : Direct Acess Kafka Spark Streaming接收数据现在支持的两种方式: 01. Receiver的方式来接收数据,及输入数据的控制 02. No Receive ...
- Spark Streaming源码解读之State管理之UpdataStateByKey和MapWithState解密
本期内容 : UpdateStateByKey解密 MapWithState解密 Spark Streaming是实现State状态管理因素: 01. Spark Streaming是按照整个Bach ...
- Spark Streaming源码解读之数据清理内幕彻底解密
本期内容 : Spark Streaming数据清理原理和现象 Spark Streaming数据清理代码解析 Spark Streaming一直在运行的,在计算的过程中会不断的产生RDD ,如每秒钟 ...
- Spark Streaming源码解读之Driver容错安全性
本期内容 : ReceivedBlockTracker容错安全性 DStreamGraph和JobGenerator容错安全性 Driver的安全性主要从Spark Streaming自己运行机制的角 ...
- Spark Streaming源码解读之Executor容错安全性
本期内容 : Executor的WAL 消息重放 数据安全的角度来考虑整个Spark Streaming : 1. Spark Streaming会不断次序的接收数据并不断的产生Job ,不断的提交J ...
- Spark Streaming源码解读之流数据不断接收全生命周期彻底研究和思考
本期内容 : 数据接收架构设计模式 数据接收源码彻底研究 一.Spark Streaming数据接收设计模式 Spark Streaming接收数据也相似MVC架构: 1. Mode相当于Rece ...
随机推荐
- 【机器学习实战】Machine Learning in Action 代码 视频 项目案例
MachineLearning 欢迎任何人参与和完善:一个人可以走的很快,但是一群人却可以走的更远 Machine Learning in Action (机器学习实战) | ApacheCN(apa ...
- JVM 运行时数据区总结 栈 堆 堆大小配置总结
1. 程序计数器 线程私有 当前线程所执行的字节码的行号指示器 2. 虚拟机栈 线程私有 存:Java方法(局部变量表(基本数据类型).操作数栈.动态链栈.方法出口) StackOverflowErr ...
- MongoDB分片原理篇
MongoDB分片 为什么需要Sharded cluster? MongoDB目前3大核心优势:『灵活模式』+ 『高可用性』 + 『可扩展性』,通过json文档来实现灵活模式,通过复制集来保证高可用, ...
- 框架应用:Spring framework (一) - IoC技术
IoC概念以及目标 IoC就是让原本你自己管理的对象交由容器来进行管理,其主要的目的是松耦合. IoC发展史 既然IoC的目标是为了松耦合,那它怎么做到的? 最后目标:降低对象之间的耦合度,IoC技术 ...
- Ubuntu16.04.1上搭建分布式的Redis集群
为什么要集群: 通常为了,提高网站的响应速度,总是把一些经常用到的数据放到内存中,而不是放到数据库中,Redis是一个很好的Cache工具,当然了还有Memcached,这里只讲Redis.在我们的电 ...
- XtraGrid滚轮翻页
滚轮翻页与传动的翻页更为方便,经过本人一番探讨与琢磨终于在XtraGrid的GridView中实现了鼠标滚轮翻页. 我新建了一个组件继承原本的GridControl,在组件中添加了一个ImageLis ...
- PHP实现页面静态化
1.通过buffer来实现 需要用file_put_contents ob_get_clean()等内置函数 ob_start (); include "filterpost.htm ...
- 翻译:MariaDB wait/nowait
本文为mariadb官方手册:wait/nowait的译文.原文:https://mariadb.com/kb/en/library/wait-and-nowait/ 从MariaDB 10.3.0开 ...
- Linux安装pytorch的具体过程以及其中出现问题的解决办法
1.安装Anaconda 安装步骤参考了官网的说明:https://docs.anaconda.com/anaconda/install/linux.html 具体步骤如下: 首先,在官网下载地址 h ...
- Spring常用注解介绍【经典总结】
Spring的一个核心功能是IOC,就是将Bean初始化加载到容器中,Bean是如何加载到容器的,可以使用Spring注解方式或者Spring XML配置方式. Spring注解方式减少了配置文件内容 ...