
利用Pycharm本地调试spark-streaming(包含kafka和zookeeper等操作)
环境准备就不说了!
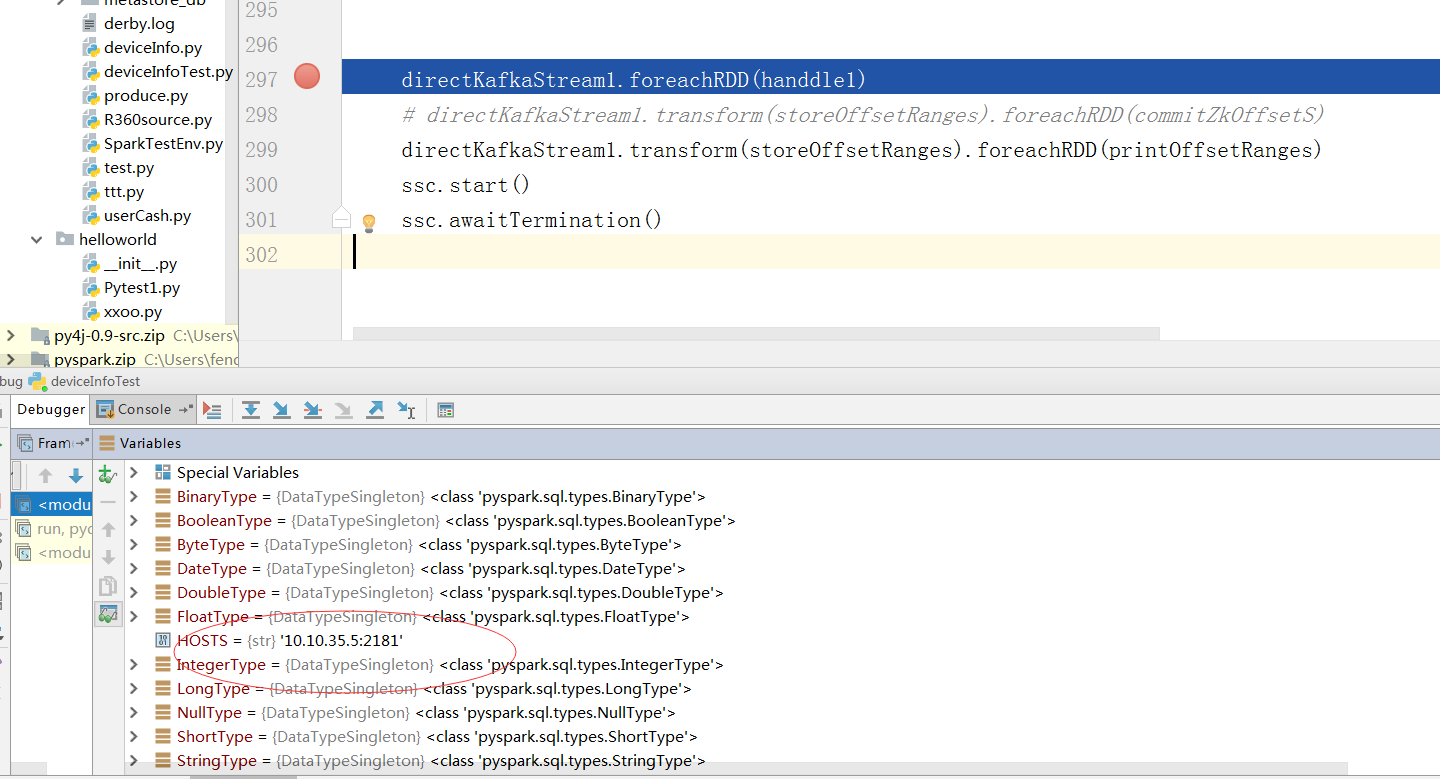
第一步:打开Pycharm,在File->Setting->Project Structure中点击Add Content Root 添加本地python调用java和spark的组件(因为python和spark通讯是通过调用Jvm的相关组件实现的) ,包含两个压缩包可以在spark的安装包里面找到

第二步:在项目文件内添加本地配置
os.environ['SPARK_HOME'] = r'C:\Users\fengxu\Desktop\bigdata-software\spark-1.6.0-bin-hadoop2.6'
os.environ['JAVA_HOME'] = r'C:\software\jdk1.8'
sys.path.append(r"C:\Users\fengxu\Desktop\bigdata-software\spark-1.6.0-bin-hadoop2.6\python") 第三步:也是最重要的一步需要在本地的spark安装包内找到spark-defaults.conf的配置文件在末尾添加一行
spark.jars.packages org.apache.spark:spark-streaming-kafka-0-8_2.10:2.0.1
这是本地操作kafka和一些组件的必备jar包。配置完毕以后就可以在maven仓库下载相关jar包了
(报了很多错误,查阅了很多英文文档才找到答案,国内没有找到相关问题答案) 成功后就可以利用本地的python和本地相关组件(spark,kafka hdfs)调试和操作远程组件了!
成功后会在本地环境生成(多线程模拟集群)写入的hdfs文件可以调试了,操作本地文件还是很有用的哈!
利用Pycharm本地调试spark-streaming(包含kafka和zookeeper等操作)的更多相关文章
- Spark streaming消费Kafka的正确姿势
前言 在游戏项目中,需要对每天千万级的游戏评论信息进行词频统计,在生产者一端,我们将数据按照每天的拉取时间存入了Kafka当中,而在消费者一端,我们利用了spark streaming从kafka中不 ...
- Spark学习之路(十六)—— Spark Streaming 整合 Kafka
一.版本说明 Spark针对Kafka的不同版本,提供了两套整合方案:spark-streaming-kafka-0-8和spark-streaming-kafka-0-10,其主要区别如下: s ...
- Spark 系列(十六)—— Spark Streaming 整合 Kafka
一.版本说明 Spark 针对 Kafka 的不同版本,提供了两套整合方案:spark-streaming-kafka-0-8 和 spark-streaming-kafka-0-10,其主要区别如下 ...
- Spark Streaming和Kafka整合保证数据零丢失
当我们正确地部署好Spark Streaming,我们就可以使用Spark Streaming提供的零数据丢失机制.为了体验这个关键的特性,你需要满足以下几个先决条件: 1.输入的数据来自可靠的数据源 ...
- spark streaming 整合kafka(二)
转载:https://www.iteblog.com/archives/1326.html 和基于Receiver接收数据不一样,这种方式定期地从Kafka的topic+partition中查询最新的 ...
- Spark Streaming之四:Spark Streaming 与 Kafka 集成分析
前言 Spark Streaming 诞生于2013年,成为Spark平台上流式处理的解决方案,同时也给大家提供除Storm 以外的另一个选择.这篇内容主要介绍Spark Streaming 数据接收 ...
- Spark Streaming和Kafka整合是如何保证数据零丢失
转载:https://www.iteblog.com/archives/1591.html 当我们正确地部署好Spark Streaming,我们就可以使用Spark Streaming提供的零数据丢 ...
- spark streaming 对接kafka记录
spark streaming 对接kafka 有两种方式: 参考: http://group.jobbole.com/15559/ http://blog.csdn.net/kwu_ganymede ...
- Spark Streaming、Kafka结合Spark JDBC External DataSouces处理案例
场景:使用Spark Streaming接收Kafka发送过来的数据与关系型数据库中的表进行相关的查询操作: Kafka发送过来的数据格式为:id.name.cityId,分隔符为tab zhangs ...
随机推荐
- String+ String.Concat String.Format StringBuilder 之间的性能测试
找到一篇国外的代码,专门来测试这个, String+ String.Concat String.Format StringBuilder 前三个在100个左右字符串差不多, String.Concat ...
- 有关 Hybrid 开发模式实践总结
前言 随着公司业务不断发展,移动开发项目越来越多,项目任务时间紧,我们内部开发流程是以项目为导向,有别于一般公司对产品不断迭代的做法,但移动端开发人员资源有限,需要在不同项目之间做业务场景切换开发,就 ...
- mysq参数sql_safe_updates限制范围
在mysql运维中出现过不少因为update/delete条件错误导致数据被误更新或者删除的case,为避免类似问题的发生,可以用sql_safe_updates参数来对update/delete做限 ...
- Oracle的常用命令之备份和恢复数据库
1 将数据库TES完全导出,用户名system 密码manager 导出到D:\daochu.dmp中 exp system/manager@TEST file=d:\daochu.dmp 2 将数据 ...
- 用SqlCommandBuilder 实现批量更新
一般是这样的,如果用设计器将SqlDataAdapter拖到页面中使用时,不会出现SqlDataAdapter.Update(ds)更新时出错情况,因为系统会自动生成SqlDataAdapter的属性 ...
- 初学者易上手的SSH-struts2 02Action获取表单数据-通配符
在上一章中,我们已经搭建好了struts2的一个开发环境,那么这一章就来做一个简单的登录功能,以及介绍和使用struts2里面一个重要的东西-通配符. 第一步,在WebContent下面新建一个log ...
- 结束《Java编程思想》(Thinking in Java)自学的读后感(2017.10.15)
首先划重点:这是一本Java的入门书. 自学前需要的条件:已经具备基本的计算机基础. 1)已经对一种编程语言比较熟悉: 2)有过四年计算机专业学习,或者三年以上的软件开发经验, 自学的方法: 1)完全 ...
- DevOps之服务故障
唠叨话 关于德语噢屁事的知识点,仅提供精华汇总,具体知识点细节,参考教程网址,如需帮助,请留言. <DevOps服务故障> 0.故障1.设施故障2.设备故障3.系统故障4.虚拟化故障5.存 ...
- 使用MVVM减少控制器代码实战(减少56%)
减少比例= (360(原来的行数)-159(瘦身后的行数))/360 = 56% 父类 MVC 和MVVM 前后基本不动 父类主要完成如下三个功能: 1)功能:MJRefrsh +上拉下拉没有更多数据 ...
- 【学习】jquery.placeholder.js让IE浏览器支持html5的placeholder
type为text或password的input,其在实际应用时,往往有一个占位符,类似这样的: 在没有html5前,一般写成value,用js实现交互,文本框获得焦点时,提示文字消失,失去焦点时,文 ...