
python爬虫——写出最简单的网页爬虫
在我们日常上网浏览网页的时候,经常会看到一些好看的图片,我们就希望把这些图片保存下载,或者用户用来做桌面壁纸,或者用来做设计的素材。我们可以通过python 来实现这样一个简单的爬虫功能,把我们想要的代码爬取到本地。下面就看看如何使用python来实现这样一个功能。
一、开发工具
笔者使用的工具是sublimetext3,它的短小精悍(可能男人们都不喜欢这个词)使我十分着迷。推荐大家使用,当然如果你的电脑配置不错,pycharm可能更加适合你。
sublime text3搭建python开发环境推荐查看此博客:
[sublime搭建python开发环境][http://www.cnblogs.com/codefish/p/4806849.
二、爬虫介绍
爬虫顾名思义,就是像虫子一样,爬在Internet这张大网上。如此,我们便可以获取自己想要的东西。
既然要爬在Internet上,那么我们就需要了解URL,法号“统一资源定位器”,小名“链接”。其结构主要由三部分组成:
(1)协议:如我们在网址中常见的HTTP协议。
(2)域名或者IP地址:域名,如:www.baidu.com,IP地址,即将域名解析后对应的IP。
(3)路径:即目录或者文件等。
三、urllib开发最简单的爬虫
(1)urllib简介
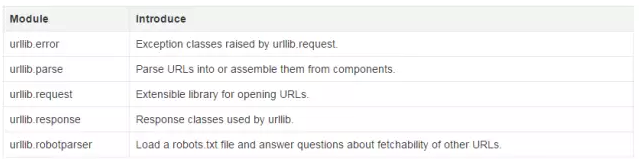
(2)开发最简单的爬虫
百度首页简洁大方,很适合我们爬虫。
爬虫代码如下:
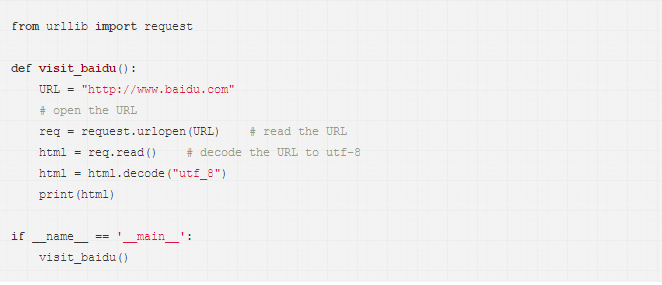
结果如图

我们可以通过在百度首页空白处右击,查看审查元素来和我们的运行结果对比。
当然,request也可以生成一个request对象,这个对象可以用urlopen方法打开。
代码如下:
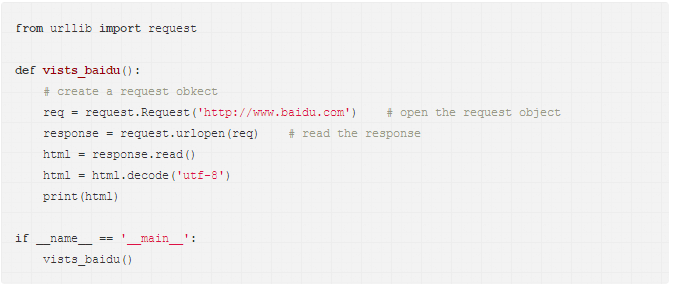
运行结果和刚才相同。
(3)错误处理
错误处理通过urllib模块来处理,主要有URLError和HTTPError错误,其中HTTPError错误是URLError错误的子类,即HTTRPError也可以通过URLError捕获。HTTPError可以通过其code属性来捕获。
处理HTTPError的代码如下:
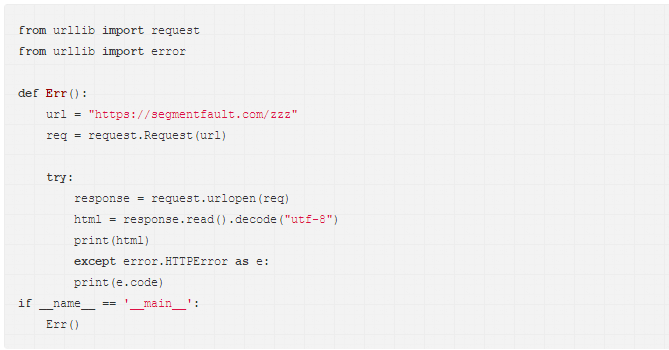
运行结果如图:
404为打印出的错误代码,关于此详细信息大家可以自行百度。
URLError可以通过其reason属性来捕获。
chuliHTTPError的代码如下:
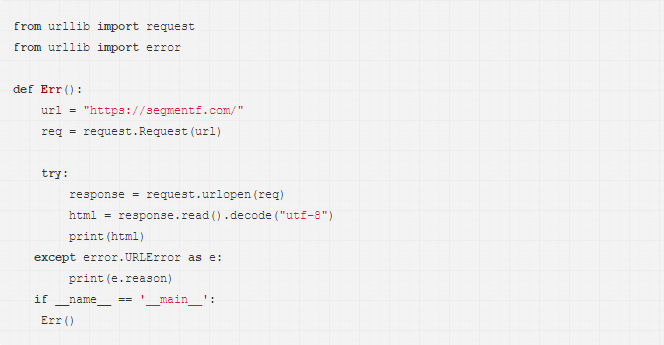
运行结果如图:
既然为了处理错误,那么最好两个错误都写入代码中,毕竟越细致越清晰。须注意的是,HTTPError是URLError的子类,所以一定要将HTTPError放在URLError的前面,否则都会输出URLError的,如将404输出为Not Found。
代码如下:

文章来源:https://segmentfault.com/a/1190000010567472
作者:xiaomi
交流QQ群:238757010
python爬虫——写出最简单的网页爬虫的更多相关文章
- python实现的一个简单的网页爬虫
学习了下python,看了一个简单的网页爬虫:http://www.cnblogs.com/fnng/p/3576154.html 自己实现了一个简单的网页爬虫,获取豆瓣的最新电影信息. 爬虫主要是获 ...
- (转)Python新手写出漂亮的爬虫代码2——从json获取信息
https://blog.csdn.net/weixin_36604953/article/details/78592943 Python新手写出漂亮的爬虫代码2——从json获取信息好久没有写关于爬 ...
- (转)Python新手写出漂亮的爬虫代码1——从html获取信息
https://blog.csdn.net/weixin_36604953/article/details/78156605 Python新手写出漂亮的爬虫代码1初到大数据学习圈子的同学可能对爬虫都有 ...
- [置顶]
如何用PYTHON代码写出音乐
如何用PYTHON代码写出音乐 什么是MIDI 博主本人虽然五音不全,而且唱歌还很难听,但是还是非常喜欢听歌的.我一直在做这样的尝试,就是通过人工智能算法实现机器自动的作词和编曲(在这里预告下,通过深 ...
- 如何用PYTHON代码写出音乐
什么是MIDI 博主本人虽然五音不全,而且唱歌还很难听,但是还是非常喜欢听歌的.我一直在做这样的尝试,就是通过人工智能算法实现机器自动的作词和编曲(在这里预告下,通过深度学习写歌词已经实现了,之后会分 ...
- 用sublime写出的第一个网页
STEP1 完成语义分析器 我用的vs2013 c语言写的 这个过程会在下一篇文章中详讲 准备好几个编译好的图,放在一个文件夹里,像下面这样 STEP2 规划好html的框架 上代码! (截图版) ( ...
- python3爬虫.1.简单的网页爬虫
此为记录下我自己的爬虫学习过程. 利用url包抓取网页 import urllib.request #url包 def main(): url = "http://www.douban.co ...
- Python 网页爬虫 & 文本处理 & 科学计算 & 机器学习 & 数据挖掘兵器谱(转)
原文:http://www.52nlp.cn/python-网页爬虫-文本处理-科学计算-机器学习-数据挖掘 曾经因为NLTK的缘故开始学习Python,之后渐渐成为我工作中的第一辅助脚本语言,虽然开 ...
- nodeJS实现简单网页爬虫功能
前面的话 本文将使用nodeJS实现一个简单的网页爬虫功能 网页源码 使用http.get()方法获取网页源码,以hao123网站的头条页面为例 http://tuijian.hao123.com/h ...
随机推荐
- indexOf 和 lastIndexOf的区别
indexOf 和 lastIndexOf 是什么? indexOf 和 lastIndexOf 都是索引文件 indexOf 是查某个指定的字符串在字符串首次出现的位置(索引值) (也就是从前往后 ...
- python3 三级菜单-基础版
# -*- coding:utf-8 -*- data = { "北京":{ "东城区":{ "安定门":["国子监", ...
- C#设计模式之二十策略模式(Stragety Pattern)【行为型】
一.引言 今天我们开始讲"行为型"设计模式的第七个模式,该模式是[策略模式],英文名称是:Stragety Pattern.在现实生活中,策略模式的例子也非常常见,例如,在一个 ...
- Solr7.1---数据库导入并建立中文分词器
这里只是告诉你如何导入,生产环境不要这样部署你的solr服务. 首先修改solrConfig.xml文件 备份_default文件夹 修改solrconfig.xml 加入如下内容 官方示例:< ...
- HDU 3569 Imaginary Date 简单期望
推一下公式.就会发现是这个.. 由于设结果有x种方案.则每一个数字出现的概率都均等,然后和就是x*m 每种方案的概率是1/x 每一个数出现的概率都是1/n 所以每一个方案的和就是 sum/n *m # ...
- xml基本语法(2)
本节要点: 了解XML的文档声明 了解XML的元素.命名规则.属性.元素内容.处理指令等概念 1 XML文档声明 表示该文档是一个XML文档,以及遵循哪个XML版本的规范. 规范:<?xml 版 ...
- vue-router实例
最近刚刚用vue写了个公司项目,使用vue-cli构建的,算是中大型项目吧,然后这里想记录并且分享一下其中的知识点,希望对大家有帮助,后期会逐渐分享:话不多说,直接上代码!! main.js // T ...
- 关于 getsockname、getpeername和gethostname、gethostbyname
一.gethostname,gethostbyname的用法 这两个函数可以用来获取主机的信息.gethostname:获取主机的名字gethostbyname:通过名字获取其他的信息(比如ip) 1 ...
- 深入理解计算机系统_3e 第六章家庭作业 CS:APP3e chapter 6 homework
6.22 假设磁道沿半径均匀分布,即总磁道数和(1-x)r成正比,设磁道数为(1-x)rk: 由题单个磁道的位数和周长成正比,即和半径xr成正比,设单个磁道的位数为xrz: 其中r.k.z均为常数. ...
- Swift MD5加密 所需桥接文件
Swift MD5加密在github有一个非常好的第三方库,使用也比较简单,还有很多加密方法,如果需要,点击这里下载 对于那些不需要太多的加密,只需要MD5加密的同学,我建议还是不要用第三方库. 因为 ...