
[Spark内核] 第40课:CacheManager彻底解密:CacheManager运行原理流程图和源码详解
本课主题
- CacheManager 运行原理图
- CacheManager 源码解析
CacheManager 运行原理图
[下图是CacheManager的运行原理图]
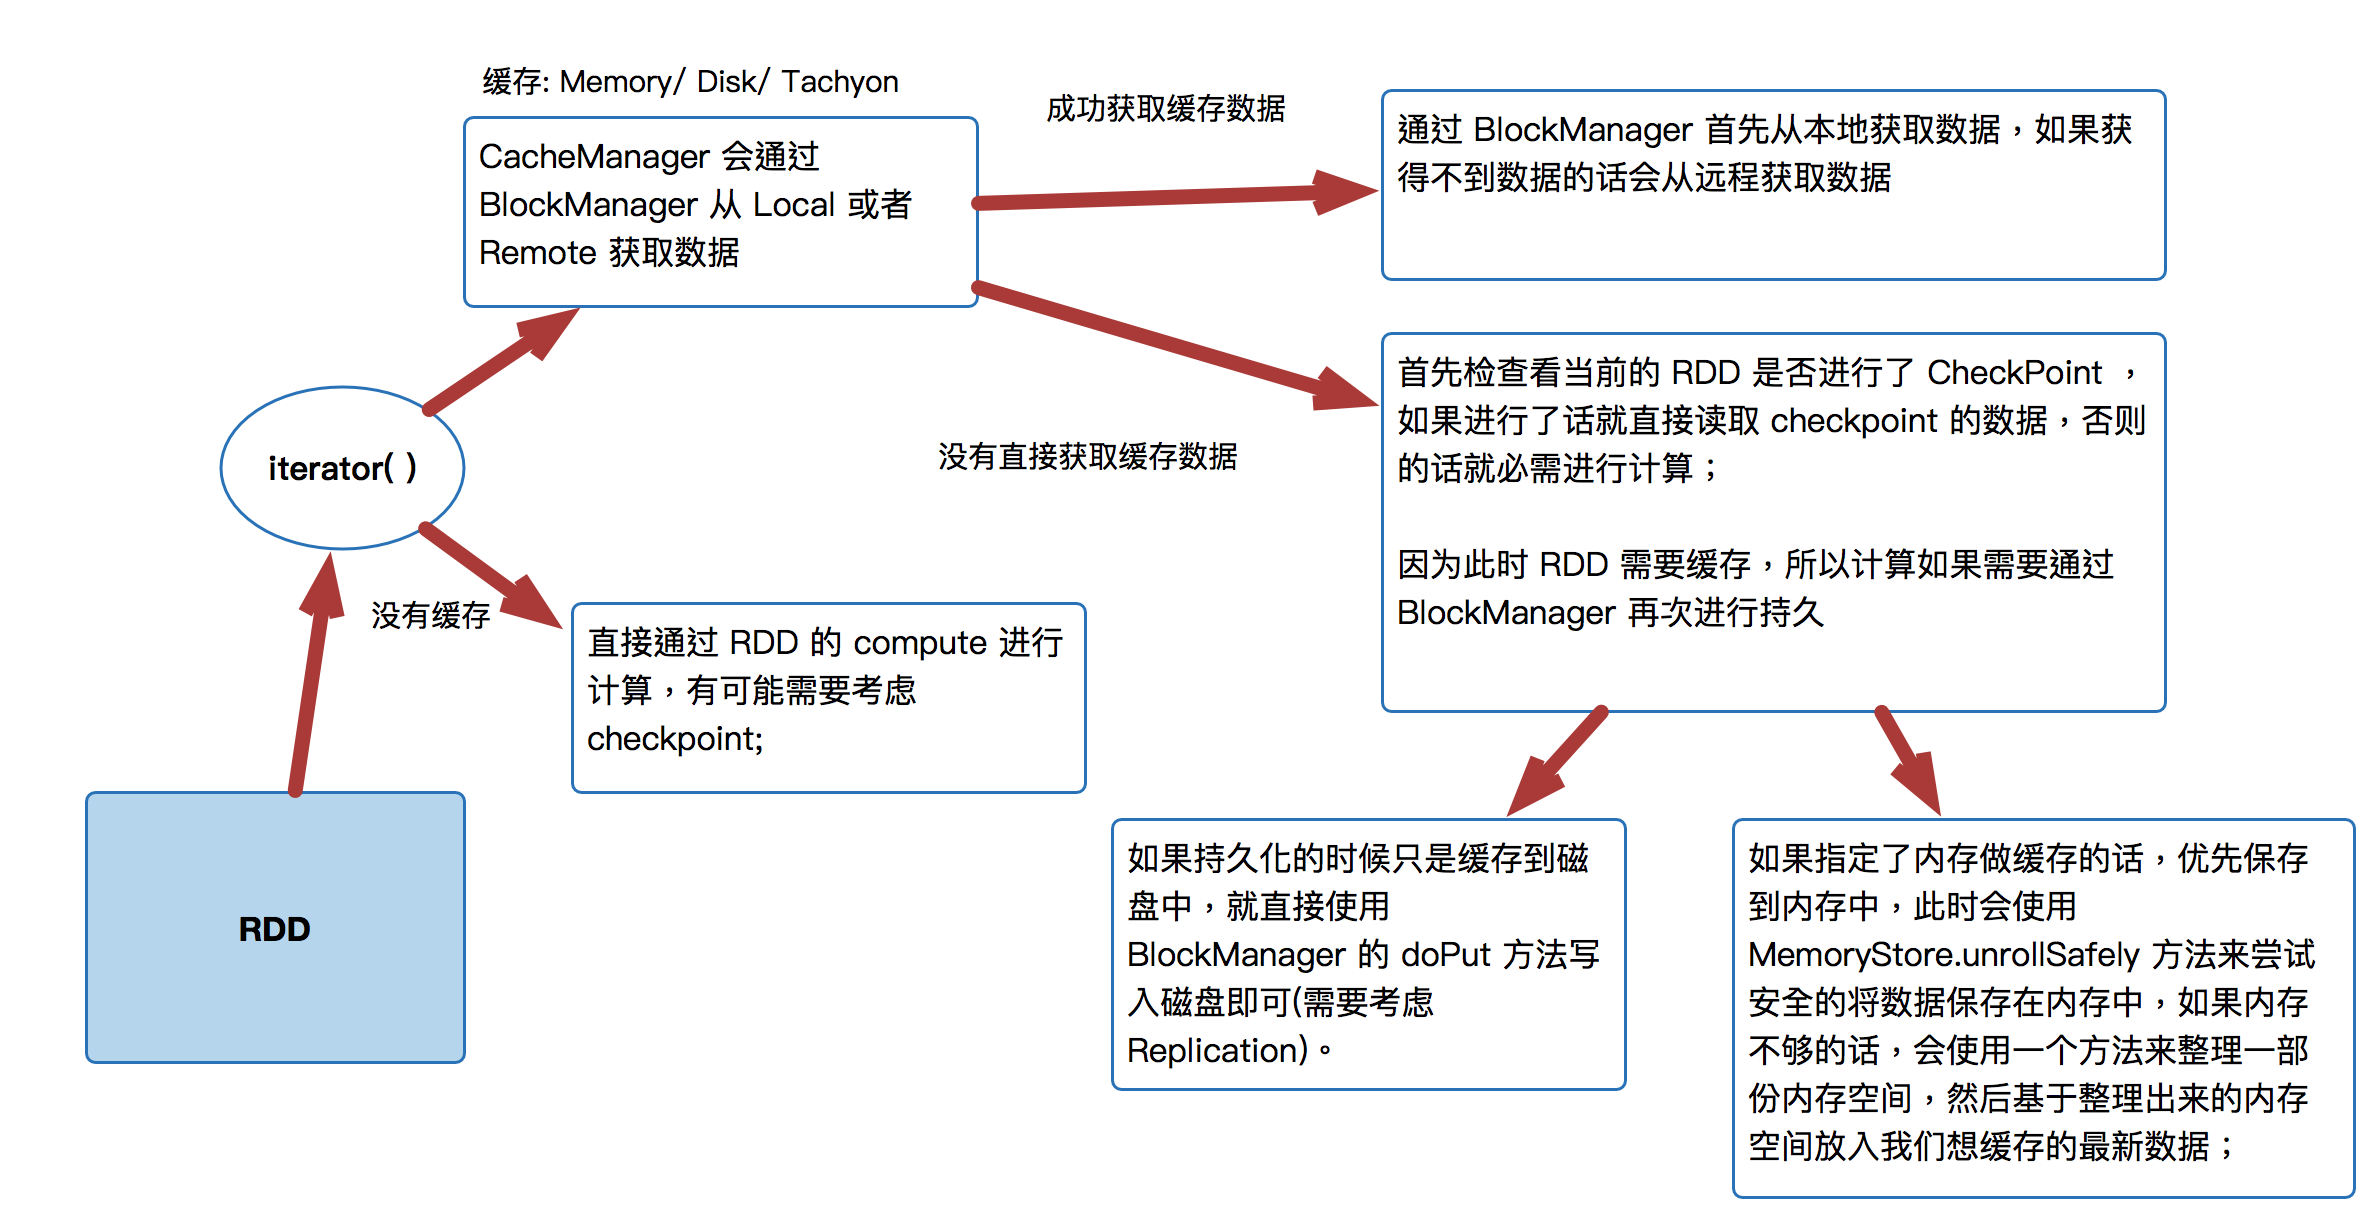
首先 RDD 是通过 iterator 来进行计算:
- CacheManager 会通过 BlockManager 从 Local 或者 Remote 获取数据直接通过 RDD 的 compute 进行计算,有可能需要考虑 checkpoint;
- 通过 BlockManager 首先从本地获取数据,如果获得不到数据的话会从远程获取数据
- 首先检查看当前的 RDD 是否进行了 CheckPoint ,如果进行了话就直接读取 checkpoint 的数据,否则的话就必需进行计算;因为此时 RDD 需要缓存,所以计算如果需要通过 BlockManager 再次进行持久
- 如果持久化的时候只是缓存到磁盘中,就直接使用 BlockManager 的 doPut 方法写入磁盘即可(需要考虑 Replication)。
- 如果指定了内存做缓存的话,优先保存到内存中,此时会使用MemoryStore.unrollSafely 方法来尝试安全的将数据保存在内存中,如果内存不够的话,会使用一个方法来整理一部份内存空间,然后基于整理出来的内存空间放入我们想缓存的最新数据;
- 直接通过 RDD 的 compute 进行计算,有可能需要考虑 checkpoint;
CacheManager 源码解析
- CacheManager 管理的是缓存中的数据,缓存可以是基于内存的缓存,也可以是基于磁盘的缓存;
- CacheManager 需要通过 BlockManager 来操作数据;
- 每当 Task 运行的时候会调用 RDD 的 Compute 方法进行计算,而 Compute 方法会调用 iterator 方法;
[下图是 MapPartitionRDD.scala 的 compute 方法]
这个方法是 final 级别不能覆写但可以被子类去使用,可以看见 RDD 是优先使用内存的,这个方法很关键!!如果存储级别不等于 NONE 的情况下,程序会先找 CacheManager 获得数据,否则的话会看有没有进行 Checkpoint
[下图是 RDD.scala 的 iterator 方法]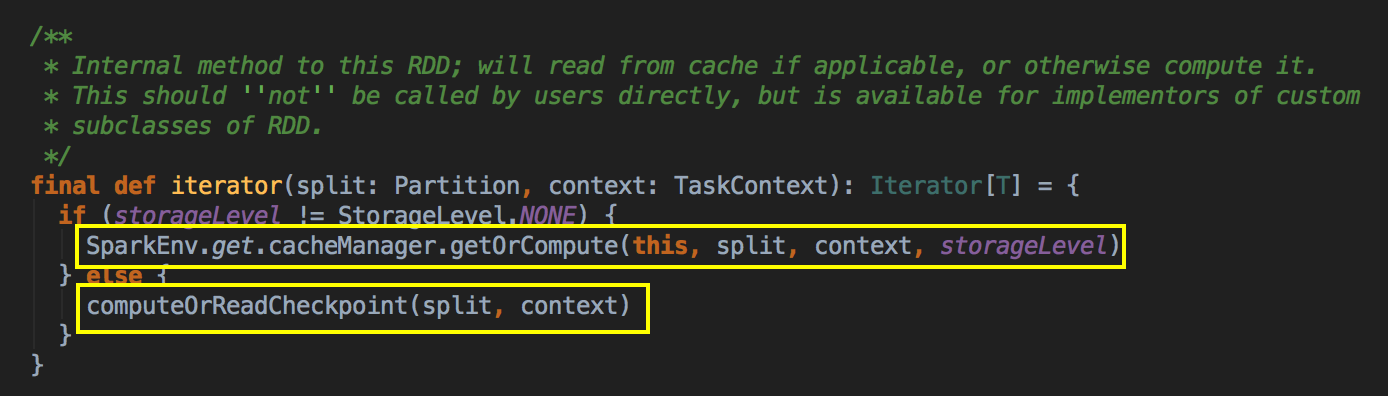
以下是 Spark 中的 StorageLevel
[下图是 StorageLevel.scala 的 StorageLevel 对象]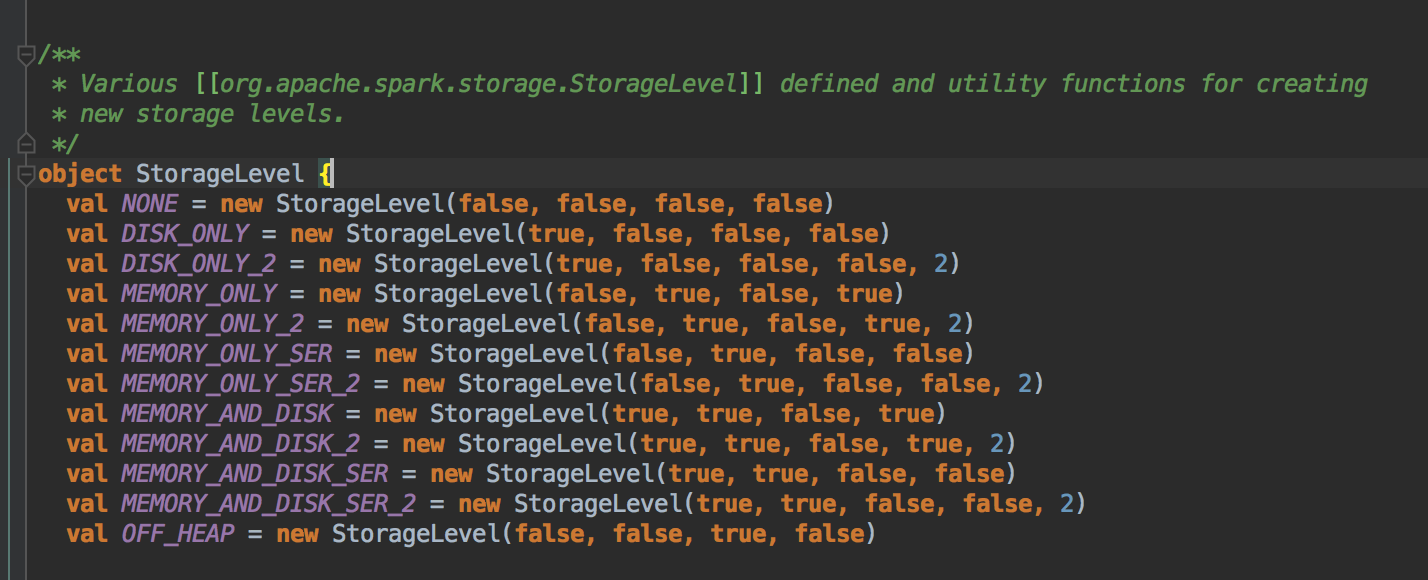
- Cache 在工作的时候会最大化的保留数据,但是数据不一定绝对完整,因为当前的计算如果需要内存空间的话,那么内存中的数据必需让出空间,这是因为执行比缓存重要!此时如何在RDD 持久化的时候同时指定了可以把数据放左Disk 上,那么部份 Cache 的数据可以从内存转入磁盘,否则的话,数据就会丢失!
假设现在 Cache 了一百万个数据分片,但是我下一个步骤计算的时候,我需要内存,思考题:你觉得是我现在需要的内存重要呢,还是你曾经 Cache 占用的空间重要呢?亳无疑问,肯定是现在计算重要。所以 Cache 占用的空间需要从内存中除掉,如果你程序的 StorageLevel 是 MEMEORY_AND_DISK 的话,这时候在内存可能是 Drop 到磁盘上,如果你程序的 StorageLevel 是 MEMEORY_ONLY 的话,那就会出去数据丢失的情况。
你进行Cache时,BlockManager 会帮你进行管理,我们可以通过 Key 到 BlockManager 中找出曾经缓存的数据。
[下图是 CacheManager.scala 的 getOrCompute 方法]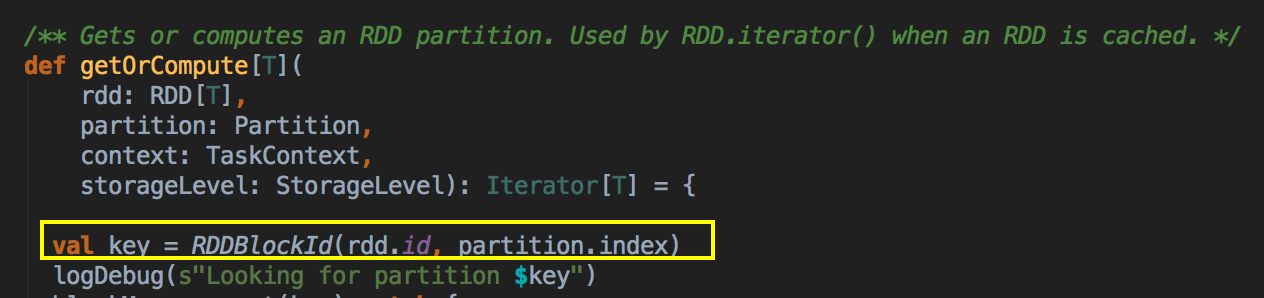
[下图是 CacheManager.scala 的 getOrCompute 方法内部具体的实现]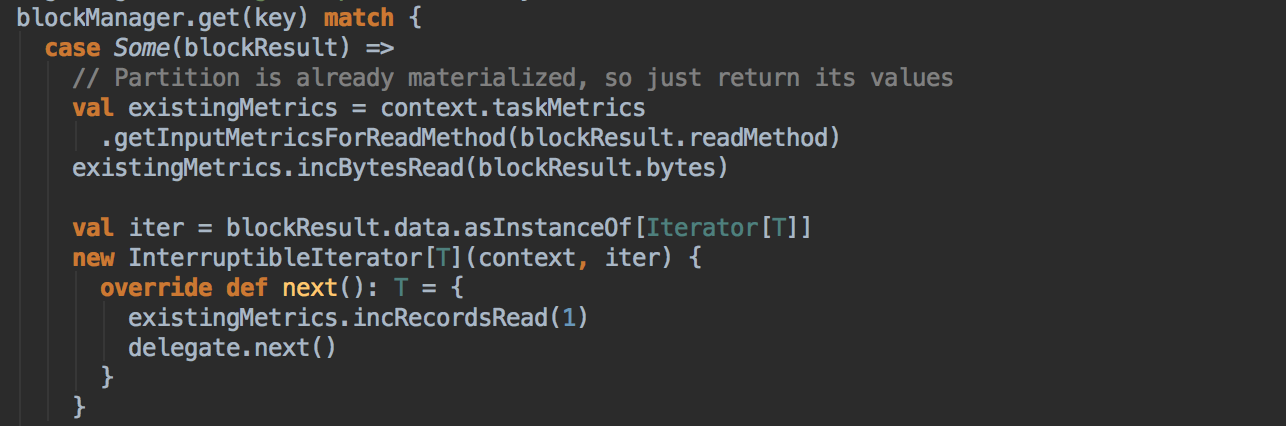
如果有 BlockManager.get() 方法没有返回任何数据,就调用 acquireLockForPartition 方法,因为会有可能多条线程在操作数据,Spark 有一个东西叫慢任务StraggleTask 推迟,StraggleTask 推迟的时候一般都会运行两个任务在两台机器上,你可能在你当前机器上没有发现这个内容,同时有远程也没有发现这个内容,只不过在你返回的那一刻,别人已经算完啦!
[下图是 CacheManager.scala 的 getOrCompute 方法内部具体的实现]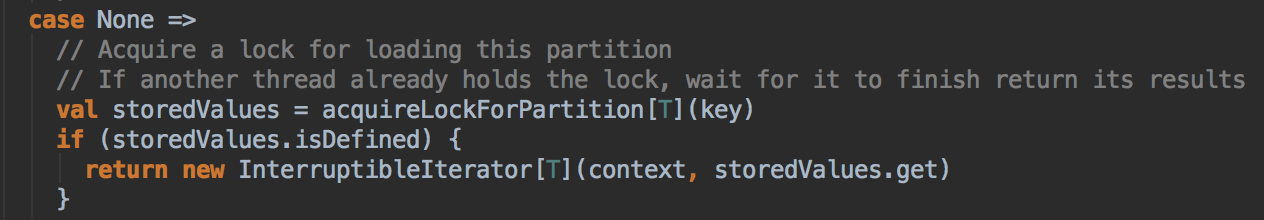
[下图是 CacheManager.scala 的 getOrCompute 方法内部具体的实现]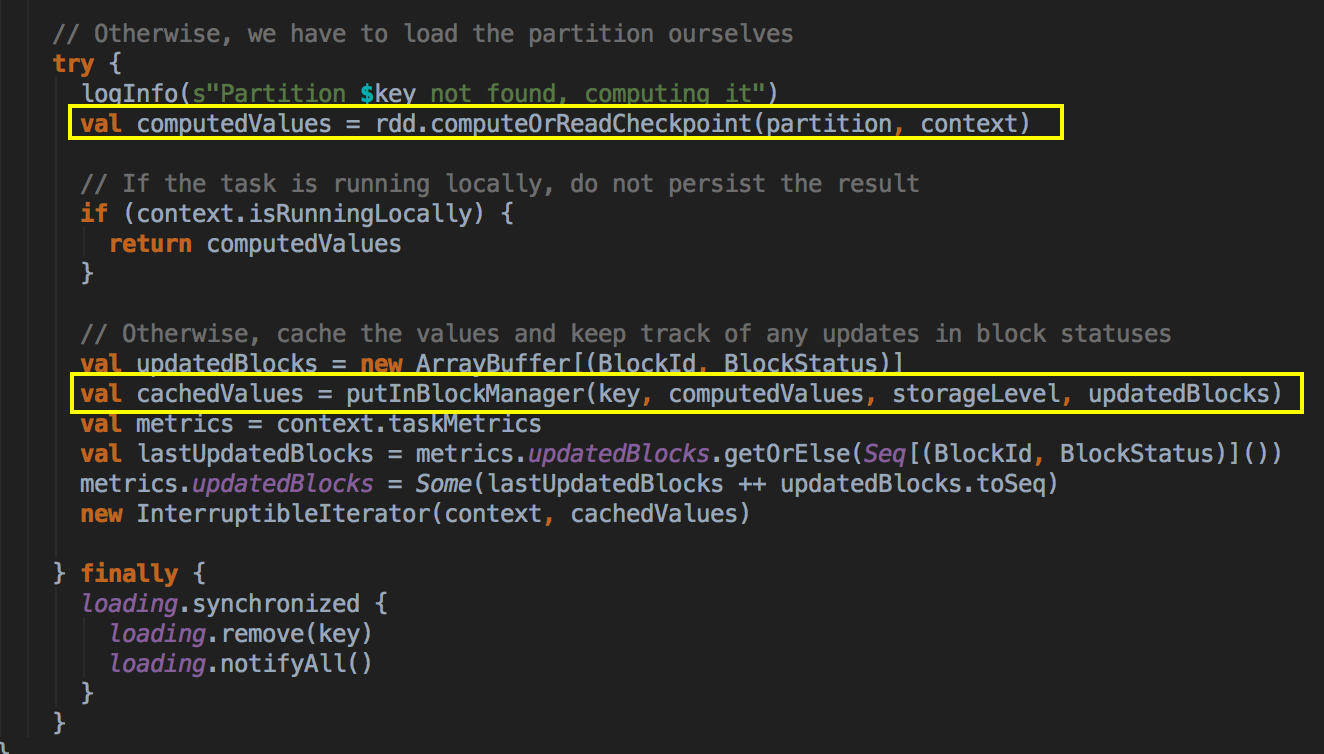
最后还是通过 BlockManager.get 来获得数据
[下图是 CacheManager.scala 的 acquireLockForPartition 方法]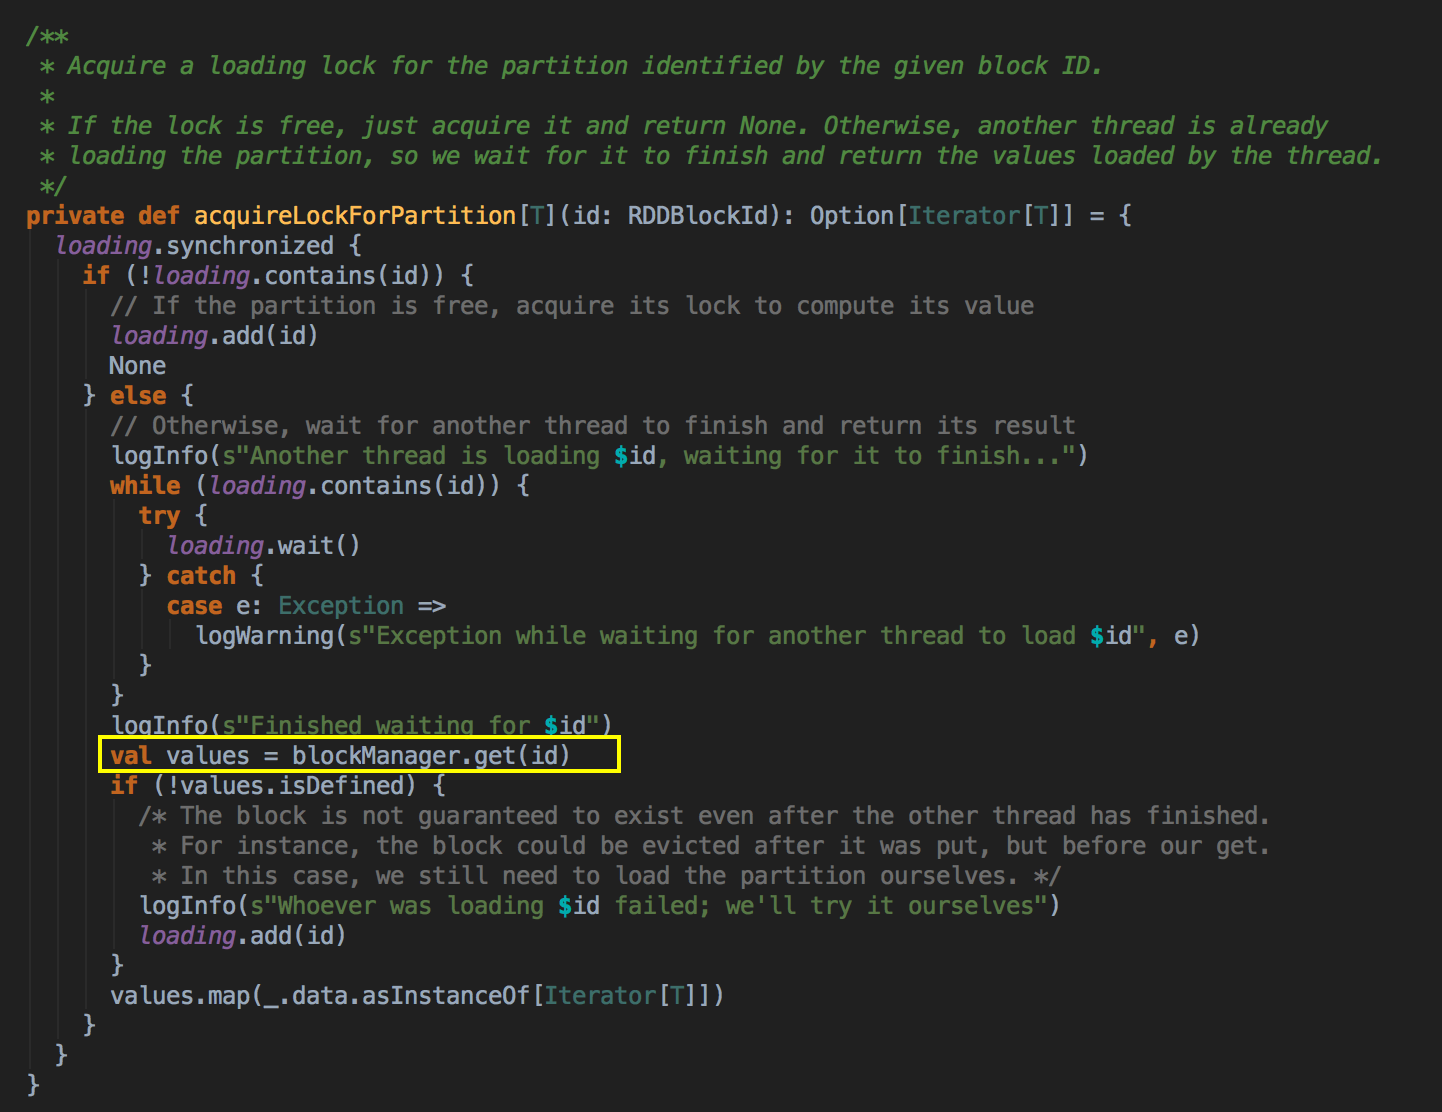
- 具体 CacheManager 在获得缓存数据的时候会通过 BlockManager 来抓到数据,优先在本地找数据或者的话就远程抓取数据。
[下图是 BlockManager.scala 的 get 方法]
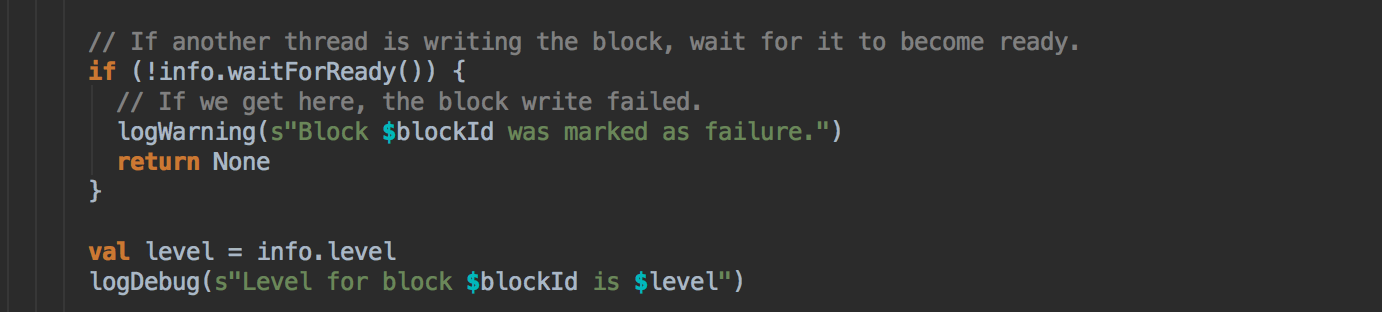
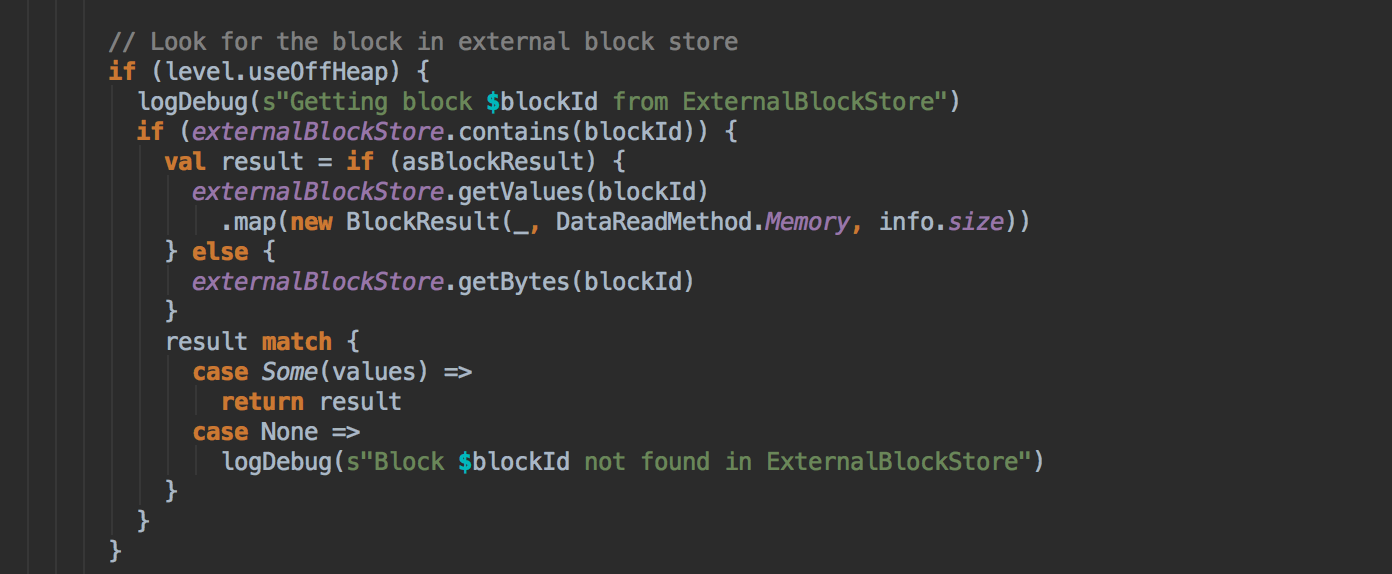
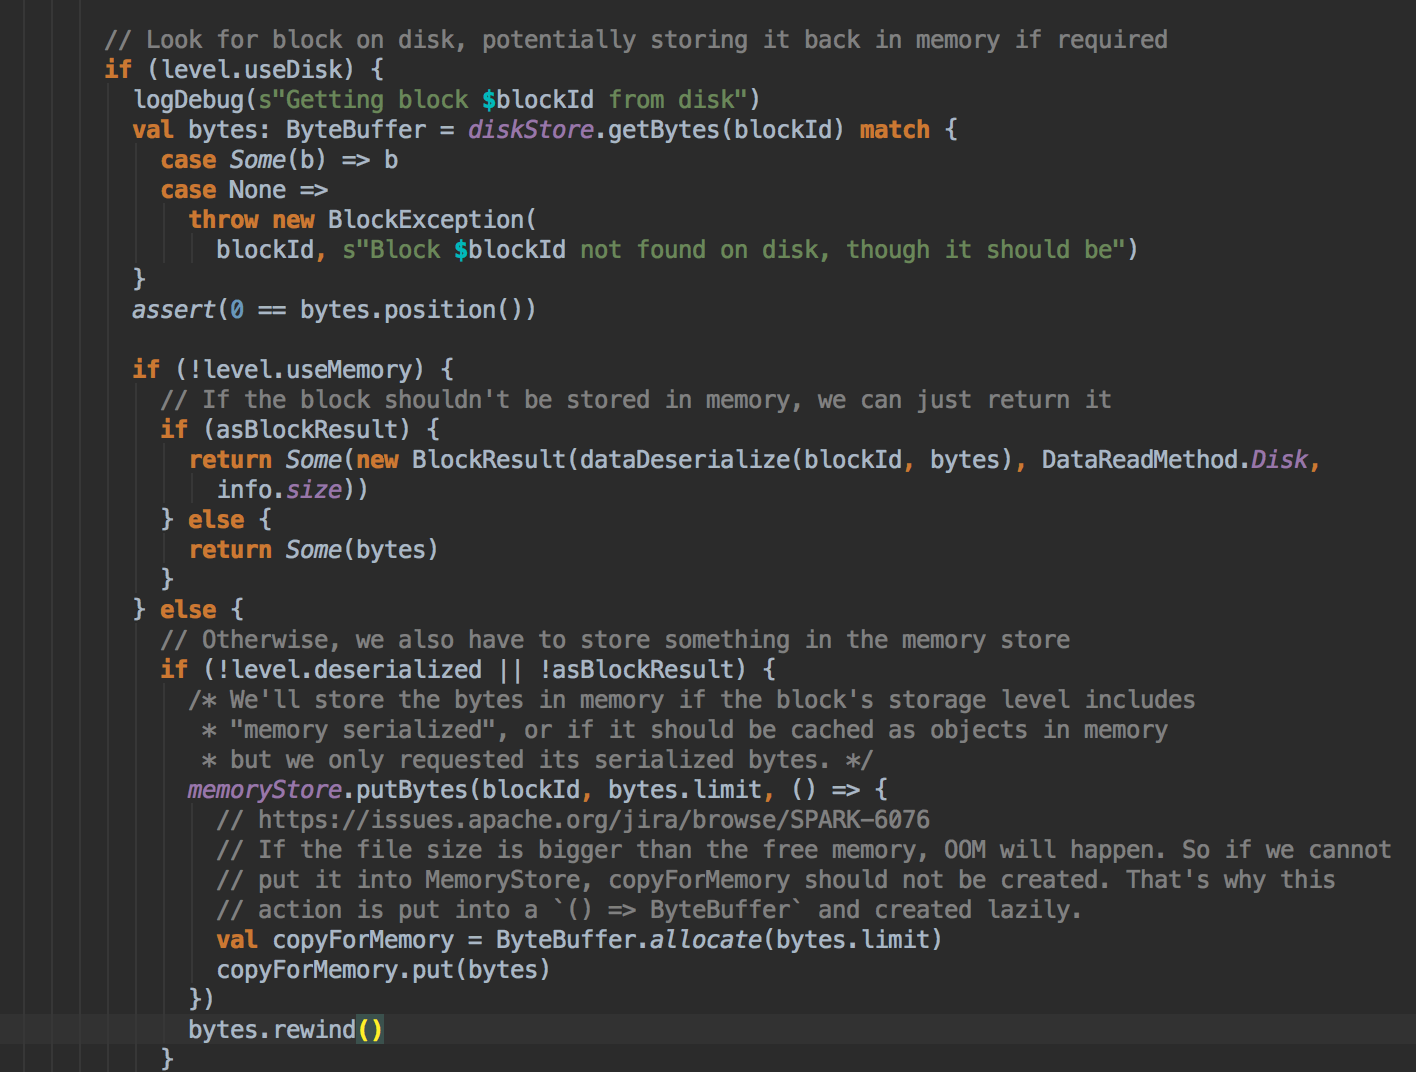
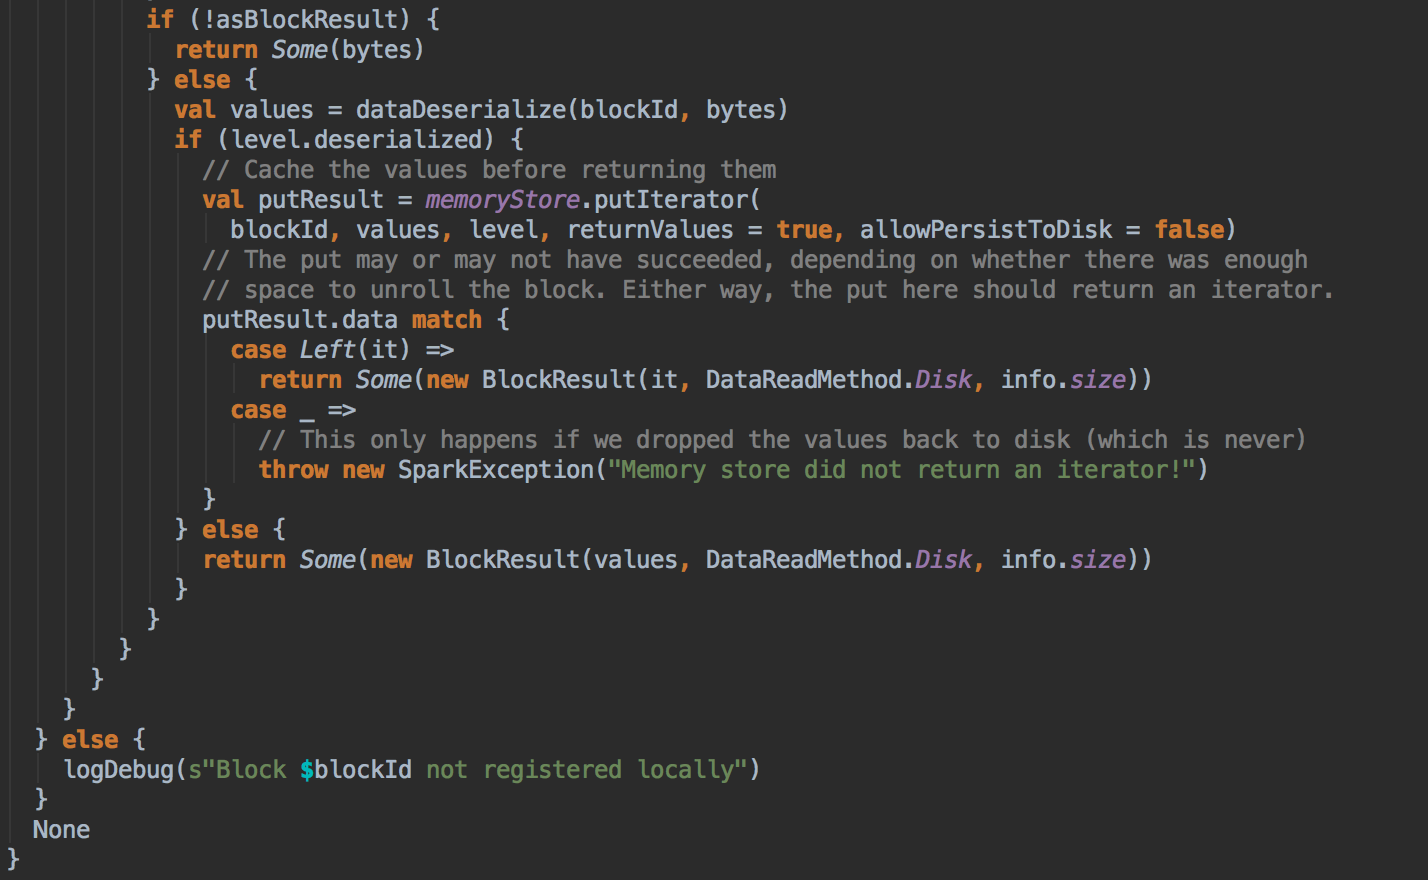
BlockManger.getLocal 然后转过来调用 doGetLocal 方法,在 doGetLocal 的实现中看到缓存其实不竟竟在内存中,可以在内存、磁盘、也可以在 OffHeap (Tachyon) 中
[下图是 BlockManager.scala 的 getLocal 方法]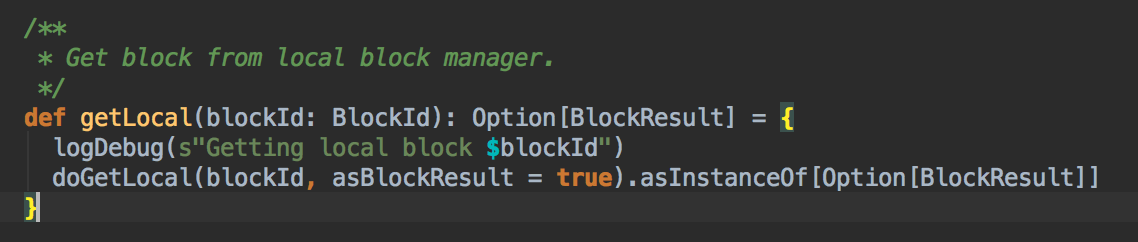
- 在第5步调用了 getLocal 方法后转过调用了 doGetLocal
[下图是 BlockManager.scala 的 doGetLocal 方法]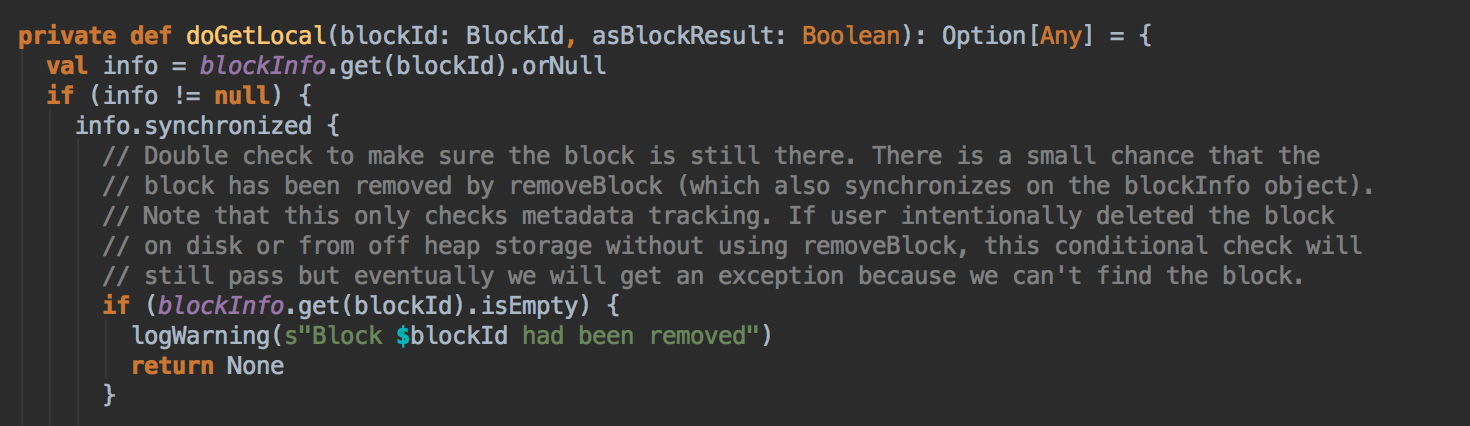

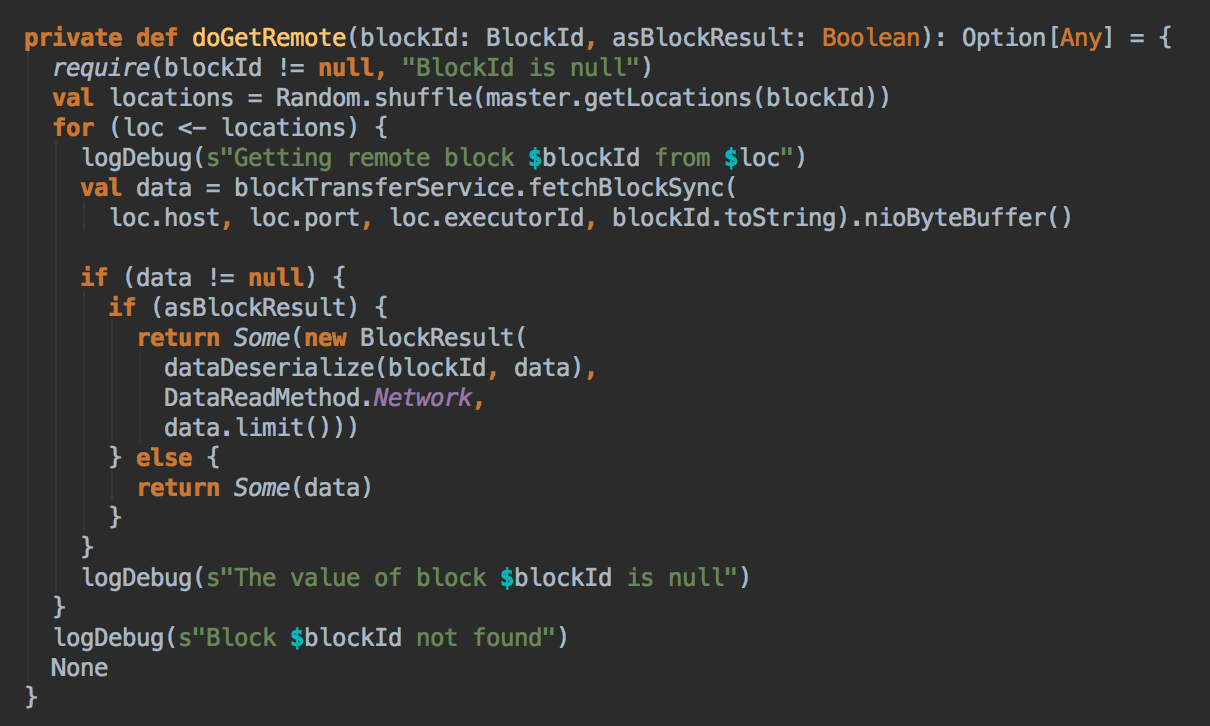
- 在第5步中如果本地没有缓存的话就调用 getRemote 方法从远程抓取数据
[下图是 BlockManager.scala 的 getRemote 方法]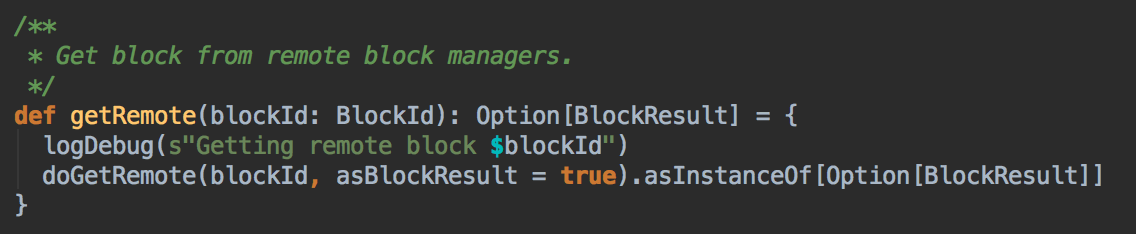
- 如果 CacheManager 没有通过 BlockManager 获得缓存内容的话,其实会通过 RDD 的 computeOrReadCheckpoint 方法来获得数据。
[下图是 RDD.scala 的 computeOrReadChcekpoint 方法]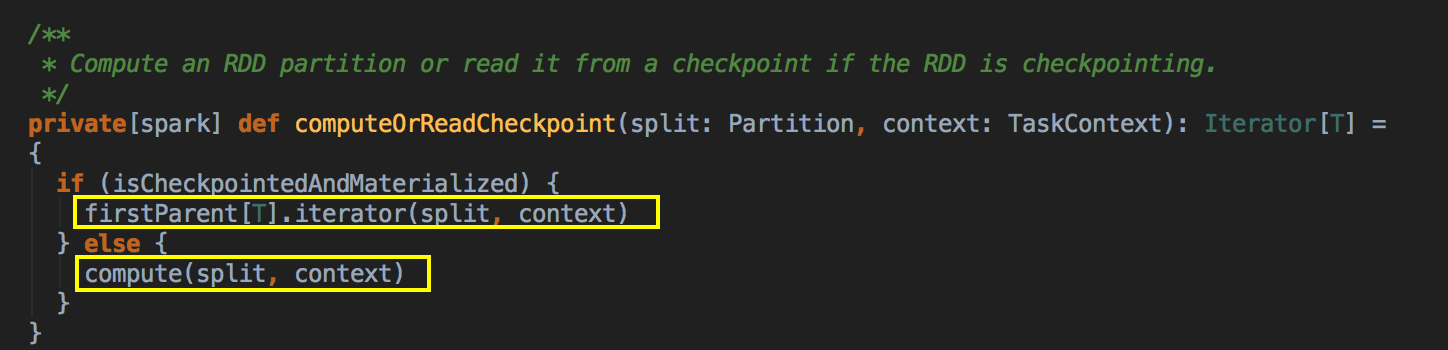
上述首先检查看当前的 RDD 是否进行了 Checkpoint ,如果进行了话就直接读取 checkpoint 的数据,否则的话就必需进行计算; Checkpoint 本身很重要;计算之后通过 putInBlockManager 会把数据按照 StorageLevel 重新缓存起来。
[下图是 CacheManager.scala 的 putInBlockManager 方法]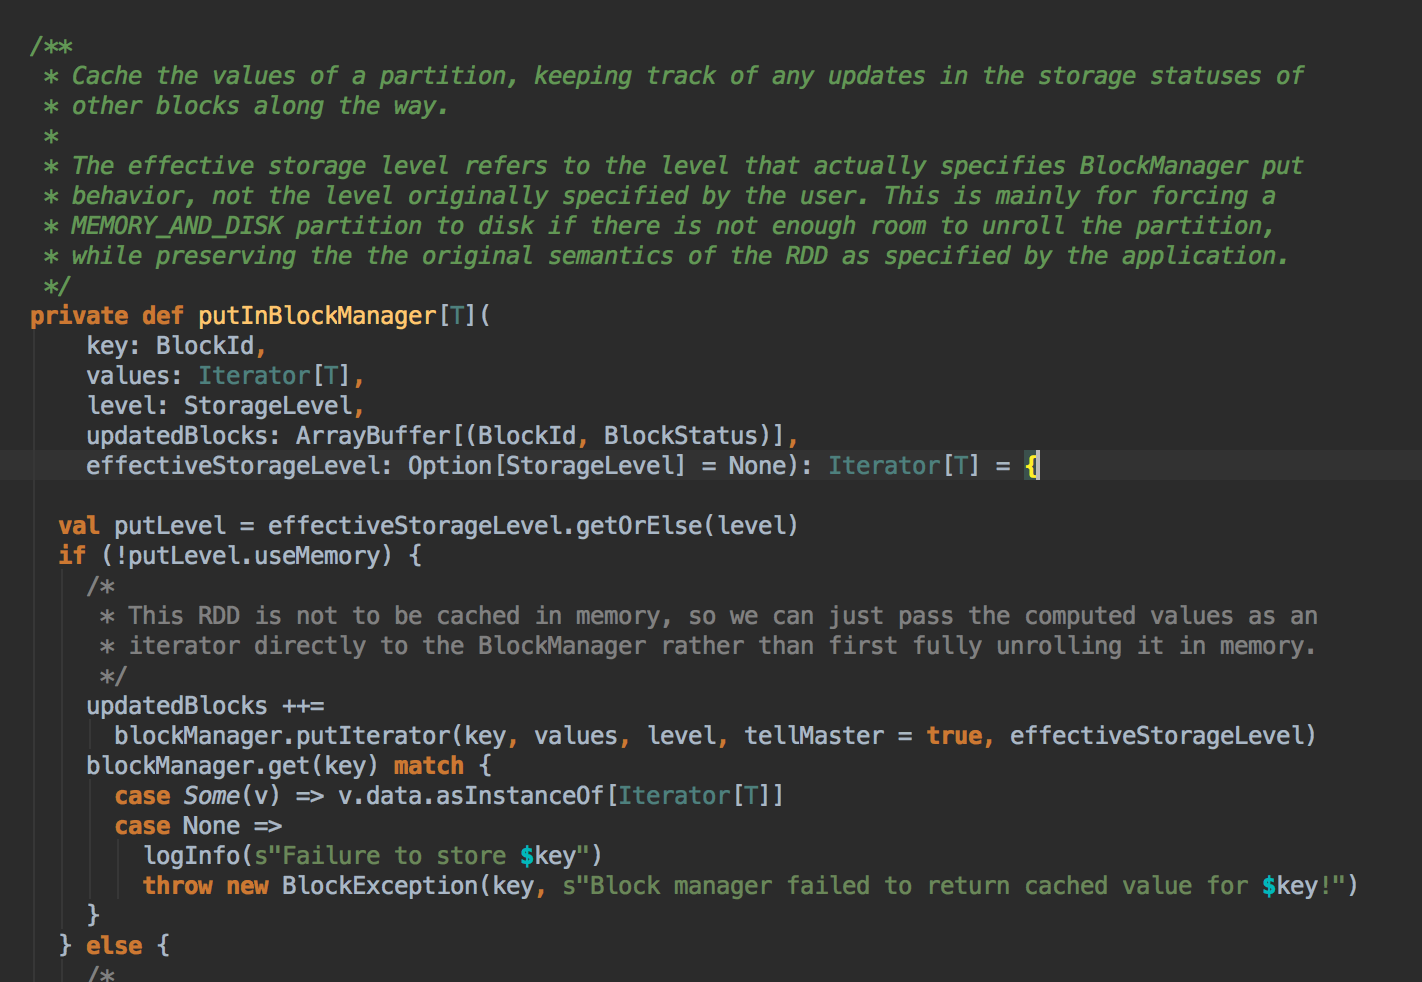

- 你如果把数据缓存在内存中,你需要注意的是内存空间够不够,此时会调用 memoryStore 中的 unrollSafety 方法,里面有一个循环在内存中放数据。
[下图是 MemoryStore.scala 中的 unrollSafely 方法]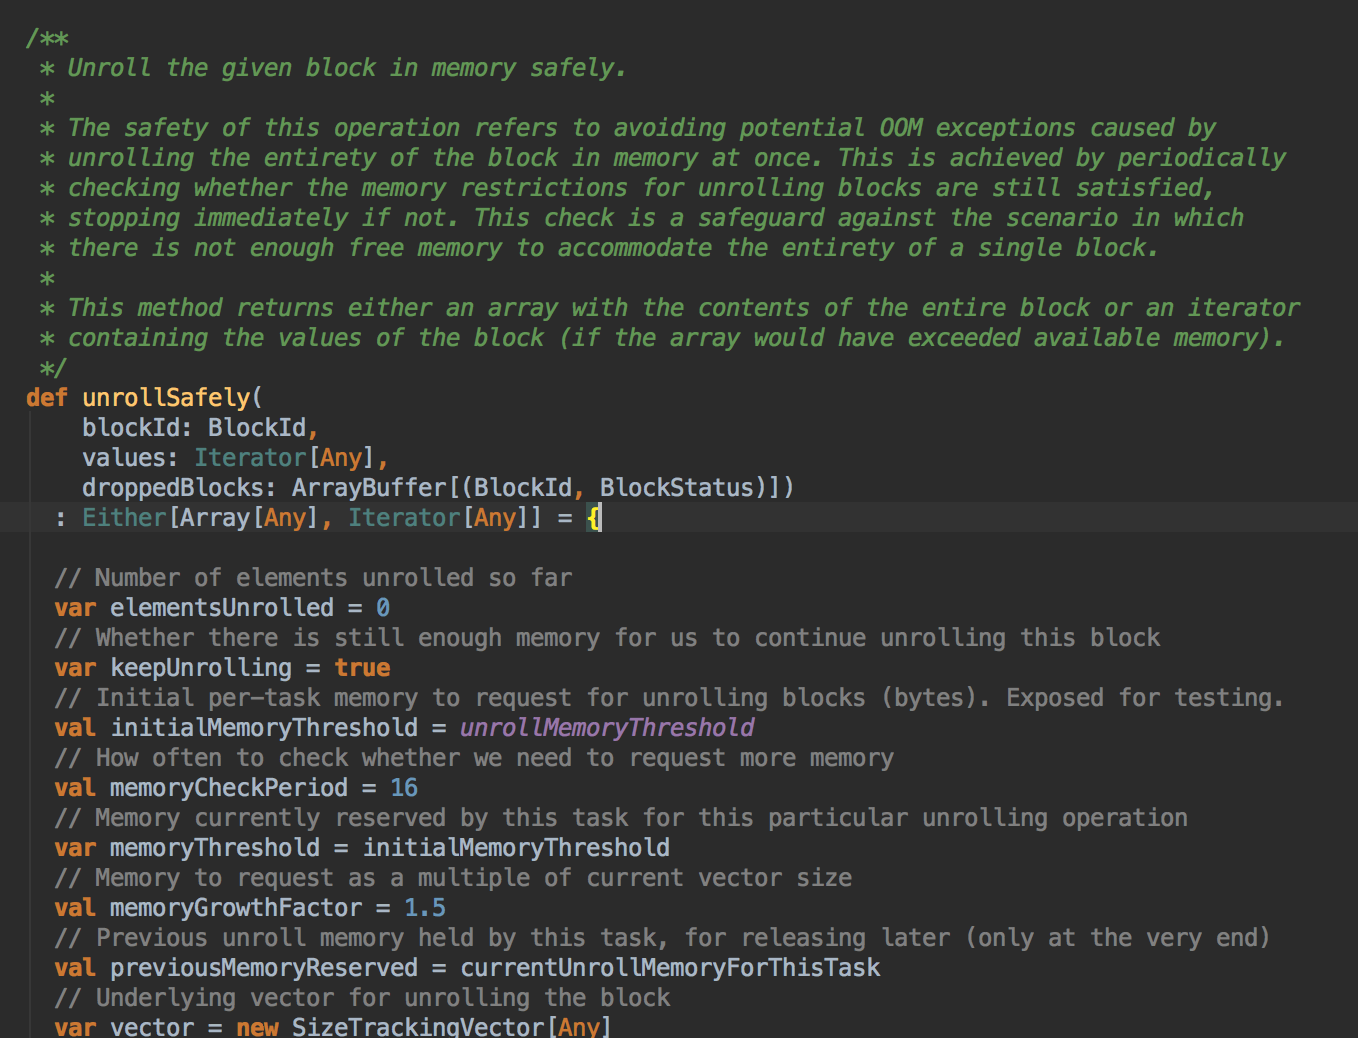
參考資料
资料来源来至 DT大数据梦工厂 大数据传奇行动 第40课:CacheManager彻底解密:CacheManager运行原理流程图和源码详解
Spark源码图片取自于 Spark 1.6.0版本
[Spark内核] 第40课:CacheManager彻底解密:CacheManager运行原理流程图和源码详解的更多相关文章
- Spark Sort-Based Shuffle具体实现内幕和源码详解
为什么讲解Sorted-Based shuffle?2方面的原因:一,可能有些朋友看到Sorted-Based Shuffle的时候,会有一个误解,认为Spark基于Sorted-Based Shuf ...
- [Spark内核] 第36课:TaskScheduler内幕天机解密:Spark shell案例运行日志详解、TaskScheduler和SchedulerBackend、FIFO与FAIR、Task运行时本地性算法详解等
本課主題 通过 Spark-shell 窥探程序运行时的状况 TaskScheduler 与 SchedulerBackend 之间的关系 FIFO 与 FAIR 两种调度模式彻底解密 Task 数据 ...
- [Spark内核] 第38课:BlockManager架构原理、运行流程图和源码解密
本课主题 BlockManager 运行實例 BlockManager 原理流程图 BlockManager 源码解析 引言 BlockManager 是管理整个Spark运行时的数据读写的,当然也包 ...
- Spark Streaming揭秘 Day25 StreamingContext和JobScheduler启动源码详解
Spark Streaming揭秘 Day25 StreamingContext和JobScheduler启动源码详解 今天主要理一下StreamingContext的启动过程,其中最为重要的就是Jo ...
- [转]Linux内核源码详解--iostat
Linux内核源码详解——命令篇之iostat 转自:http://www.cnblogs.com/york-hust/p/4846497.html 本文主要分析了Linux的iostat命令的源码, ...
- [Spark内核] 第32课:Spark Worker原理和源码剖析解密:Worker工作流程图、Worker启动Driver源码解密、Worker启动Executor源码解密等
本課主題 Spark Worker 原理 Worker 启动 Driver 源码鉴赏 Worker 启动 Executor 源码鉴赏 Worker 与 Master 的交互关系 [引言部份:你希望读者 ...
- [Spark内核] 第29课:Master HA彻底解密
本课主题 Master HA 解析 Master HA 解析源码分享 [引言部份:你希望读者看完这篇博客后有那些启发.学到什么样的知识点] 更新中...... Master HA 解析 生产环境下一般 ...
- [Spark内核] 第37课:Task执行内幕与结果处理解密
本课主题 Task执行内幕与结果处理解密 引言 这一章我们主要关心的是 Task 是怎样被计算的以及结果是怎么被处理的 了解 Task 是怎样被计算的以及结果是怎么被处理的 Task 执行原理流程图 ...
- Linux内核源码详解——命令篇之iostat[zz]
本文主要分析了Linux的iostat命令的源码,iostat的主要功能见博客:性能测试进阶指南——基础篇之磁盘IO iostat源码共563行,应该算是Linux系统命令代码比较少的了.源代码中主要 ...
随机推荐
- 约瑟夫问题 小孩报数问题poj3750
小孩报数问题 Time Limit: 1000MS Memory Limit: 65536K Total Submissions: 15228 Accepted: 6778 Descripti ...
- HDU 2298 Toxophily(公式/三分+二分)
Toxophily Time Limit: 3000/1000 MS (Java/Others) Memory Limit: 32768/32768 K (Java/Others) Total ...
- myeclipse配置SVN插件
方法一:link安装 安装subclipse, MyEclipse SVN插件 1.从官网下载最新的site-1.x.x.zip文件,网址是:folderID=2240" target= ...
- EJB:快速入门
1.EJB概念 2.EJB体系结构 3.SessionBean 3.1 SessionBean 服务端组件 3.2 Remote 与 Local 模式 3.3 Client访问处理流程 3.3.1 R ...
- springboot学习笔记-4 整合Druid数据源和使用@Cache简化redis配置
一.整合Druid数据源 Druid是一个关系型数据库连接池,是阿里巴巴的一个开源项目,Druid在监控,可扩展性,稳定性和性能方面具有比较明显的优势.通过Druid提供的监控功能,可以实时观察数据库 ...
- Intellij IDEA中使用Protobuf的正确姿势
一..proto文件语法高亮显示 需要安装Protobuf Support插件 依次点击Intellij中的"File"-->"Settings"--&g ...
- 【Jenkins】Jenkins权威指南英文版:jenkins-the-definitive-guide.pdf
原文链接:http://www.bogotobogo.com/DevOps/Jenkins/images/Intro_install/jenkins-the-definitive-guide.pdf
- Mac和Xcode常用的快捷键
Mac电脑一般都不怎么用鼠标,因此除了触摸屏的各种双指.三指甚至四指的操作之外,快捷键的使用可以带来非常大的便利,本文则主要收集整理了自己在Mac常规和Xcode开发过程中常用的一些快捷键. 一.Ma ...
- 谷歌浏览器插件-jsonView插件安装与使用
本文转载:http://www.bubuko.com/infodetail-700647.html 1 安装 1.打开 https://github.com : 2.搜索 jsonView 链接:ht ...
- Kotlin——最详细的数据类、密封类详解
在前面几个章节章节中,详细的讲解了Koltin中的接口类(Interface).枚举类(Enmu),还不甚了解的可以查看我的上一篇文章Kotlin--接口类.枚举类详解.当然,在Koltin中,除了接 ...