
66、Spark Streaming:数据处理原理剖析与源码分析(block与batch关系透彻解析)
一、数据处理原理剖析
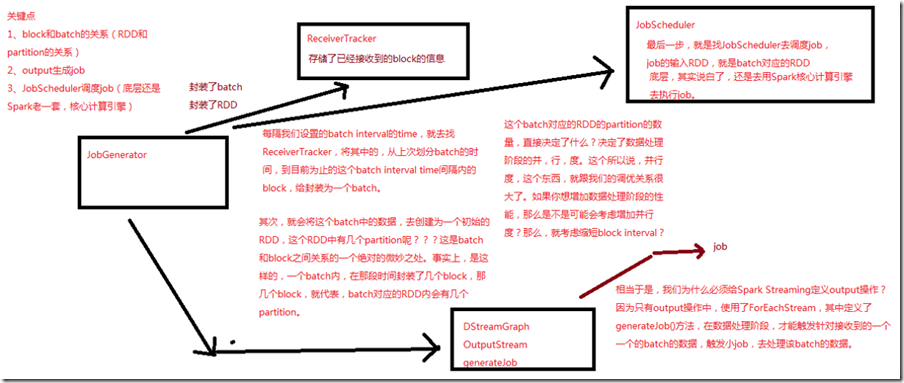
每隔我们设置的batch interval 的time,就去找ReceiverTracker,将其中的,从上次划分batch的时间,到目前为止的这个batch interval time间隔内的block封装为一个batch;

其次,会将这个batch中的数据,去创建为一个初始的RDD,一个batch内,在这段时间封装了几个block,就代表这个batch对应的RDD内会有几个partition;

这个batch对应的RDD的partition决定了数据处理阶段的并行度,这个跟调优关系很大,如果想增加数据处理阶段的性能,就考虑增加并行度,那么就考虑缩短block interval;

只有output操作中,使用了ForEachStream,其中定义了generatorJob()方法,在数据处理阶段,才触发针对接收到的一个一个batch的数据,触发小的job,去处理该batch的数据;

最后一步,去找JobScheduler去调度job,job的输入RDD,就是batch对应的RDD;
二、源码分析
入口,JobGenerator的generateJobs()方法
###org.apache.spark.streaming.scheduler/JobGenerator.scala

 /**

    * 定时,调度generateJobs()方法,传入一个time,其实就是一个batch interval内的时间段

    */

  private def generateJobs(time: Time) {

    // Set the SparkEnv in this thread, so that job generation code can access the environment

    // Example: BlockRDDs are created in this thread, and it needs to access BlockManager

    // Update: This is probably redundant after threadlocal stuff in SparkEnv has been removed.

    SparkEnv.set(ssc.env)

    Try {

      // 找到ReceiverTracker,调用其allocateBlocksToBatch方法,将当前时间段内的block分配给一个batch,并为其

      // 创建一个RDD

      jobScheduler.receiverTracker.allocateBlocksToBatch(time) // allocate received blocks to batch

      // 调用DSteamGraph的generateJobs()来根据程序定义的DSteam之间的依赖关系和算子,生成job

      graph.generateJobs(time) // generate jobs using allocated block

    } match {

        // 如果成功创建了job

      case Success(jobs) =>

        // 从ReceiverTracker中,获取当前batch interval对应的block数据

        val receivedBlockInfos =

          jobScheduler.receiverTracker.getBlocksOfBatch(time).mapValues { _.toArray }

        // 用jobScheduler提交job,其对应的原始数据,是那批block

        jobScheduler.submitJobSet(JobSet(time, jobs, receivedBlockInfos))

      case Failure(e) =>

        jobScheduler.reportError("Error generating jobs for time " + time, e)

    }

    eventActor ! DoCheckpoint(time)

  }
66、Spark Streaming:数据处理原理剖析与源码分析(block与batch关系透彻解析)的更多相关文章
- 65、Spark Streaming:数据接收原理剖析与源码分析
一.数据接收原理 二.源码分析 入口包org.apache.spark.streaming.receiver下ReceiverSupervisorImpl类的onStart()方法 ### overr ...
- 64、Spark Streaming:StreamingContext初始化与Receiver启动原理剖析与源码分析
一.StreamingContext源码分析 ###入口 org.apache.spark.streaming/StreamingContext.scala /** * 在创建和完成StreamCon ...
- 18、TaskScheduler原理剖析与源码分析
一.源码分析 ###入口 ###org.apache.spark.scheduler/DAGScheduler.scala // 最后,针对stage的task,创建TaskSet对象,调用taskS ...
- 22、BlockManager原理剖析与源码分析
一.原理 1.图解 Driver上,有BlockManagerMaster,它的功能,就是负责对各个节点上的BlockManager内部管理的数据的元数据进行维护, 比如Block的增删改等操作,都会 ...
- 21、Shuffle原理剖析与源码分析
一.普通shuffle原理 1.图解 假设有一个节点上面运行了4个 ShuffleMapTask,然后这个节点上只有2个 cpu core.假如有另外一台节点,上面也运行了4个ResultTask,现 ...
- 20、Task原理剖析与源码分析
一.Task原理 1.图解 二.源码分析 1. ###org.apache.spark.executor/Executor.scala /** * 从TaskRunner开始,来看Task的运行的工作 ...
- 19、Executor原理剖析与源码分析
一.原理图解 二.源码分析 1.Executor注册机制 worker中为Application启动的executor,实际上是启动了这个CoarseGrainedExecutorBackend进程: ...
- 23、CacheManager原理剖析与源码分析
一.图解 二.源码分析 ###org.apache.spark.rdd/RDD.scalal ###入口 final def iterator(split: Partition, context: T ...
- 16、job触发流程原理剖析与源码分析
一.以Wordcount为例来分析 1.Wordcount val lines = sc.textFile() val words = lines.flatMap(line => line.sp ...
随机推荐
- node-red inject节点 debug节点 switch节点
inject节点: https://blog.csdn.net/geek_monkey/article/details/80737818 debug节点: https://blog.csdn.net/ ...
- Python进阶----粘包,解决粘包(旗舰版)
Python进阶----粘包,解决粘包(旗舰版) 一丶粘包 只有TCP有粘包现象,UDP永远不会粘包 什么是粘包 存在于客户端接收数据时,不能一次性收取全部缓冲区中的数据.当下一次再有数据来时 ...
- 1+X证书学习日志——javascript基础
js javascript js的组成: ECMAscript DOM BOM js放置的位置 <script></script> <script src="路 ...
- Linux-存储服务之NFS
NFS介绍 官方文档 NFS(Network File System)即网络文件系统,它最大的功能就是通过TCP/IP网络共享资源.在NFS的应用中,本地NFS的客户端应用可以透明地读写位于远端NFS ...
- 原生ajax解析&封装原生ajax函数
前沿:对于此篇随笔,完是简要写了几个重要的地方,具体实现细节完在提供的源码做了笔记 <一>ajax基本要点介绍--更好的介绍ajax 1. ajax对象中new XMLHttpReques ...
- python中str和byte的相互转化
在涉及到网络传输的时候,数据需要从str转换成btye才能进行传输. python byte 转 str , str 转 byte 其实很简单:原理图如下:在这里插入图片描述案例: a: str = ...
- HRBUST 2040 二叉树的遍历
给出一棵二叉树的中序和前序遍历,输出它的后序遍历. Input 本题有多组数据,输入处理到文件结束. 每组数据的第一行包括一个整数n,表示这棵二叉树一共有n个节点. 接下来的一行每行包括n个整数,表示 ...
- Caused by: org.hibernate.id.IdentifierGenerationException: ids for this class must be manually assigned before calling save(): com.qingmu.seller.entity.OrderMaster
org.springframework.orm.jpa.JpaSystemException: ids for this class must be manually assigned before ...
- 《逆袭团队》第九次团队作业【Beta】Scrum Meeting 1
项目 内容 软件工程 任课教师博客主页链接 作业链接地址 团队作业9:Beta冲刺与团队项目验收 团队名称 逆袭团队 具体目标 (1)掌握软件黑盒测试技术:(2)学会编制软件项目总结PPT.项目验收报 ...
- 编程小白入门分享三:Spring AOP统一异常处理
Spring AOP统一异常处理 简介 在Controller层,Service层,可能会有很多的try catch代码块.这将会严重影响代码的可读性."美观性".怎样才可以把更多 ...