
scrapy框架爬取糗妹妹网站妹子图分类的所有图片
爬取所有图片,一个页面的图片建一个文件夹。难点,图片中有不少.gif图片,需要重写下载规则,
创建scrapy项目
scrapy startproject qiumeimei
创建爬虫应用
cd qiumeimei

scrapy genspider -t crawl qmm www.xxx.com
items.py文件中定义下载字段
import scrapy

class QiumeimeiItem(scrapy.Item):

    # define the fields for your item here like:

    # name = scrapy.Field()

    page = scrapy.Field()

    image_url = scrapy.Field()
qmm.py文件中写爬虫主程序
import scrapy

from scrapy.linkextractors import LinkExtractor

from scrapy.spiders import CrawlSpider, Rule

from qiumeimei.items import QiumeimeiItem

class QmmSpider(CrawlSpider):

    name = 'qmm'

    # allowed_domains = ['www.xxx.com']

    start_urls = ['http://www.qiumeimei.com/image']

    rules = (

        Rule(LinkExtractor(allow=r'http://www.qiumeimei.com/image/page/\d+'), callback='parse_item', follow=True),

    )

    def parse_item(self, response):

        page = response.url.split('/')[-1]

        if not page.isdigit():

            page = ''

        image_urls = response.xpath('//div[@class="main"]/p/img/@data-lazy-src').extract()

        for image_url in image_urls:

            item = QiumeimeiItem()

            item['image_url'] = image_url

            item['page'] = page

            yield item
pipelines.py文件中定义下载规则
import scrapy

import os

from scrapy.utils.misc import md5sum

# 导入scrapy 框架里的 管道文件的里的图像 图像处理的专用管道文件

from scrapy.pipelines.images import ImagesPipeline

# 导入图片路径名称

from qiumeimei.settings import IMAGES_STORE as images_store

# 必须继承 ImagesPipeline

class QiumeimeiPipeline(ImagesPipeline):

    # 定义返回文件名

    def file_path(self, request, response=None, info=None):

        file_name = request.url.split('/')[-1]

        return file_name

    # 重写父类的 下载文件的 方法

    def get_media_requests(self, item, info):

        yield scrapy.Request(url=item['image_url'])

    #     完成图片存储的方法 名称

    def item_completed(self, results, item, info):

        # print(results)

        page = item['page']

        print('正在下载第'+page+'页图片')

        image_url = item['image_url']

        image_name = image_url.split('/')[-1]

        old_name_list = [x['path'] for t, x in results if t]

        # 真正的原图片的存储路径

        old_name = images_store + old_name_list[0]

        image_path = images_store + page + "/"

        # 判断图片存放的目录是否存在

        if not os.path.exists(image_path):

            # 根据当前页码创建对应的目录

            os.mkdir(image_path)

        # 新名称

        new_name = image_path + image_name

        # 重命名

        os.rename(old_name, new_name)

        return item

    # 重写下载规则

    def image_downloaded(self, response, request, info):

        checksum = None

        for path, image, buf in self.get_images(response, request, info):

            if checksum is None:

                buf.seek(0)

                checksum = md5sum(buf)

            width, height = image.size

            if self.check_gif(image):

                self.persist_gif(path, response.body, info)

            else:

                self.store.persist_file(

                    path, buf, info,

                    meta={'width': width, 'height': height},

                    headers={'Content-Type': 'image/jpeg'})

        return checksum

    def check_gif(self, image):

        if image.format is None:

            return True

    def persist_gif(self, key, data, info):

        root, ext = os.path.splitext(key)

        absolute_path = self.store._get_filesystem_path(key)

        self.store._mkdir(os.path.dirname(absolute_path), info)

        f = open(absolute_path, 'wb')  # use 'b' to write binary data.

        f.write(data)
settings.py文件中定义请求头和打开下载管道
USER_AGENT = 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/39.0.2171.71 Safari/537.36'

ITEM_PIPELINES = {

   'qiumeimei.pipelines.QiumeimeiPipeline': 300,

}
运行爬虫
scrapy crawl qmm --nolog
查看文件夹是否下载成功
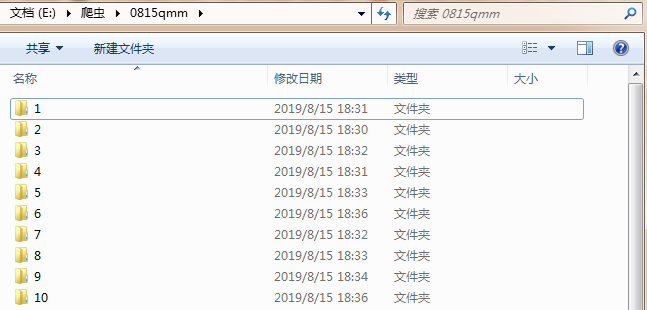
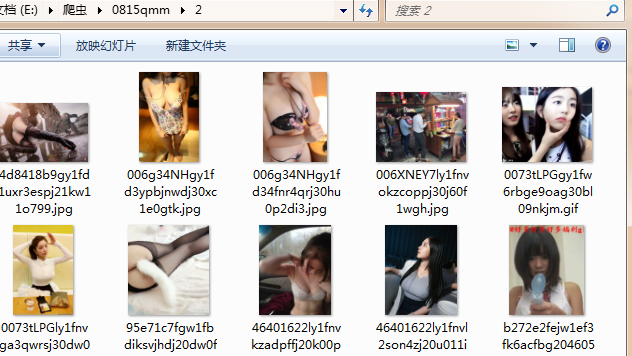

.gif为动态图。
done。

scrapy框架爬取糗妹妹网站妹子图分类的所有图片的更多相关文章
- python爬虫scrapy框架——爬取伯乐在线网站文章
一.前言 1. scrapy依赖包: 二.创建工程 1. 创建scrapy工程: scrapy staratproject ArticleSpider 2. 开始(创建)新的爬虫: cd Artic ...
- 使用scrapy框架爬取自己的博文(2)
之前写了一篇用scrapy框架爬取自己博文的博客,后来发现对于中文的处理一直有问题- - 显示的时候 [u'python\u4e0b\u722c\u67d0\u4e2a\u7f51\u9875\u76 ...
- (java)selenium webdriver爬虫学习--爬取阿里指数网站的每个分类的top50 相关数据;
主题:java 爬虫--爬取'阿里指数'网站的每个分类的top50 相关数据: 网站网址为:http://index.1688.com/alizs/top.htm?curType=offer& ...
- 爬虫入门(四)——Scrapy框架入门:使用Scrapy框架爬取全书网小说数据
为了入门scrapy框架,昨天写了一个爬取静态小说网站的小程序 下面我们尝试爬取全书网中网游动漫类小说的书籍信息. 一.准备阶段 明确一下爬虫页面分析的思路: 对于书籍列表页:我们需要知道打开单本书籍 ...
- scrapy框架爬取笔趣阁完整版
继续上一篇,这一次的爬取了小说内容 pipelines.py import csv class ScrapytestPipeline(object): # 爬虫文件中提取数据的方法每yield一次it ...
- scrapy框架爬取笔趣阁
笔趣阁是很好爬的网站了,这里简单爬取了全部小说链接和每本的全部章节链接,还想爬取章节内容在biquge.py里在加一个爬取循环,在pipelines.py添加保存函数即可 1 创建一个scrapy项目 ...
- scrapy框架爬取妹子图片
首先,建立一个项目#可在github账户下载完整代码:https://github.com/connordb/scrapy-jiandan2 scrapy startproject jiandan2 ...
- scrapy框架爬取智联招聘网站上深圳地区python岗位信息。
爬取字段,公司名称,职位名称,公司详情的链接,薪资待遇,要求的工作经验年限 1,items中定义爬取字段 import scrapy class ZhilianzhaopinItem(scrapy.I ...
- Python Scrapy 爬取煎蛋网妹子图实例(一)
前面介绍了爬虫框架的一个实例,那个比较简单,这里在介绍一个实例 爬取 煎蛋网 妹子图,遗憾的是 上周煎蛋网还有妹子图了,但是这周妹子图变成了 随手拍, 不过没关系,我们爬图的目的是为了加强实战应用,管 ...
随机推荐
- 大数据 -- Hadoop集群环境搭建
首先我们来认识一下HDFS, HDFS(Hadoop Distributed File System )Hadoop分布式文件系统.它其实是将一个大文件分成若干块保存在不同服务器的多个节点中.通过联网 ...
- 隐马尔科夫模型的Python3实现代码
下面给出计算隐马尔科夫模型的编程代码: from hmmlearn.hmm import GaussianHMM import datetime import numpy as np from mat ...
- C#.NET XML 与 实体 MODEL 互转,非序列化
只能处理简单结构XML 和 实体. using System.Text; using System.Xml; namespace A.Util { public static class MyXmlU ...
- aix如何将history输出所有命令导出到文本文件
more .sh_history cat .sh_history > mylogfile.txt
- 容器服务如何在企业客户落地?Rancher 解决之道分享
Docker 的优势和趋势我想不必再赘述,那么对于非互联网公司的传统企业客户,以及我们大量的围绕企业客户做集成.交付解决方案的服务提供商,需要考虑的一个问题就是怎么样把容器技术以高质量.低成本.易维护 ...
- 使用清华源进行pip install
pypi 镜像使用帮助 pypi 镜像每 5 分钟同步一次. 临时使用 pip install -i https://pypi.tuna.tsinghua.edu.cn/simple some-pac ...
- 在ensp上配置基于接口地址池的DHCP
原理 实验模拟 实验拓扑 相关参数 开启dhcp服务 开启接口的dhcp服务功能,指定从接口地址池分配(接口1一样) 配置接口DHCP服务租期(租期默认是一天) 设置保留地址 设置dns 我们在pc1 ...
- [转帖](区块链补习班)ERC20很多人都听过,但ERC是什么你真的了解吗?
(区块链补习班)ERC20很多人都听过,但ERC是什么你真的了解吗? http://baijiahao.baidu.com/s?id=1600948969290990883&wfr=spide ...
- 【Python爬虫案例学习】python爬取淘宝里的手机报价并以价格排序
第一步: 先分析这个url,"?"后面的都是它的关键字,requests中get函数的关键字的参数是params,post函数的关键字参数是data, 关键字用字典的形式传进去,这 ...
- SQL语句报错:You have an error in your SQL syntax; check the manual that corresponds to your MariaDB server version for the right syntax to use near
报错如图: 最开始其实我的列名tname和tsubject分别叫name和subject,后来看到网上有说这个报错可能是数据库建表的时候使用了mysql的关键词,我就只把name改了.后来还是这个问题 ...