
scrapy框架爬取智联招聘网站上深圳地区python岗位信息。
爬取字段,公司名称,职位名称,公司详情的链接,薪资待遇,要求的工作经验年限
1,items中定义爬取字段
import scrapy

class ZhilianzhaopinItem(scrapy.Item):

    # define the fields for your item here like:

    # name = scrapy.Field()

    company_name = scrapy.Field()

    jobName = scrapy.Field()

    company_url = scrapy.Field()

    salary = scrapy.Field()

    workingExp = scrapy.Field()
2,主程序函数
# -*- coding: utf-8 -*-

import scrapy

from urllib.parse import urlencode

import json

import math

from zhilianzhaopin.items import ZhilianzhaopinItem

class ZlzpSpider(scrapy.Spider):

    name = 'zlzp'

    # allowed_domains = ['www.zhaopin.com']

    start_urls = ['https://fe-api.zhaopin.com/c/i/sou?']

    data = {

        'start': '',

        'pageSize': '',

        'cityId': '',

        'kw': 'python',

        'kt': ''

    }

    def start_requests(self):

        url = self.start_urls[0]+urlencode(self.data)

        yield scrapy.Request(url=url,callback=self.parse)

    def parse(self, response):

        response = json.loads(response.text)

        sum = int(response['data']['count'])

        for res in response['data']['results']:

            item = ZhilianzhaopinItem()

            item['company_name'] = res['company']['name']

            item['jobName'] = res['jobName']

            item['company_url'] = res['company']['url']

            item['salary'] = res['salary']

            item['workingExp'] = res['workingExp']['name']

            yield item

        for url_info in range(90,sum,90):

            self.data['start'] = str(url_info)

            url_i = self.start_urls[0]+urlencode(self.data)

            yield scrapy.Request(url=url_i,callback=self.parse)
3,settings中设置请求头和打开下载管道
USER_AGENT = 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/39.0.2171.71 Safari/537.36'

ITEM_PIPELINES = {

   'zhilianzhaopin.pipelines.ZhilianzhaopinPipeline': 300,

}
4,创建数据库,
5,pipelines.py文件中写入数据库
import pymysql

# 写入mysql数据库

class ZhilianzhaopinPipeline(object):

    conn = None

    mycursor = None

    def open_spider(self, spider):

        print('链接数据库...')

        self.conn = pymysql.connect(host='172.16.25.4', user='root', password='root', db='scrapy')

        self.mycursor = self.conn.cursor()

    def process_item(self, item, spider):

        print('正在写数据库...')

        company_name = item['company_name']

        jobName = item['jobName']

        company_url = item['company_url']

        salary = item['salary']

        workingExp = item['workingExp']

        sql = 'insert into zlzp VALUES (null,"%s","%s","%s","%s","%s")' % (company_name, jobName, company_url,salary,workingExp)

        bool = self.mycursor.execute(sql)

        self.conn.commit()

        return item

    def close_spider(self, spider):

        print('写入数据库完成...')

        self.mycursor.close()

        self.conn.close()
6,查看是否写入成功
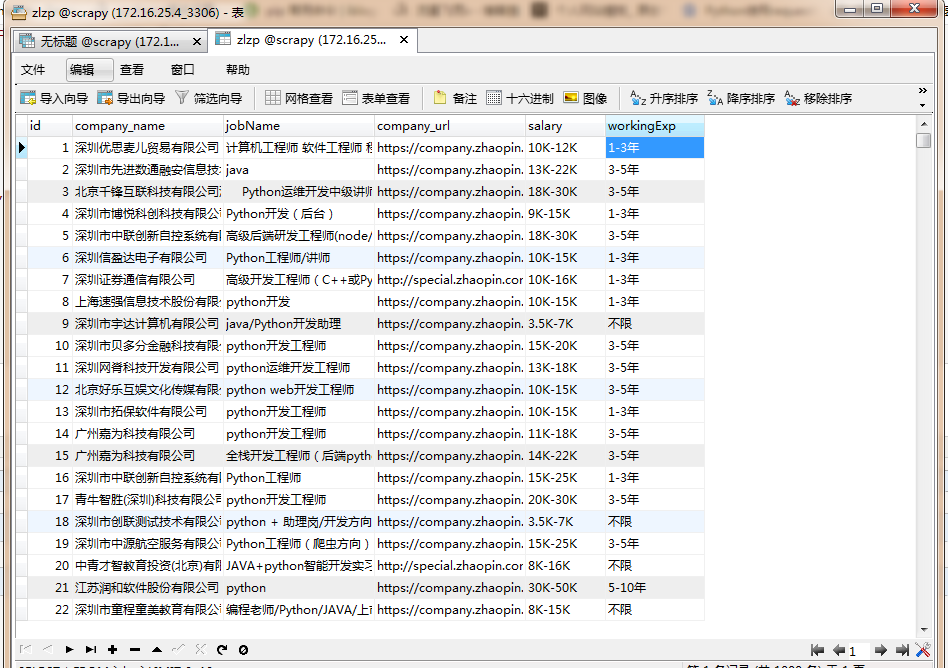
done。
scrapy框架爬取智联招聘网站上深圳地区python岗位信息。的更多相关文章
- 用Python爬取智联招聘信息做职业规划
上学期在实验室发表时写了一个爬取智联招牌信息的爬虫. 操作流程大致分为:信息爬取——数据结构化——存入数据库——所需技能等分词统计——数据可视化 1.数据爬取 job = "通信工程师&qu ...
- scrapy项目2:爬取智联招聘的金融类高端岗位(spider类)
---恢复内容开始--- 今天我们来爬取一下智联招聘上金融行业薪酬在50-100万的职位. 第一步:解析解析网页 当我们依次点击下边的索引页面是,发现url的规律如下: 第1页:http://www. ...
- node.js 89行爬虫爬取智联招聘信息
写在前面的话, .......写个P,直接上效果图.附上源码地址 github/lonhon ok,正文开始,先列出用到的和require的东西: node.js,这个是必须的 request,然发 ...
- 用生产者消费模型爬取智联招聘python岗位信息
爬取python岗位智联招聘 这里爬取北京地区岗位招聘python岗位,并存入EXECEL文件内,代码如下: import json import xlwt import requests from ...
- Python+selenium爬取智联招聘的职位信息
整个爬虫是基于selenium和Python来运行的,运行需要的包 mysql,matplotlib,selenium 需要安装selenium火狐浏览器驱动,百度的搜寻. 整个爬虫是模块化组织的,不 ...
- python爬取智联招聘职位信息(多进程)
测试了下,采用单进程爬取5000条数据大概需要22分钟,速度太慢了点.我们把脚本改进下,采用多进程. 首先获取所有要爬取的URL,在这里不建议使用集合,字典或列表的数据类型来保存这些URL,因为数据量 ...
- python爬取智联招聘职位信息(单进程)
我们先通过百度搜索智联招聘,进入智联招聘官网,一看,傻眼了,需要登录才能查看招聘信息 没办法,用账号登录进去,登录后的网页如下: 输入职位名称点击搜索,显示如下网页: 把这个URL:https://s ...
- scrapy 爬取智联招聘
准备工作 1. scrapy startproject Jobs 2. cd Jobs 3. scrapy genspider ZhaopinSpider www.zhaopin.com 4. scr ...
- 『Scrapy』爬取腾讯招聘网站
分析爬取对象 初始网址, http://hr.tencent.com/position.php?@start=0&start=0#a (可选)由于含有多页数据,我们可以查看一下这些网址有什么相 ...
随机推荐
- Tensorflow不同版本要求与CUDA及CUDNN版本对应关系
参考官网地址: Windows端:https://tensorflow.google.cn/install/source_windows CPUVersion Python version Compi ...
- ETF计算公式:IOPV
IOPV=(申购.赎回清单中必须现金替代的替代金额+申购.赎回清单中退补现金替代成份证券的数量与最新成交价相乘之和+申购.赎回清单中可以现金替代成份证券的数量与最新成交价相乘之和+申购.赎回清单中禁止 ...
- Node 脚本的调试工具
2016年,Node 决定将 Chrome 浏览器的"开发者工具"作为官方的调试工具,使得 Node 脚本也可以使用图形界面调试 1.准备 创建目录 D:\nodejs>mk ...
- Maven依赖中scope的含义
https://www.jianshu.com/p/7145f01ac3ad Maven依赖中scope的含义 整理一下Maven中Scope的详细作用,都是抄的别人内容整理了一下.参考: https ...
- java 调用Spring接口上传文件及其他参数填充
第一步:在Spring配置中添加以下内容 <!-- 配置MultipartResolver 用于文件上传 使用spring的CommosMultipartResolver --> < ...
- Delphi百度文字识别【支持通用文字识别、身份证识别、银行卡识别、驾驶证识别、行驶证识别、车牌识别等功能】
作者QQ:(648437169) 点击下载➨Delphi百度文字识别 百度api文档 [Delphi百度文字识别]支持 通用文字识别.通用文字识别(高精度版).通用文字识别(含位置信 ...
- powerful number求积性函数前缀和
算法原理 本文参考了 zzq's blog . \(\text{powerful number}\) 的定义是每个质因子次数都 \(\ge 2\) 的数,有个结论是 \(\ge n\) 的 \(\te ...
- Oracle解决锁表语句与批量生成解锁语句
--以下几个为相关表SELECT * FROM v$lock;SELECT * FROM v$sqlarea;SELECT * FROM v$session;SELECT * FROM v$proce ...
- 微软企业库支持 MySql
微软企业库支持 MySql 三步让企业库支持 mysql 数据库 1.创建 MySqlDatabaseData 类 using Microsoft.Practices.EnterpriseLibr ...
- P1349 广义斐波那契数列(矩阵乘法)
题目 P1349 广义斐波那契数列 解析 把普通的矩阵乘法求斐波那契数列改一改,随便一推就出来了 \[\begin{bmatrix}f_2\\f_1 \end{bmatrix}\begin{bmatr ...